
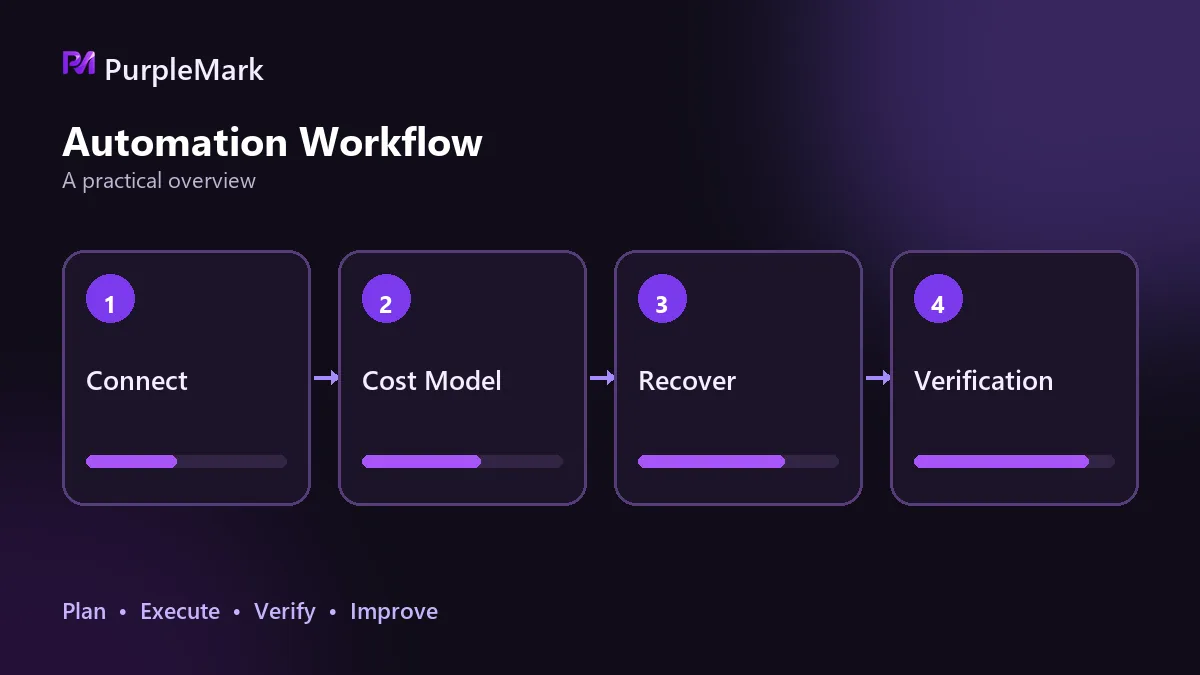
Pełny proces rejestracji konta jasno pokazuje granice: formularze, wybór daty i kody z e-maila można zautomatyzować, ale weryfikacja wideo selfie zatrzymuje proces. Zrozumienie kosztu każdej warstwy jest bardziej realistyczne niż dążenie do pełnej automatyzacji.
Osoby zajmujące się automatyzacją przeglądarki często zaczynają od optymistycznego założenia: jeśli proces podzieli się na wystarczająco małe kroki, wszystko powinno dać się zautomatyzować.
Pełne przejście procesu pokazuje jednak inną rzeczywistość. Początkowe etapy mogą działać zaskakująco sprawnie, a na końcu pojawia się bariera, której nie da się przejść skryptem. Typowy test rejestracji konta wyglądał tak: wypełnianie formularza, wybór daty, pobranie kodu weryfikacyjnego i kontrole bezpieczeństwa zakończyły się w mniej niż minutę. Około 85% procesu zostało zautomatyzowane. Pozostała weryfikacja wideo selfie wymagająca prawdziwej osoby przed kamerą.
Gdy rozłoży się ten proces według kosztów, jego granice stają się znacznie wyraźniejsze.
Deterministyczne działania na jednej stronie są zwykle niezawodne w skryptach
Pola takie jak imię, e-mail, hasło i data urodzenia należą do najbardziej stabilnej warstwy. Symulowane wpisywanie z krótką przerwą między polami zajmuje około pięciu sekund dla całego kroku.
Główną pułapką jest lokalizowanie elementów. Wiele nowoczesnych frontendów tworzy pola bez semantycznego atrybutu name, więc trzeba je wskazywać po indeksie lub strukturze. Nie jest to eleganckie, ale w automatyzacji może być zaskakująco stabilne.
To pierwszy typ zadania: stała struktura strony, jednoznaczna akcja i przewidywalny wynik. W tym obszarze skuteczność skryptów jest zazwyczaj wysoka.
Przy niestandardowych komponentach struktura strony sama staje się kosztem
Listy rozwijane dotyczące daty urodzenia czy płci często pochłaniają najwięcej czasu.
To, co wygląda jak zwykłe menu wyboru, może być niestandardowym komponentem opartym na rolach dostępności. Standardowe metody potrafią kolejno zawodzić: zwykły wybór nie działa, lokalizowanie po etykiecie dostępności też nie, a bezpośrednie kliknięcie elementu również może się nie udać. Stabilna metoda często polega na odtworzeniu pełnej sekwencji człowieka: otwarciu listy, poczekaniu na wyrenderowanie opcji, znalezieniu celu po tekście i kliknięciu.
Kod można napisać w kilkanaście sekund, a debugowanie może zająć godziny. Granica nie zależy tylko od umiejętności technicznych, ale od tego, na ile współpracuje struktura strony. Przy niestandardowych komponentach szybkie porzucenie klasycznej metody często oszczędza najwięcej czasu.
Utrzymywanie stanu między serwisami to moment wyraźnego wzrostu kosztów
Gdy kod weryfikacyjny przychodzi e-mailem, logika jest prosta: otworzyć skrzynkę, znaleźć najnowszą wiadomość, wyodrębnić kod liczbowy i wpisać go. Cały krok trwa około 20 sekund.
Typowy błąd jest prosty: jeśli skrypt odczyta starszy e-mail, kod będzie nieprawidłowy. Trzeba więc wybierać najnowszą wiadomość według czasu.
Po udanej weryfikacji wiele platform przekierowuje do dodatkowej strony kontroli i wysyła kolejny kod. Logikę obsługi można wykorzystać ponownie, ale poprzedniej wartości kodu już nie.
Prawdziwa trudność polega na tym, że występują dwa serwisy i dwie sesje. Stan logowania do poczty musi zostać utrzymany, sesja platformy musi przetrwać między krokami, a adres IP proxy, strefa czasowa i język muszą pasować do środowiska. W ten sposób stopniowo narasta koszt utrzymywania stanu między serwisami. Każdy krok z osobna jest prosty, ale po połączeniu wyraźnie rośnie odsetek błędów.
Skrypt jest tu tylko wykonawcą; nie decyduje, jaką tożsamość widzi witryna. Odcisk urządzenia i zgodność IP ze środowiskiem należą do sygnałów ocenianych przez platformę. Dlatego zespoły obsługujące wiele kont często wydzielają izolację środowiska jako osobną warstwę: każde środowisko ma własny fingerprint i IP. Narzędzia takie jak PurpleMark zapewniają tę warstwę, a skrypt jedynie wykonuje w niej działania.
Zadania wymagające zrozumienia strony są trudne do utrzymania wyłącznie skryptami
W dalszej części procesu zmienia się charakter problemu.
Jeśli tekst lub struktura różnią się zależnie od konta, regionu lub eksperymentu etapowego, selektory zapisane na sztywno zaczynają masowo zawodzić. Są wtedy dwie drogi: dodawać wszystkie możliwe gałęzie do kodu i coraz bardziej utrudniać utrzymanie albo przekazać krok modelowi, który rozumie semantykę strony. Znaczenie komunikatu czy przycisku jest oczywiste dla człowieka, ale dla selektora stanowi szum.
Gdy platforma aktywnie się dostosowuje, czyste skrypty ponownie przestają działać
Łatwo przeoczyć jeszcze jeden koszt: druga strona też się zmienia.
Platformy nie sprawdzają tylko, czy potrafisz wypełnić formularz. Mogą oceniać, czy fingerprint urządzenia wygląda normalnie, czy IP pasuje do środowiska, czy zachowanie przypomina człowieka oraz czy widać oznaki operacji masowych. Jedna aktualizacja kontroli ryzyka może sprawić, że selektory lub wzorce zachowania działające wczoraj wymagają zmian.
Dlatego rozwiązanie oparte wyłącznie na skryptach nigdy nie osiąga ostatecznego stanu „gotowe”. To nie jednorazowy projekt, lecz ciągła praca utrzymaniowa.
Weryfikacja twarzy nie jest wyłącznie problemem technicznym
Ostatni etap wymaga prawdziwej osoby przed kamerą i w tym miejscu automatyzacja się zatrzymuje.
Skrypt może wypełniać formularze, klikać przyciski, czytać e-maile i wpisywać kody, ale nie może legalnie wykonać czynności wymagającej cech biometrycznych konkretnej osoby. Nie chodzi wyłącznie o poziom technologii: celem tej weryfikacji jest potwierdzenie, że przed ekranem siedzi prawdziwy człowiek, co bezpośrednio stoi w sprzeczności z automatyzacją. Rozwiązania deklarujące automatyczne przejście weryfikacji twarzy często wiążą się z fałszowaniem danych biometrycznych i mogą powodować ryzyka zgodności lub prawne znacznie większe niż potencjalna korzyść.
Nawet jeśli dany krok jest technicznie możliwy, nadal obowiązują warunki korzystania z platformy. Wiele platform wyraźnie ogranicza automatyczną rejestrację. To ograniczenie regulaminowe, a nie techniczne.
Wniosek: dobieraj narzędzia warstwami zamiast dążyć do pełnej automatyzacji
Po rozdzieleniu procesu na warstwy wybór staje się jasny:
- Stałe strony i deterministyczne działania powierzaj skryptom; zwykle jest to najtańsze i najbardziej stabilne rozwiązanie.
- Jeśli trzeba utrzymywać logowanie i sesje między serwisami, zarządzaj środowiskiem przeglądarki jako osobną warstwą i nie mieszaj problemów środowiskowych z debugowaniem skryptu.
- Jeśli struktura się zmienia, a następny krok wymaga rozumienia semantycznego, model może być praktyczniejszy niż dokładanie kolejnych gałęzi kodu.
- Jeśli krok wymaga prawdziwej osoby albo jest wyraźnie zakazany przez regulamin, nie wymuszaj automatyzacji end-to-end.
Najpierw przejdź cały proces ręcznie, aby znaleźć nieprzekraczalne punkty, a dopiero potem zdecyduj o skali inwestycji deweloperskiej. Automatyzacja najbardziej opłaca się w powtarzalnych, deterministycznych operacjach, które nie wymagają oceny.


