
Panele boczne AI, przeglądarki sterowane przez agentów, izolacja w chmurze i przeglądarki z zarządzaniem środowiskami rozwiązują różne problemy. Przed wyborem warto ustalić, czy potrzebne jest rozumienie, wykonanie czy orkiestracja na dużą skalę.
Termin „przeglądarka AI” jest dziś używany bardzo szeroko. Przeglądarkę z oknem czatu można nazwać przeglądarką AI, ale tak samo można określić środowisko przeglądarki traktowane przez program jako zasób możliwy do planowania.
Nazwa jest ta sama, ale rozwiązywane problemy znacznie się różnią. Zamiast analizować produkty jeden po drugim, czytelniej jest podzielić je na cztery formy i zobaczyć, co potrafi każda z nich oraz gdzie pojawiają się ograniczenia.
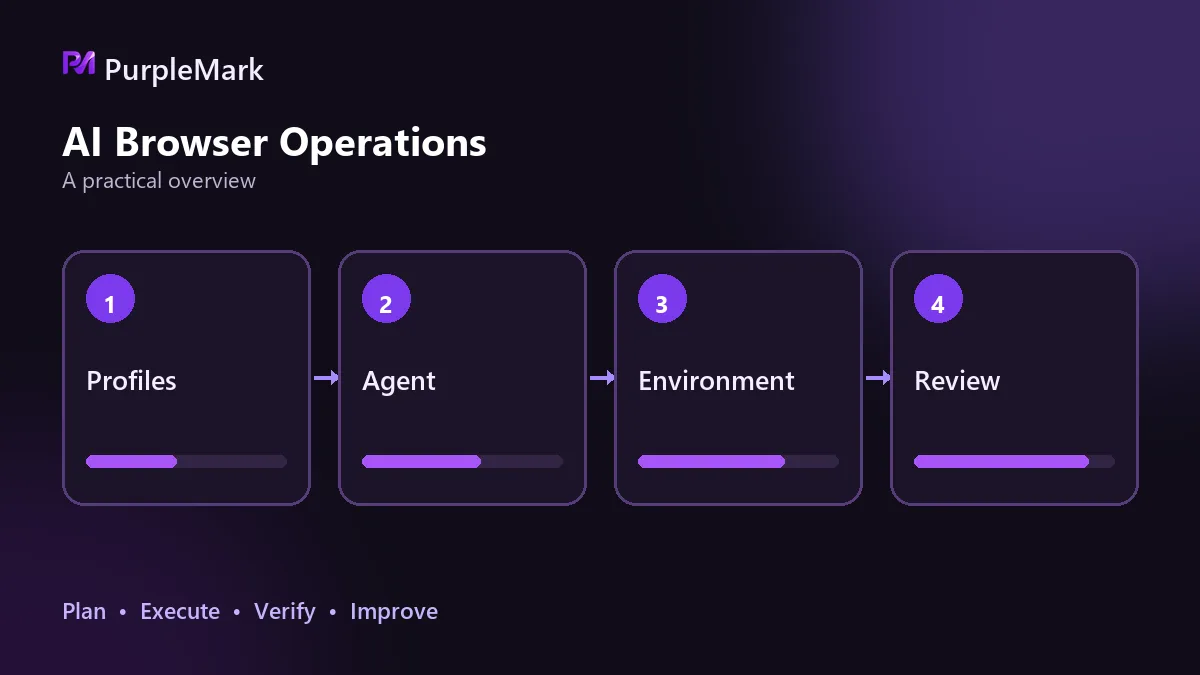
Asystent w panelu bocznym: rozumie stronę, ale jej nie obsługuje
W tej formie obok zwykłej przeglądarki znajduje się stały panel boczny. Może on podsumowywać długie artykuły, publikacje naukowe, a nawet setki stron PDF, odpowiadać na pytania na podstawie aktualnie oglądanej strony, pisać e-maile i raporty tygodniowe, tłumaczyć i przeredagowywać tekst oraz zmieniać ton i długość wypowiedzi. Niektóre narzędzia pozwalają również przesyłać obrazy do analizy wizualnej albo prowadzić rozmowę głosową.
W praktyce asystent AI zostaje umieszczony bezpośrednio obok strony, dzięki czemu odpada kopiowanie treści do osobnego czatu. Do porządkowania materiałów, badania tematów i wspomagania pisania często jest to w zupełności wystarczające.
Ograniczenie jest równie jasne: narzędzie rozumie treść, ale nie obsługuje witryny. Może uporządkować dużą liczbę materiałów, ale nie kliknie, nie wypełni formularza i nie wyśle go za użytkownika. To warstwa czytania i przetwarzania, a nie wykonania.
Sterowanie przez agenta: działa samodzielnie, ale najlepiej po jednym zadaniu
Ten typ idzie o krok dalej. Użytkownik opisuje zadanie naturalnym językiem, a agent sam wykonuje wiele kroków: przewija stronę, klika przyciski, wypełnia formularze i porównuje informacje w kilku otwartych kartach. Kluczowe jest rozumienie strony. Agent powinien sam rozpoznawać pola wejściowe i przyciski wysyłania zamiast polegać na selektorach napisanych wcześniej. Dzięki temu po zmianie struktury strony i awarii selektora nadal może próbować kontynuować.
Istnieją trzy główne ograniczenia. Operacje dotyczące płatności, bankowości lub prywatności są zwykle wstrzymywane i wymagają ręcznego potwierdzenia; to zamierzona granica bezpieczeństwa, a nie wada. Na skomplikowanych stronach z wieloma niestandardowymi komponentami agent nadal może popełniać błędy. Często pomija się też fakt, że został zaprojektowany do interakcji z jednym użytkownikiem, a nie do wysokiej współbieżności, dlatego jedno zadanie naraz jest jego normalnym trybem pracy.
Dobrze sprawdza się u osób wykonujących złożone, lecz rzadkie zadania w sieci.
Izolacja w chmurze: przeglądarka działa zdalnie, a korzysta się z niej jak lokalnie
W tym modelu proces przeglądarki nie działa na komputerze użytkownika; urządzenie lokalne służy głównie do interakcji. To samo środowisko można więc otworzyć z różnych urządzeń, a sesja i stan logowania pozostają w chmurze bez konieczności ponownej konfiguracji na każdej maszynie. Można tworzyć migawki i przywracać stan, cofnąć uszkodzone środowisko do ostatniej działającej wersji i nie przechowywać danych lokalnie. Jest to praktyczne dla zespołów zmieniających urządzenia lub takich, które nie chcą rozpraszać danych biznesowych po wielu endpointach.
Koszty także wynikają z chmury. Ruch sieciowy w obie strony zwiększa opóźnienia, więc obsługa jest mniej bezpośrednia niż lokalnie. Wraz ze wzrostem liczby środowisk rosną koszty zasobów chmurowych. Dostęp do plików lokalnych, sprzętu lokalnego i systemów w sieci wewnętrznej jest bardziej ograniczony niż w przeglądarce lokalnej. Chmura zmienia jedynie miejsce działania maszyny, więc przydział wyjść sieciowych i kontrolę współbieżności między wieloma środowiskami nadal trzeba zaplanować.
Przeglądarka z zarządzaniem środowiskami: warstwa do orkiestracji przez oprogramowanie
Ten typ nie jest przede wszystkim przeglądarką dla człowieka, lecz zasobem środowiskowym przeznaczonym do planowania i sterowania przez program.
Może seryjnie tworzyć niezależne środowiska, z których każde ma własny fingerprint, pliki cookie i pamięć lokalną; przez interfejs tworzyć, sprawdzać, uruchamiać, zatrzymywać i zwalniać środowiska; przypisywać osobne wyjście sieciowe do każdego środowiska; a także integrować się z popularnymi frameworkami automatyzacji i przyjmować sterowanie programistyczne. Celem jest przekształcenie środowisk przeglądarki w infrastrukturę możliwą do planowania, izolowania i zarządzania.
Rozwiązuje to zupełnie inny problem. Gdy liczba zadań rośnie z 1 do 100, wcześniejsze podejścia mogą zawieść jednocześnie: jeden użytkownik, jedno okno i jedno zadanie naraz nie wystarczą do pracy masowej; środowiska wpływają na siebie; zadania wzajemnie się zakłócają; a konta mogą zostać potraktowane jako jedna grupa. Na tym poziomie PurpleMark zapewnia izolację i scentralizowane zarządzanie środowiskami przeglądarki, aby każde zadanie działało we własnym środowisku.
Ograniczenie polega na tym, że system nie podejmuje decyzji za użytkownika i nie zmienia zasad żadnej platformy. Zgodność zadania nadal zależy od samego zadania.
Jak wybrać
Kolejność decyzji jest prosta: należy wyjść od rzeczywistej potrzeby i rozumować wstecz.
- Jeśli AI ma tylko pomagać w rozumieniu stron internetowych, pierwszy typ wystarczy; nie ma potrzeby płacić za niewykorzystywane możliwości wykonawcze.
- Jeśli AI ma jednorazowo wykonać złożoną operację, odpowiedni będzie drugi typ.
- Jeśli dane nie mają pozostawać lokalnie, a praca ma być kontynuowana na wielu urządzeniach, lepiej pasuje trzeci typ.
- Jeśli zautomatyzowane zadania mają działać stabilnie, masowo i bez wzajemnych zakłóceń, to niezależnie od używanej wcześniej funkcji AI potrzebna jest także czwarta warstwa.
Ostatni punkt wymaga podkreślenia. AI decyduje, co zrobić, a środowisko przeglądarki określa, pod jaką tożsamością zostanie to wykonane. Gdy ta warstwa tożsamości jest niestabilna, awarie mogą wyglądać na przypadkowe, choć ich źródło znajduje się w środowisku. Wiele zespołów najpierw przyciąga koncepcja przeglądarki AI i kupują narzędzie nastawione na rozumienie treści, a dopiero później odkrywają, że tak naprawdę potrzebują wykonania masowego. Jeśli kierunek został wybrany źle, nawet dobre narzędzie nie wypełni tej luki.
Najpierw ustal, czy potrzebujesz asystenta, czy wykonania, a dopiero potem określ skalę. Przed skalowaniem zbuduj warstwę środowiska i sprawdź przepływ na niewielkiej liczbie zadań. Zwiększanie skali dopiero później jest znacznie łatwiejsze niż naprawianie po fakcie grupy wzajemnie powiązanych kont.


