
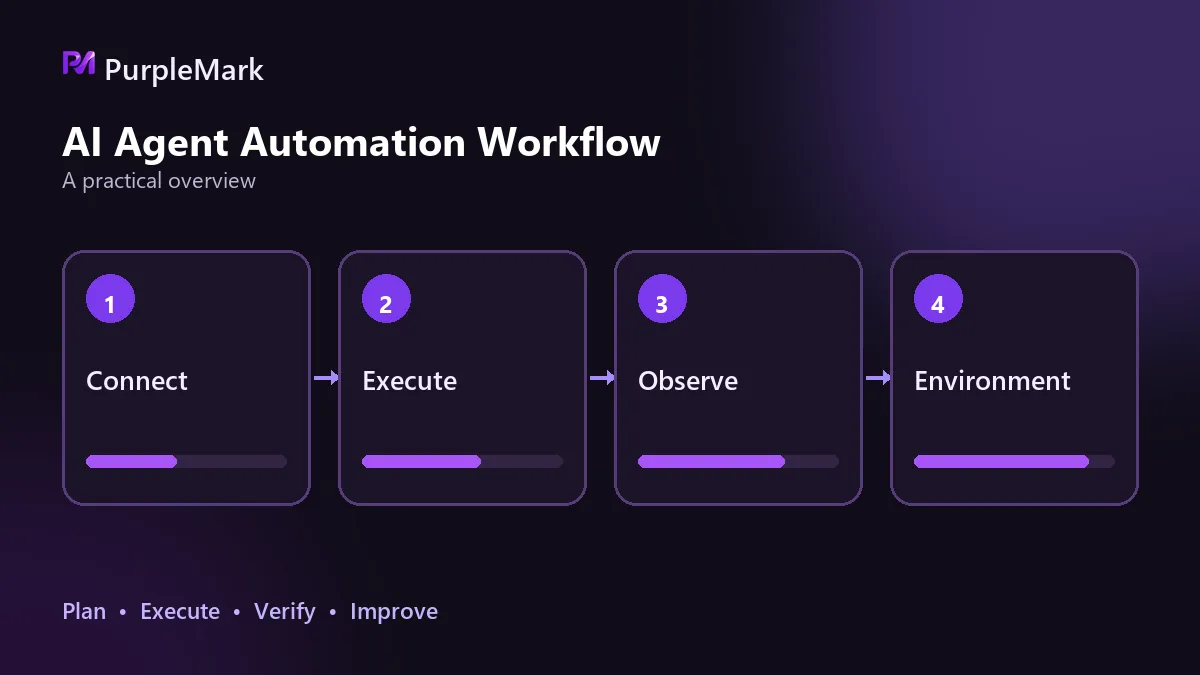
នៅពេល Agent អនុវត្តកិច្ចការ Web ការបរាជ័យភាគច្រើនកើតនៅ 4 ផ្នែក៖ ការកំណត់ទីតាំង element ការរង់ចាំនិង timeout ការរក្សាទុក state និងការរារាំងពី environment។ ការធ្វើឱ្យជំហាននីមួយៗ idempotent ការសាកល្បងឡើងវិញចំពោះ failure ដែលអាចស្ដារបាន ការរក្សា state ជាអចិន្ត្រៃយ៍ និងការបំបែក environment តាម task អាចធ្វើឱ្យអត្រាជោគជ័យមានស្ថិរភាពជាងមុន។
នៅពេលចាប់ផ្តើមធ្វើ Web automation គំនិតដំបូងជាទូទៅមើលទៅសាមញ្ញ៖ សរសេរ flow ហើយឱ្យ script ដំណើរការ។ Logic មើលទៅគ្មានបញ្ហា ប៉ុន្តែ task នៅតែបរាជ័យម្តងម្កាល ហើយ state របស់ account ក៏អាចបង្ហាញភាពមិនប្រក្រតី។ ជំហានដំបូងគឺពិនិត្យ code ប៉ុន្តែពេលស៊ើបអង្កេតជ្រៅទៅ បញ្ហាជាទូទៅប្រមូលផ្តុំនៅ 4 ចំណុច។
ពេល page ផ្លាស់ប្តូរ ការកំណត់ទីតាំង element ក៏អាចខូច
Script ភាគច្រើនប្រើ selector ដើម្បីរក element។ នៅពេល selector ត្រូវបាន hard-code ការផ្លាស់ប្តូរតិចតួចលើ page ក៏អាចធ្វើឱ្យវាមិនដំណើរការ៖ button ប្តូរ class name អត្ថបទប្តូរមួយពាក្យ section មួយប្តូរពី server-side rendering ទៅ asynchronous loading ឬ element ត្រូវបានដាក់ក្នុង container ថ្មី។ នៅពេលធ្វើ A/B test page ដូចគ្នាក៏អាចមាន structure ខុសគ្នាសម្រាប់ account ផ្សេងៗ។
រោគសញ្ញាទូទៅគឺរក element មិនឃើញ click ទៅខុសទីតាំង ឬចុច control ដែលមានឈ្មោះដូចគ្នាប៉ុន្តែនៅទីតាំងផ្សេង។ Failure ប្រភេទនេះមិនមែនមកពីការរអាក់រអួល network ទេ ដូច្នេះ retry ច្រើនដងក៏មិនជួយ។
វិធីដែលអាចអនុវត្តបានគឺកាត់បន្ថយការពឹងផ្អែកលើ absolute path។ គួរប្រើ accessibility attributes, business ID ដែលមានស្ថិរភាព ឬទំនាក់ទំនង relative រវាង elements ជាមុន ហើយរៀបចំ fallback selectors សម្រាប់ page ប្រភេទដូចគ្នា ដើម្បីប្តូរដោយស្វ័យប្រវត្តិពេល primary selector បរាជ័យ។ ប្រសិនបើ page មាន iframe ឬ Shadow DOM ត្រូវប្តូរទៅ context ត្រឹមត្រូវជាមុន បើមិនដូច្នោះទេការរក element នឹងបរាជ័យ។
កំណត់ការរង់ចាំ និង timeout មិនត្រឹមត្រូវ
បើពេលរង់ចាំខ្លីពេក element អាចត្រូវបានសន្និដ្ឋានថាបរាជ័យមុនពេល render រួច ហើយមើលទៅដូចជា script មាន bug។ បើរង់ចាំយូរពេក ពេលវេលារបស់ task មួយនឹងអូសបន្លាយ throughput ធ្លាក់ចុះ ហើយ timeout យូរអាចបិទបាំង error ពិតប្រាកដ។
Explicit wait គួរឱ្យទុកចិត្តជាង fixed sleep៖ រង់ចាំ condition ជាក់លាក់ ដូចជា target element បង្ហាញឡើង request ត្រឡប់មក ឬ loading animation បាត់។ Timeout budget គួរត្រូវបានកំណត់ជាស្រទាប់ ដោយមានតម្លៃខុសគ្នាសម្រាប់ step មួយ page មួយ និង task ទាំងមូល ហើយបង្រួមតាមកម្រិត មិនមែនប្រើតម្លៃដូចគ្នាទាំងអស់។
ត្រូវបែងចែកផងដែររវាងការរង់ចាំឱ្យ page អាចប្រើបាន និងការរង់ចាំឱ្យ business result ត្រូវបានបង្កើត។ សម្រាប់ករណីទីមួយ ការរង់ចាំ DOM ready ជាទូទៅគ្រប់គ្រាន់; ករណីទីពីរអាចត្រូវរង់ចាំ API callback ឬការផ្លាស់ប្តូរ status text លើ page។ បើរង់ចាំ signal ខុស operation អាចមើលទៅជោគជ័យ ប៉ុន្តែ data ពិតប្រាកដមិនបានសរសេរ។
Progress បាត់នៅកណ្តាល multi-step task
Task ដូចជា registration, ordering និង publishing អាចមានច្រើនជាង 10 steps យ៉ាងងាយ។ ប្រសិនបើ process ឈប់នៅកណ្តាលដោយ timeout, browser crash ឬ host restart ហើយ state មានតែក្នុង memory ទេ ពេលដំណើរការលើកក្រោយត្រូវចាប់ផ្តើមពីដំបូង ឬ submit step មុនម្ដងទៀត។
ផលវិបាកនៃ duplicate execution អាចពិបាកស្វែងរកជាង failure ធម្មតា៖ operation ដូចគ្នាត្រូវបានអនុវត្តពីរដង upstream system មាន record បន្ថែម ហើយពិបាករកប្រភព។
ដំណោះស្រាយគឺឱ្យ step នីមួយៗមាន persistence point។ បន្ទាប់ពីបញ្ចប់ step មួយ ត្រូវសរសេរ progress ទៅកន្លែងដែលអាចរក្សាទុកជាអចិន្ត្រៃយ៍ ជាមួយ unique identifier របស់ task; បន្ទាប់ពី restart ត្រូវបន្តពីចំណុចជោគជ័យចុងក្រោយ។ មិនត្រូវការ framework ស្មុគស្មាញទេ—file មួយ ឬ state record មួយក៏គ្រប់គ្រាន់។
ការរារាំងពី environment មើលទៅដូច code error
បញ្ហា 3 ប្រភេទដំបូងកើតនៅក្នុង task ប៉ុន្តែមានមួយប្រភេទទៀតមកពី environment។ Site អាចបញ្ចូល browser characteristics, access behavior និង network origin ដើម្បីវាយតម្លៃប្រភព traffic។ ប្រសិនបើវាចាត់ទុកថាសង្ស័យ វាអាចបង្ហាញ verification page, content ទទេ ឬ timeout ដោយផ្ទាល់។ ក្នុង task logs វាមើលទៅស្ទើរតែដូច execution error។
មូលហេតុដែលជួបញឹកញាប់មាន៖
- ទីតាំងរបស់ egress IP, time zone និង language មិនត្រូវគ្នា
- Task ទាំងអស់ផ្ញើ request ពី browser environment ដូចគ្នា ធ្វើឱ្យ request density ក្នុងមួយឯកតាពេលវេលាខ្ពស់ជាងអ្នកប្រើពិតយ៉ាងច្បាស់
- Environment ផ្លាស់ប្តូរញឹកញាប់ ឬ account login ម្ដងហើយម្ដងទៀត
4 វិធីដើម្បីបង្កើនអត្រាជោគជ័យ
- ធ្វើឱ្យ step នីមួយៗ idempotent។ មុនអនុវត្ត ត្រូវពិនិត្យថា prerequisite បានបំពេញរួចឬនៅ ដើម្បីឱ្យការធ្វើ action ម្តងទៀតមិនបង្កើត side effect បន្ថែម។ Read operation ជាទូទៅ idempotent ដោយធម្មជាតិ ខណៈ write operation ត្រូវមាន unique identifier ឬ deduplication key ជាការការពារ។
- បែងចែក failure ជាប្រភេទ។ Failure បណ្តោះអាសន្ន ដូចជា element មិនទាន់ render, network jitter ឬ API ត្រឡប់ 5xx អាច retry ជាមួយ backoff។ Failure ដែលកំណត់ច្បាស់ ដូចជា account ត្រូវបានកម្រិត, parameter មិនត្រឹមត្រូវ ឬ target resource មិនមាន នឹងមិនប្រសើរឡើងទោះ retry ប៉ុន្មានដងទេ; គួរបញ្ចប់វា ដើម្បីកុំឱ្យវាកាន់កាប់ concurrency capacity ជាប់រហូត។
- Persist state ជាប្រចាំ។ រក្សាទុក progress, intermediate outputs និង current step ដើម្បីឱ្យ task បន្ទាប់ពី restart អាចបន្តពីកន្លែងដែលឈប់ មិនមែនចាប់ផ្តើមពី step ទីមួយ។
- បំបែក runtime environment តាម task។ Account ឬ task នីមួយៗគួរមាន browser environment ផ្ទាល់ខ្លួន ដោយមិន share Cookies និង local storage, fingerprint characteristics មានភាពខុសគ្នាសមហេតុផល ហើយ time zone និង language ត្រូវគ្នាជាមួយ region របស់ egress IP។
ចំណុចទី 4 កាន់តែសំខាន់ពេលទំហំ task កើនឡើង។ នៅពេល task រាប់សិបឬរាប់រយដំណើរការស្របគ្នា environment layer ជាអ្នកកំណត់កម្រិតខ្ពស់បំផុតនៃ stability ហើយក៏កំណត់ទំហំផលប៉ះពាល់ពេលមានបញ្ហា។ ក្នុងស្ថានភាពបែបនេះ PurpleMark ផ្តល់សមត្ថភាពបង្កើត isolated environments តាមតម្រូវការ និង reclaim ជាក្រុម ដោយ account នីមួយៗមាន environment ផ្ទាល់ខ្លួន ដូច្នេះ state របស់ task មិនប៉ះពាល់គ្នា។
ខ្លឹមសារនេះមានគោលបំណងសម្រាប់ technical research និងការចែករំលែក development practice ប៉ុណ្ណោះ។ សូមប្រើបច្ចេកវិទ្យាពាក់ព័ន្ធដោយស្របច្បាប់ និងស្របតាមបទបញ្ជា ហើយគោរព terms of service របស់ target platform។


