
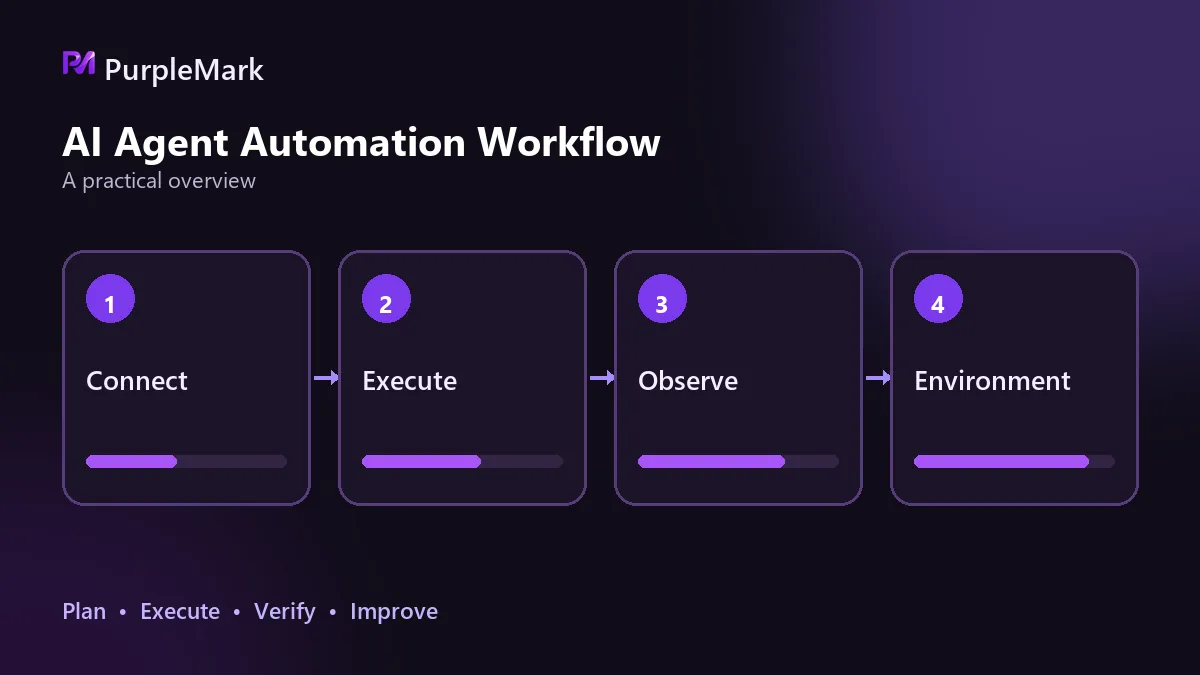
En las tareas web de un Agent, los fallos suelen concentrarse en cuatro áreas: localización de elementos, esperas y timeouts, persistencia del estado y bloqueos del entorno. Hacer los pasos idempotentes, reintentar fallos recuperables, guardar el estado y aislar el entorno por tarea mejora mucho la estabilidad de la tasa de éxito.
Al empezar con la automatización web, el planteamiento suele parecer muy directo: definir el flujo y ejecutar el script. La lógica se ve correcta, pero las tareas siguen fallando de forma esporádica y el estado de las cuentas a veces presenta anomalías. La primera reacción es revisar el código, aunque al investigar a fondo los problemas suelen concentrarse en cuatro puntos.
Un cambio en la página rompe la localización
La mayoría de los scripts encuentran elementos mediante selectores. Cuando un selector queda fijado de forma rígida, casi cualquier cambio de la página puede dejarlo inutilizable: un botón cambia de clase, se modifica una palabra del texto, una sección pasa de renderizado del servidor a carga asíncrona o un elemento queda envuelto en un nuevo contenedor. Durante una prueba A/B, la misma página puede incluso mostrar estructuras diferentes para distintas cuentas.
Los síntomas habituales son que no se encuentra un elemento, el clic cae en el lugar equivocado o se pulsa un control con el mismo nombre pero en otra posición. Este tipo de fallo no se debe a fluctuaciones de red y no se resuelve por repetir el intento varias veces.
Una opción práctica es depender menos de rutas absolutas. Conviene priorizar atributos de accesibilidad, IDs de negocio estables o relaciones relativas entre elementos; también preparar selectores alternativos para el mismo tipo de página y degradar automáticamente cuando falle el principal. Si la página contiene un iframe o Shadow DOM, primero hay que cambiar al contexto correcto; de lo contrario, la localización fallará.
Las esperas y los timeouts están en el rango equivocado
Si la espera es demasiado corta, un elemento puede marcarse como fallido antes de terminar de renderizarse, lo que parece un bug del script. Si es demasiado larga, cada tarea puede prolongarse sin necesidad, baja el rendimiento y los timeouts extensos pueden ocultar el error real.
Las esperas explícitas son más fiables que un sleep fijo: se espera a que se cumpla una condición concreta, como que aparezca el elemento objetivo, responda una solicitud o desaparezca una animación de carga. El presupuesto de timeout debe configurarse por capas, con límites distintos para un paso, una página y la tarea completa, y ajustarse progresivamente en lugar de usar el mismo valor en todas partes.
También hay que distinguir entre esperar a que la página sea utilizable y esperar a que se genere el resultado de negocio. Para lo primero suele bastar con esperar a que el DOM esté listo; para lo segundo puede ser necesario esperar un callback de la API o un cambio en el texto de estado de la página. Esperar la señal equivocada puede hacer que la operación parezca exitosa aunque los datos no se hayan guardado.
Se pierde el progreso a mitad de una tarea de varios pasos
Tareas como registrarse, hacer un pedido o publicar pueden superar fácilmente los diez pasos. Si el proceso se interrumpe a mitad por un timeout, un fallo del navegador o un reinicio del host, y el estado solo existe en memoria, la siguiente ejecución tendrá que empezar desde cero o volver a enviar el paso anterior.
Las consecuencias de una ejecución duplicada pueden ser más difíciles de diagnosticar que un simple fallo: la misma operación se ejecuta dos veces, el sistema ascendente recibe un registro adicional y resulta difícil rastrear su origen.
La solución es dar a cada paso un punto de persistencia. Después de completar cada uno, se guarda el progreso en un almacenamiento duradero junto con el identificador único de la tarea; tras un reinicio, se continúa desde el último punto completado con éxito. No hace falta un framework complejo: basta un archivo o un registro de estado.
Un bloqueo del entorno parece un error de código
Los tres primeros tipos de problema aparecen dentro de la tarea, pero hay otro que viene del entorno. Un sitio puede combinar características del navegador, comportamiento de acceso y origen de red para evaluar de dónde procede el tráfico. Si lo considera sospechoso, puede devolver una página de verificación, contenido vacío o simplemente agotar el tiempo de espera. En los registros de la tarea, esto puede parecer casi igual que un error de ejecución.
Entre los desencadenantes habituales están:
- La ubicación de la IP de salida, la zona horaria y el idioma no coinciden
- Todas las tareas envían solicitudes desde el mismo entorno de navegador y generan una densidad de solicitudes por unidad de tiempo claramente superior a la de usuarios reales
- El entorno cambia con frecuencia o la cuenta vuelve a iniciar sesión repetidamente
Cuatro medidas para elevar la tasa de éxito
- Hacer cada paso idempotente. Antes de ejecutarlo, comprobar si la condición previa ya se cumple, de modo que repetir la acción no produzca efectos secundarios adicionales. Las consultas son idempotentes por naturaleza; las escrituras necesitan un identificador único o una clave de deduplicación.
- Clasificar los fallos. Los temporales, como un elemento que aún no se ha renderizado, una fluctuación de red o una API que devuelve 5xx, pueden reintentarse con backoff. Los deterministas, como una restricción de cuenta, parámetros no válidos o un recurso objetivo inexistente, no mejorarán por repetir; conviene terminarlos para que no sigan ocupando capacidad de concurrencia.
- Persistir el estado con regularidad. Guardar el progreso, los resultados intermedios y el paso actual permite que la tarea continúe después de reiniciarse en vez de volver al primer paso.
- Aislar el entorno de ejecución por tarea. Cada cuenta o tarea debe tener su propio entorno de navegador, sin compartir Cookies ni almacenamiento local, con características de fingerprint razonablemente diferenciadas y con zona horaria e idioma coherentes con la región de la IP de salida.
La cuarta medida se vuelve especialmente importante cuando crece el volumen de tareas. Cuando se ejecutan decenas o cientos en paralelo, la capa de entorno fija el límite superior de estabilidad y también el alcance del impacto cuando algo falla. En este tipo de escenarios, PurpleMark permite crear entornos aislados bajo demanda y recuperarlos por lotes, dando a cada cuenta su propio entorno para evitar que los estados de distintas tareas se contaminen entre sí.
Este contenido se ofrece únicamente para investigación técnica y para compartir prácticas de desarrollo. Utilice las tecnologías relacionadas de forma legal y conforme a la normativa, y respete los términos de servicio de la plataforma objetivo.


