
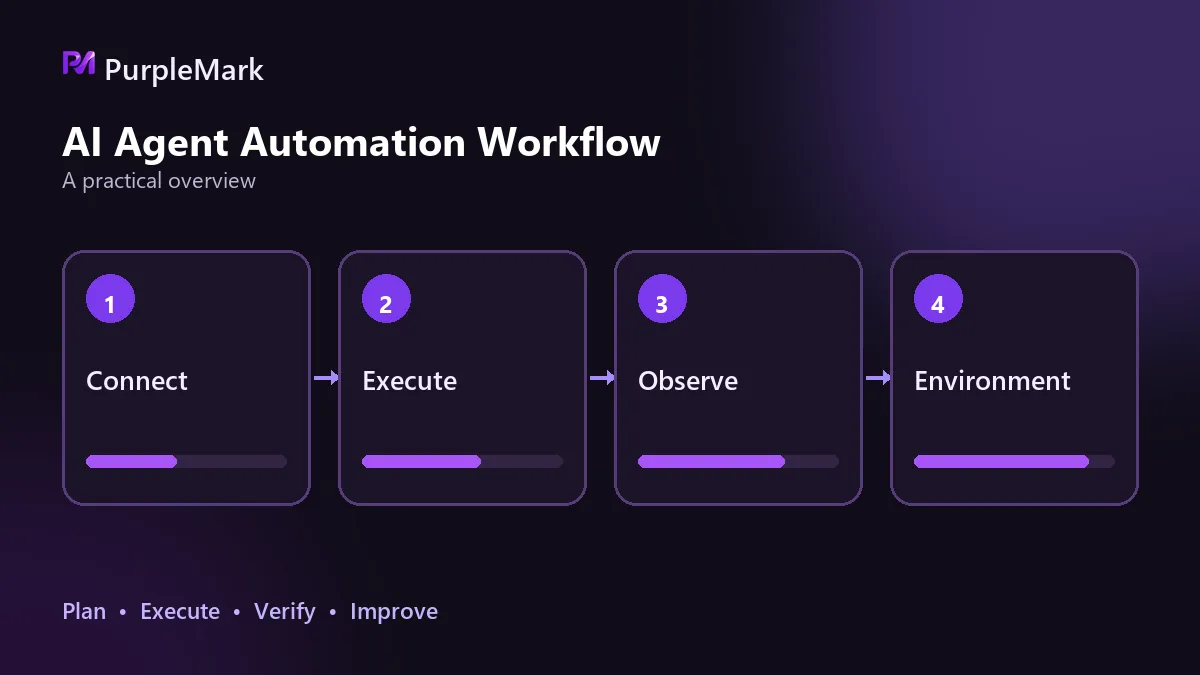
Agent के वेब टास्क में विफलताएँ अक्सर चार जगह होती हैं: element targeting, wait और timeout, state persistence, तथा environment-side blocking। हर step को idempotent बनाना, recoverable failures पर retry करना, state को persist करना और task के अनुसार environment अलग रखना सफलता दर को काफी स्थिर बनाता है।
वेब automation शुरू करते समय सोच अक्सर सीधी होती है: workflow लिखो और script चला दो। Logic ठीक दिखता है, फिर भी task कभी-कभी विफल होते रहते हैं और account state भी समय-समय पर असामान्य दिखती है। पहली प्रतिक्रिया code जाँचने की होती है, लेकिन गहराई से troubleshooting करने पर समस्या आम तौर पर चार जगह केंद्रित मिलती है।
Page बदलते ही element targeting टूट जाती है
अधिकांश scripts elements खोजने के लिए selectors पर निर्भर करते हैं। Selector को hard-code कर दिया जाए तो page में लगभग कोई भी बदलाव उसे बेकार कर सकता है: button का class name बदल जाए, copy का एक शब्द बदल जाए, कोई section server-side rendering से asynchronous loading पर चला जाए, या element को नए container में रख दिया जाए। A/B test के दौरान एक ही page अलग-अलग accounts के लिए अलग structure भी दिखा सकता है।
आम तौर पर element नहीं मिलता, click गलत जगह पड़ता है, या उसी नाम का लेकिन दूसरी position वाला control click हो जाता है। ऐसी failure network jitter की वजह से नहीं होती, इसलिए कई बार retry करने पर भी ठीक नहीं होगी।
व्यावहारिक तरीका absolute paths पर निर्भरता कम करना है। Accessibility attributes, stable business IDs या elements के बीच relative relationships को प्राथमिकता दें; एक ही तरह के page के लिए fallback selectors रखें ताकि primary selector fail होने पर system अपने-आप नीचे वाले विकल्प पर जा सके। यदि page में iframe या Shadow DOM है, तो पहले सही context में switch करना जरूरी है, वरना targeting fail होगी।
Wait और timeout की सीमा गलत रखी गई है
Wait बहुत छोटी हो तो element के render होने से पहले ही उसे failure माना जा सकता है, जिससे script में bug जैसा लगता है। Wait बहुत लंबी हो तो एक task का समय अनावश्यक रूप से बढ़ता है, throughput गिरता है और लंबे timeouts असली error को छिपा सकते हैं।
Fixed sleep की तुलना में explicit wait अधिक भरोसेमंद है: किसी ठोस condition का इंतजार करें, जैसे target element दिखना, request का response आना या loading animation का गायब होना। Timeout budget को layers में रखना चाहिए—एक step, एक page और पूरे task के लिए अलग limits—और हर जगह एक ही value लगाने के बजाय उन्हें क्रमशः सीमित करना चाहिए।
यह भी अलग करना जरूरी है कि page usable होने का इंतजार किया जा रहा है या business result बनने का। पहले मामले में DOM ready होना अक्सर पर्याप्त है; दूसरे में API callback या page के status text में बदलाव का इंतजार करना पड़ सकता है। गलत signal का इंतजार करने पर operation successful दिख सकता है, जबकि data वास्तव में लिखा ही नहीं गया हो।
Multi-step task के बीच में progress खो जाती है
Registration, ordering और publishing जैसे task आसानी से दस से अधिक steps के हो सकते हैं। यदि process बीच में timeout, browser crash या host restart के कारण बंद हो जाए और state केवल memory में हो, तो अगली run में या तो शुरुआत से करना पड़ेगा या पिछला step दोबारा submit होगा।
Duplicate execution का असर साधारण failure से भी मुश्किल हो सकता है: वही operation दो बार चलता है, upstream system में एक अतिरिक्त record बन जाता है और उसका स्रोत पता लगाना कठिन हो जाता है।
उपाय है कि हर step का persistence point हो। हर step पूरा होने के बाद progress को task के unique identifier के साथ किसी persistent location में लिखें; restart के बाद आखिरी successful point से आगे बढ़ें। इसके लिए complex framework की जरूरत नहीं है—एक file या एक state record पर्याप्त है।
Environment-side blocking code error जैसी दिखती है
पहली तीन समस्याएँ task के अंदर होती हैं, लेकिन एक श्रेणी environment से आती है। Site browser characteristics, access behavior और network origin को मिलाकर traffic का स्रोत तय कर सकती है। Access संदिग्ध लगे तो वह verification page, खाली content या सीधा timeout दे सकती है। Task logs में यह execution error जैसा ही दिख सकता है।
आम कारण हैं:
- Egress IP की location, time zone और language आपस में मेल नहीं खाते
- सभी task एक ही browser environment से requests भेजते हैं, इसलिए प्रति unit time request density वास्तविक users से साफ तौर पर ज्यादा होती है
- Environment बार-बार बदलता है या account बार-बार दोबारा login करता है
Success rate बढ़ाने वाली चार बातें
- हर step को idempotent बनाएं। Execute करने से पहले जाँचें कि prerequisite पहले ही पूरा तो नहीं है, ताकि action दोहराने पर अतिरिक्त side effect न हो। Read operations स्वाभाविक रूप से idempotent होते हैं; write operations को unique identifier या deduplication key से सुरक्षित करना चाहिए।
- Failures को classify करें। Temporary failures, जैसे element अभी render न हुआ हो, network jitter हो या API 5xx लौटाए, backoff के साथ retry की जा सकती हैं। Deterministic failures, जैसे account restriction, invalid parameters या target resource का न होना, कितनी भी retries से नहीं बदलेंगी; इन्हें terminate करें ताकि ये concurrency capacity लगातार न घेरें।
- State को नियमित रूप से persist करें। Progress, intermediate outputs और current step को save करें, ताकि restart के बाद task पहली step से शुरू होने के बजाय वहीं से आगे बढ़े।
- Runtime environment को task के अनुसार isolate करें। हर account या task को अलग browser environment दें, ताकि Cookies और local storage share न हों, fingerprint characteristics में उचित अंतर हो, और time zone व language egress IP के region से मेल खाएँ।
Task का scale बढ़ने पर चौथी बात खास तौर पर महत्वपूर्ण हो जाती है। जब दर्जनों या सैकड़ों task parallel चल रहे हों, तो environment layer stability की ऊपरी सीमा तय करती है और यह भी कि समस्या होने पर असर कितना फैलेगा। ऐसे scenarios में PurpleMark on-demand isolated environments बनाने और उन्हें batch में reclaim करने की क्षमता देता है, जिससे हर account का अपना environment रहता है और अलग task की state एक-दूसरे को प्रभावित नहीं करती।
यह सामग्री केवल तकनीकी research और development practice साझा करने के लिए है। संबंधित तकनीकों का उपयोग कानून और नियमों के अनुसार करें तथा target platform की terms of service का पालन करें।


