
एक ही IP पर अलग-अलग जाँच टूल विपरीत निष्कर्ष दे सकते हैं। यह लेख बताता है कि डेटाबेस कवरेज और अपडेट फ़्रीक्वेंसी से अंतर क्यों आता है, कई स्रोतों से क्रॉस-वैलिडेशन कैसे करें, और जब टेस्ट सामान्य दिखें लेकिन वास्तविक उपयोग में समस्या रहे तो किस क्रम में जाँच करें।
आपने प्रॉक्सी खरीदा, सेटअप पूरा किया, कनेक्शन सफल दिखा, फिर भी अकाउंट में समस्या आ गई। ऐसे में बहुत से लोग सबसे पहले IP को एक बार जाँचते हैं। लोकेशन सही दिखे और प्रॉक्सी का कोई फ्लैग न हो तो वे मान लेते हैं कि वातावरण ठीक है और फिर दूसरी जगह कारण ढूँढने लगते हैं।
समस्या यह है कि एक ही क्वेरी बहुत सीमित चीज़ें बता सकती है, और उसका निष्कर्ष भी हमेशा भरोसेमंद नहीं होता।
एक ही IP, अलग-अलग टूल में अलग जवाब
बाज़ार में IP जाँच के लिए इस्तेमाल होने वाले टूल वास्तव में अलग-अलग सवालों का जवाब देते हैं।
एक श्रेणी जियोलोकेशन और ओनरशिप देखती है और देश, शहर, ऑपरेटर, ASN तथा टाइम ज़ोन बताती है। दूसरी श्रेणी प्रॉक्सी और जोखिम देखती है—IP रेजिडेंशियल है या डेटा सेंटर का, उसमें प्रॉक्सी के संकेत हैं या नहीं, और फ्रॉड स्कोर कितना है। तीसरी श्रेणी लीक की जाँच करती है और देखती है कि WebRTC या DNS असली IP उजागर तो नहीं कर रहे। ये तीनों प्रकार की जानकारी एक-दूसरे की जगह नहीं ले सकते: किसी IP की लोकेशन पूरी तरह सही हो सकती है और उस पर प्रॉक्सी फ्लैग भी नहीं हो सकता, फिर भी ब्राउज़र WebRTC से असली IP लीक कर सकता है; जियोलोकेशन टूल यह बात कभी नहीं बताएगा।
एक ही श्रेणी के टूल भी अक्सर अलग परिणाम देते हैं। इसके कई कारण हैं: डेटा स्रोत अलग हो सकते हैं—किसी के पास ऑपरेटर रजिस्ट्रेशन डेटा है, कोई सक्रिय स्कैनिंग और honeypot नेटवर्क इस्तेमाल करता है, तो कोई यूज़र रिपोर्ट; कवरेज अलग हो सकती है, इसलिए एक डेटाबेस में IP का रिकॉर्ड हो और दूसरे में न हो; अपडेट फ़्रीक्वेंसी अलग होती है, इसलिए IP का मालिक बदलने के बाद पुराना डेटाबेस पुरानी जानकारी दिखाता रह सकता है; और निर्णय के थ्रेशोल्ड भी अलग होते हैं, क्योंकि हर प्रदाता स्वयं तय करता है कि कितना संदेह हाई रिस्क माना जाए।
इन सभी अंतरों के कारण एक टूल IP को लाल और दूसरा हरा दिखा सकता है। इसलिए किसी एक नतीजे पर तुरंत फैसला न करें। टूल्स को अलग-अलग सूचना स्रोत मानें, अलग-अलग निर्णायक नहीं।
क्रॉस-वैलिडेशन कैसे करें
पहला स्तर कई स्रोतों की तुलना है। एक ही IP को कम से कम दो ऐसे टूल में जाँचें जिनकी कवरेज लॉजिक अलग हो। उद्देश्य यह तय करना नहीं है कि कौन सही है, बल्कि यह देखना है कि अंतर कहाँ है। जियोलोकेशन में बड़ा अंतर बताता है कि ओनरशिप डेटा भरोसेमंद नहीं है; जोखिम निष्कर्षों में बड़ा अंतर बताता है कि IP खुद एक ग्रे एरिया में है और उसे अधिक सावधानी से देखना चाहिए।
दूसरा स्तर ओनरशिप और ऑपरेटर जानकारी को साथ देखना है। केवल शहर का सही होना पर्याप्त नहीं; यह भी देखें कि ASN किसका है। रेजिडेंशियल ISP का ASN और क्लाउड प्रदाता का ASN प्लेटफ़ॉर्म के लिए दो बिल्कुल अलग चीज़ें हैं: पहला वास्तविक यूज़र जैसा लगता है, दूसरा सर्वर जैसा। यदि IP लक्ष्य शहर दिखाता है लेकिन ASN डेटा सेंटर की ओर इशारा करता है, तो केवल सही लोकेशन उसकी विश्वसनीयता नहीं बढ़ाती।
तीसरा स्तर वास्तविक व्यवहार है। IP किस देश का है और आप उसे जिस तरह इस्तेमाल कर रहे हैं वह उससे मेल खाता है या नहीं—ये दो अलग बातें हैं। IP अमेरिका दिखा सकता है, लेकिन ब्राउज़र का टाइम ज़ोन एशिया का हो, इंटरफ़ेस भाषा चीनी हो और कंटेंट प्राथमिकताएँ भी मेल न खाएँ। ऐसे विरोधाभास अक्सर IP से भी आसानी से पहचाने जाते हैं। टाइम ज़ोन, भाषा, मुद्रा प्रदर्शन और सामान्य सर्च आदतें एक सेट के रूप में IP लोकेशन से मेल खानी चाहिए। यह स्तर डेटाबेस क्वेरी से नहीं दिखता; लक्ष्य प्लेटफ़ॉर्म पर जाकर वास्तविक रूप से जाँच करनी पड़ती है।
सभी जाँच पास हैं, फिर भी अकाउंट में समस्या है
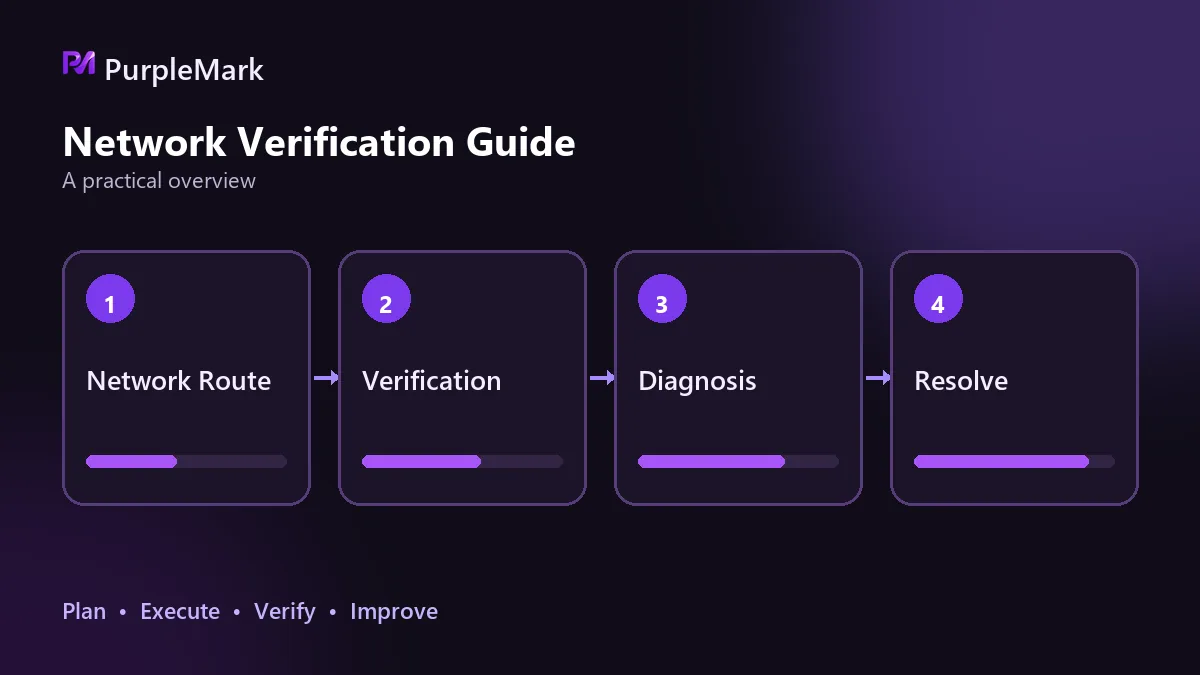
आगे की जाँच में टूल से ज़्यादा महत्वपूर्ण क्रम है।
सबसे पहले पुष्टि करें कि प्रॉक्सी वास्तव में लागू है। यह जाँच अलग से करें और खास तौर पर WebRTC तथा DNS के दो लीक पॉइंट देखें; इनका इस बात से संबंध नहीं कि IP खुद “साफ़” है या नहीं। कई साफ़ दिखने वाले IP की समस्या यहीं होती है।
इसके बाद देखें कि डिवाइस आइडेंटिटी और नेटवर्क आइडेंटिटी आपस में संगत हैं या नहीं। यदि IP, टाइम ज़ोन, भाषा, रेज़ोल्यूशन जैसे पैरामीटर एक-दूसरे से विरोध करते हैं, तो सामान्य जाँच टूल अक्सर कोई त्रुटि नहीं दिखाते, लेकिन प्लेटफ़ॉर्म का रिस्क-कंट्रोल सिस्टम इस असंगति को असामान्य संकेत के रूप में दर्ज कर सकता है।
फिर अकाउंट-साइड संकेत देखें। लक्ष्य प्लेटफ़ॉर्म पर थोड़ी संख्या में कॉन्फ़िगरेशन का वास्तविक परीक्षण करें और देखें कि CAPTCHA की आवृत्ति बढ़ रही है या नहीं, असामान्य लॉगिन चेतावनी आ रही है या नहीं, या कंटेंट रीच और रिकमेंडेशन कम हो रहे हैं। ऐसे बदलाव अक्सर औपचारिक लिमिट या बैन से पहले दिखाई देते हैं। सामान्य जाँच पास होने का मतलब यह नहीं कि प्लेटफ़ॉर्म वातावरण को स्वीकार करता है, इसलिए इस चरण को छोड़ा नहीं जा सकता।
अंत में IP की मौजूदा स्थिति फिर देखें। IP की प्रतिष्ठा बदलती रहती है: आज साफ़ होना यह गारंटी नहीं कि अगले सप्ताह भी वैसा ही रहेगा। साझा IP में यह विशेष रूप से महत्वपूर्ण है, क्योंकि पिछले यूज़र के व्यवहार से पता ग्रे लिस्ट में जा सकता है; रेजिडेंशियल IP भी गलत तरीके से फ़्लैग हो सकते हैं। जब जाँच नतीजे और वास्तविक व्यवहार मेल न खाएँ, तो इस दिशा को दोबारा देखना चाहिए।
हाई-रिस्क परिस्थितियों में केवल समस्या आने पर जाँच करने के बजाय नियमित री-टेस्ट का समय तय करें। हर बार मुख्य मेट्रिक्स रिकॉर्ड करें, ताकि समस्या आने पर तुलना के लिए बेसलाइन हो। वरना यह तय करना केवल अनुमान पर निर्भर रहेगा कि स्थिति बिगड़ी है या हमेशा से ऐसी थी।
IP जाँच से आगे की परत
IP साफ़ हो और कोई लीक न हो, तब भी अकाउंट में समस्या हो सकती है क्योंकि रिस्क कंट्रोल पूरे वातावरण की संगति देखता है। नेटवर्क आइडेंटिटी, डिवाइस आइडेंटिटी और अकाउंट आइडेंटिटी का संबंध यह है: पहली दो आपस में संगत होनी चाहिए और अलग-अलग अकाउंट एक-दूसरे से स्वतंत्र रहने चाहिए।
इन तीनों में से किसी एक में भी असंगति असामान्य संकेत बना सकती है। डिवाइस आइडेंटिटी स्तर पर हर अकाउंट के लिए अलग ब्राउज़र वातावरण रखना और IP, टाइम ज़ोन व भाषा को एक सेट के रूप में मिलाना नेटवर्क और डिवाइस स्तर को संरेखित करने का सामान्य तरीका है। PurpleMark इस स्तर पर environment isolation देता है; हर environment स्वतंत्र रूप से चलता है और उसके पैरामीटर IP लोकेशन के अनुसार कॉन्फ़िगर किए जा सकते हैं।
कोई भी टूल पूरी तरह व्यापक और सटीक नहीं हो सकता, और उच्च गुणवत्ता वाले रेजिडेंशियल प्रॉक्सी की पहचान अपने आप में कठिन है। व्यावहारिक तरीका है एक निश्चित टूल संयोजन रखना, नियमित रूप से री-टेस्ट करना, परिणाम दर्ज करना और वास्तविक प्लेटफ़ॉर्म पर छोटे पैमाने के परीक्षणों के साथ अंतिम निष्कर्ष बनाना।
यह केवल तकनीकी तरीकों और टूल श्रेणियों की व्याख्या है; यह किसी टूल या सेवा की सिफारिश नहीं है।


