
指紋瀏覽器的比較結論常互相矛盾,原因在於需求不同。先依帳號數量、平台數量、是否團隊協作、是否需要 API 把需求歸位,再按五個能力面向評分,最後用清單在試用階段逐項驗證。
關於指紋瀏覽器的比較文章很多,結論常常互相衝突,一家說 A 好,一家說 B 好。原因不一定是誰在說謊,而是「好」這個標準本身取決於需求。選型真正的第一步不是打開產品清單,而是先把自己的需求弄清楚。
先用四個問題把需求歸位
第一個問題是帳號數量。10 個以內、10 到 100 個、100 個以上,是完全不同的三種情況。10 個以內,重點是隔離做得乾淨、能以低成本先驗證;上百個之後,重點會立刻轉到批次建立、分組管理、批次匯入匯出和並行啟動的成功率。環境一多就找不到、改個設定還要一個個點,會讓操作變得非常困難。
第二個問題是平台數量與風控強度。只做一個平台,和一個帳號要同時覆蓋多個平台,對參數自洽的要求並不一樣。風控嚴的平台會注意時區、語言、Canvas、WebGL 這些細節。環境內部參數若彼此矛盾,參數再多也沒有意義。
第三個問題是是否需要團隊協作。單人操作不需要複雜的權限體系;3 到 10 個人分工管理一批帳號時,環境共享、權限分級、操作日誌就會變成剛需。團隊規模一上來,沒有日誌和權限,就很難劃分責任。這才是真正的痛點,而不只是技術能力不夠。
第四個問題是是否需要 API。如果要把環境接進自己的自動化系統或 AI Agent,那麼環境從建立、啟動、查詢到停止、回收,最好每個環節都能透過 API 完成。只要生命週期裡有一個步驟只能靠人工點介面,整條自動化就會斷在那裡。
四個問題回答完,選項通常會收斂到很小的範圍。這一步最常見的失誤,是跳過歸位直接看產品,一開始就買最高階方案,最後卻用不到一半功能。
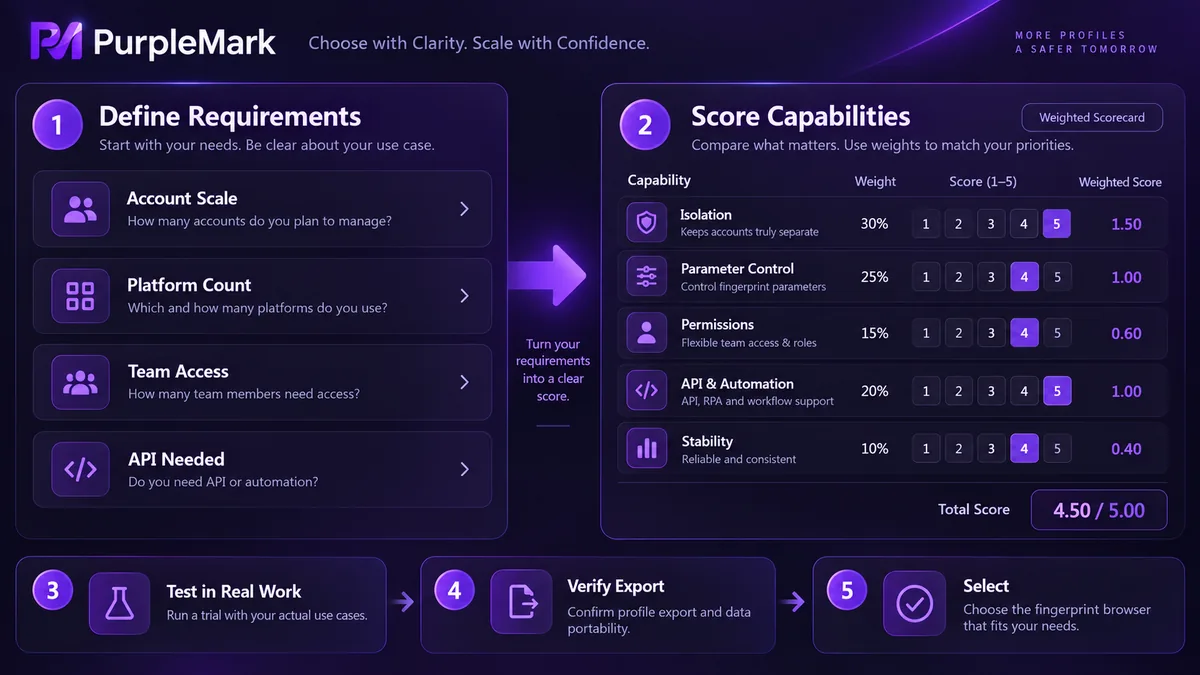
再按五個面向評分
歸位之後,用同一套尺去衡量候選方案。五項裡有兩項是底線。
環境隔離度排第一位。指紋、Cookies、本機儲存能不能彼此不混用,決定這套工具是否成立。隔離不徹底,後面的能力都沒有意義。
參數可控性看兩件事:時區、語言這類地理參數能不能跟著網路出口自動匹配,以及環境內部的參數之間有沒有矛盾。可以修改的參數多,和實際隔離效果是兩回事;矛盾少比數量多更重要。
團隊權限是協作情境的分水嶺。能不能把環境共享給成員而不交出原始密碼,能不能分級授權,有沒有操作日誌,這三項缺一項,團隊使用遲早會出問題。
API 與自動化決定上限。環境的建立、啟動、查詢、停止是否全部能走 API,能不能與主流自動化框架配合,是否支援 MCP 這類協定讓 AI 工具接入,都要問清楚。
穩定性放最後,但往往在事後才暴露。它包含兩層:瀏覽器核心更新能不能跟上主流版本,平台調整風控後多久能跟進;以及同時啟動數十個環境時,成功率和資源占用是什麼水準。
評分方式很簡單,按自己的業務需求給這五項排序,不合格的直接排除,不要在底線上折衷。看似省下的成本,後面常會在故障和返工裡還回去。
試用階段的驗證清單
不要只看介紹,用試用額度在自己的真實業務裡跑一輪。下面這些項目都可以自己驗證。
隔離方面,先確認環境之間不會互相串資料,Cookies 和本機儲存互不影響;再檢查 WebRTC 會不會把真實網路出口暴露出去;最後看多個環境之間的指紋差異度夠不夠。
一致性方面,重點核對時區、語言與網路出口是否匹配,以及環境內部各項參數有沒有互相矛盾。
穩定性方面,同時啟動十多個環境,看成功率、啟動耗時和資源占用;再翻一翻核心版本和更新日誌,和目前主流瀏覽器版本比較差距。
團隊方面,把共享、權限、日誌實際走一遍,看是不是真的能用,而不只是選單裡有。
API 方面,把環境從建立到回收完整走一遍 API,找出有沒有必須人工介入的環節。這一步決定自動化能不能真正落地。
還有一項很多人在選型時完全沒考慮:資料匯出能力。換工具時,能不能把環境和帳號資訊完整匯出。它決定你被單一工具鎖定的程度。
試用建議給兩週,規模不必大。小規模跑真實業務,比任何比較表都更準。
三個容易踩的坑
比較指紋參數的數量。可修改的參數多,和實際隔離效果是兩回事。
相信廠商自己發布的排行榜。絕大多數排名由廠商發布,排第一的往往就是自家產品。唯一可靠的判斷方式,是自己用測試案例驗一遍。
只看價格。便宜方案的成本往往會轉移到人力效率、故障率和帳號損失上。多環境工具真正的開銷不在軟體費,而在帳號出事之後的重新建置。
先比價格、後看能力,把順序顛倒過來,最後通常都會返工。


