
雲端主機、雲端瀏覽器按時間計費,批次任務最容易在額度上出問題。估算消耗、確定併發上限,以及超額後的補救順序,是可以提前完成的三項準備。
按時計費的資源,帳單邏輯很直接:執行時間乘以執行個體數量。額度是硬上限,一旦撞上去,任務不是變慢,而是直接失敗——新的執行個體無法建立,正在執行的執行個體可能被回收,介面也會開始回傳限流錯誤。先弄清楚自己距離上限還有多少空間,比事後才增加預算更有用。
先分清楚哪些消耗是必要的
同一筆額度,用在不同任務上的產出差異可能很大。先做一次盤點,按照是否真的需要即時執行來區分任務。
常駐任務是最容易吃掉額度的一類。它可能全天執行,但真正有工作可做的時間只有幾分鐘。把常駐監控改成定時觸發,通常就能砍掉一大塊消耗,對業務幾乎沒有感覺。集中在特定時段的尖峰任務可以錯峰,一次性任務則按需啟動。
接著問自己一句:這個任務延遲六小時執行,業務會受影響嗎?會,就留在關鍵路徑上即時執行;不會,就轉成低優先級的批次處理,放到額度較寬鬆的時段。競品價格監控從每小時一次改成每天兩次,多數情境下的資訊價值並不會實質下降。
消耗怎麼估,併發怎麼定
按執行個體執行時間計費時,一批任務的總消耗大致等於單個任務的平均時間乘以任務數量,跟併發開多大沒有關係;併發只決定多久能跑完。真正和併發有關的是瞬間壓力:同時啟動的執行個體越多,就越容易撞上資源池的併發上限和平台端的限流。
所以併發要從最小開始測。先跑一個,確認單一任務的平均執行時間和成功率;再逐步增加到幾個、十幾個,記錄失敗率和重試次數。某個位置之後失敗率明顯升高,那裡就是實際可用的上限,再往上加,只會用重試把省下來的時間還回去。
估算時別漏掉隱性時間:登入等待、頁面載入、驗證步驟、失敗重試,這些經常比主流程本身還久。替單一任務保留一些餘量,比精確到分鐘更有用。
超額之後會是什麼樣子
額度耗盡的現場不太容易辨認,因為它常常看起來像其他問題。
一種表現是任務卡在啟動階段,環境或執行個體的建立請求被拒絕,日誌裡只剩一句模糊的失敗訊息。另一種是執行到一半被回收,前面的進度全部白做。還可能出現限流錯誤、部分成功部分失敗,以及佇列越來越長卻沒有人處理。
最容易誤判的是假死:執行個體還在,任務看起來正在執行,其實一直卡在等待狀態,而額度仍隨時間持續消耗。遇到這種情況,先看額度使用面板,再單獨拿一個小任務測一次。小任務也起不來,方向就在額度或權限;小任務正常,那就比較可能是併發或環境重用的問題。
補救的順序
先做不花錢的動作。
第一步,停掉低價值的常駐消耗,把監控類任務改成定時執行。第二步,把可延遲的任務移到額度較寬鬆的時段,讓消耗曲線變平。第三步,降低併發上限並加上佇列,讓任務進入佇列後按照可用容量處理,而不是一起啟動。第四步才壓低無效消耗:同一份資源加上快取,不重複抓取;一次請求盡量取得更多資料;注定失敗的請求快速退出,不要反覆重試。
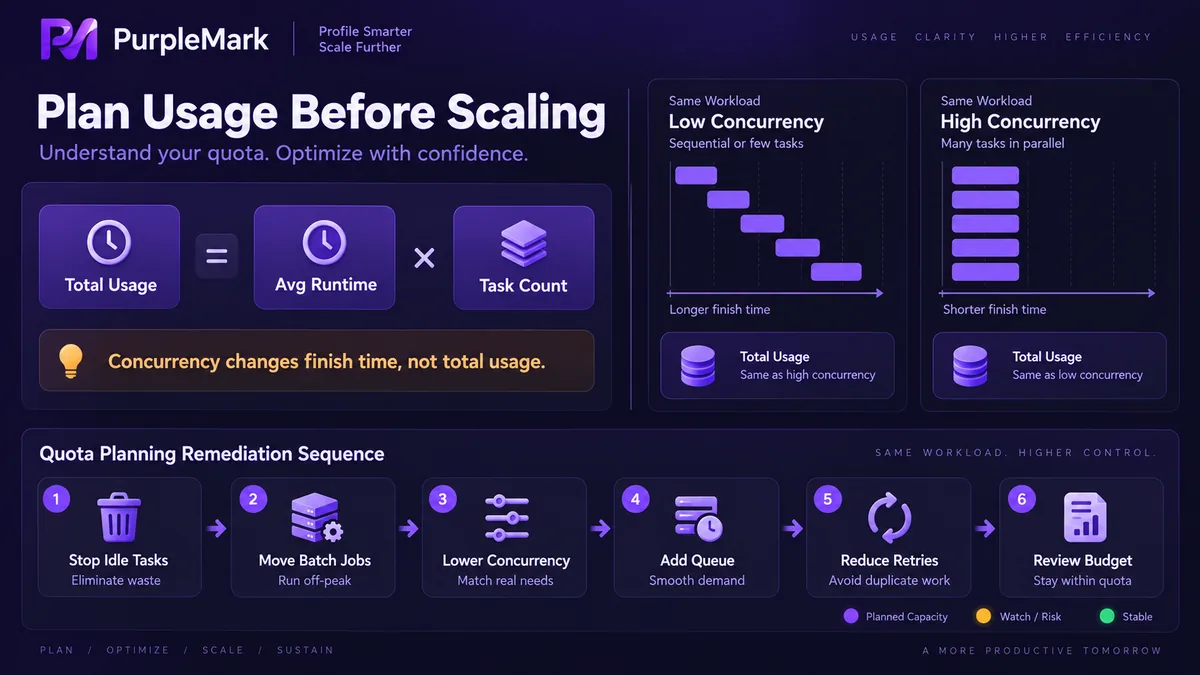
這四步做完後,再看是否需要增加預算或升到更高的服務層級。很多時候會發現,真正需要的額度比一開始以為的少。反過來,如果先增加預算,就等於連浪費的習慣一起買單。
環境層不要跟著一起壓縮
省額度時最常見的錯誤之一,是讓多個任務共用同一個瀏覽器環境,理由是同一個環境只要啟動一次就夠了。
代價會立刻出現:工作階段互相覆蓋、登入狀態被頂掉、快取混在一起,一個任務失敗還可能拖累其他任務。省下來的那點執行個體時間,會在故障排查和重新執行上加倍還回去。
這兩層應該分開看。計算層負責執行任務邏輯,按需排程,追求成本效率;環境層負責身分與隔離,一個任務一個獨立環境,追求穩定。因為算力吃緊就去壓縮環境層,是把兩類成本混在一起。批次建立和回收環境,本來就應該由環境層的工具統一管理。像 PurpleMark 這樣按環境隔離工作階段與快取,上層的任務和執行器才更容易靈活調度。
最後提醒一句:降本不要往違規方向走。不要為了省額度去用非官方管道的服務,也不要靠提高請求頻率硬衝。觸發限流之後的反覆重試,往往比按節奏執行更耗額度。


