
ម៉ាស៊ីននិម្មិតលើពពក និងកម្មវិធីរុករកលើពពកគិតថ្លៃតាមពេលវេលា ដូច្នេះការងារជាបាច់អាចឈានដល់កូតាបានងាយ។ ត្រូវប៉ាន់ប្រមាណការប្រើប្រាស់ កំណត់កម្រិតដំណើរការស្របពេលដែលប្រើបានពិត និងដោះស្រាយតាមលំដាប់ត្រឹមត្រូវពេលលើសកូតា។
សម្រាប់ធនធានដែលគិតថ្លៃតាមពេលវេលា របៀបគិតថ្លៃគឺសាមញ្ញ៖ រយៈពេលដំណើរការ គុណនឹងចំនួន instance។ កូតាគឺជាព្រំដែនរឹង។ ពេលប៉ះព្រំដែននេះ ការងារមិនត្រឹមតែយឺតទេ ប៉ុន្តែបរាជ័យដោយផ្ទាល់៖ មិនអាចបង្កើត instance ថ្មីបាន instance ដែលកំពុងដំណើរការអាចត្រូវបានដកយកវិញ ហើយ API ចាប់ផ្តើមត្រឡប់កំហុសកំណត់អត្រា។ ការដឹងថានៅសល់ចន្លោះប៉ុន្មានមុនដល់ព្រំដែន មានប្រយោជន៍ជាងការបន្ថែមថវិកាបន្ទាប់ពីបញ្ហាកើតឡើង។
ជំហានដំបូង៖ បំបែកការប្រើប្រាស់ចាំបាច់ចេញពីការប្រើប្រាស់ដែលអាចកាត់បន្ថយ
កូតាដូចគ្នាអាចផ្តល់លទ្ធផលខុសគ្នាខ្លាំង អាស្រ័យលើការងារដែលប្រើវា។ ចាប់ផ្តើមដោយពិនិត្យបញ្ជីការងារ ហើយបែងចែកតាមថាតើត្រូវការដំណើរការតាមពេលវេលាពិតប្រាកដមែនឬអត់។
ការងារដែលបើកជាប់ជានិច្ចគឺជាប្រភេទដែលងាយស៊ីកូតាបំផុត។ វាអាចបើកពេញមួយថ្ងៃ ទោះបីមានការងារពិតតែប៉ុន្មាននាទីក៏ដោយ។ ការប្តូរពីការត្រួតពិនិត្យជាប់ជានិច្ចទៅជាការចាប់ផ្តើមតាមកាលវិភាគ អាចកាត់បន្ថយការប្រើប្រាស់បានច្រើន ដោយស្ទើរតែមិនប៉ះពាល់ដល់អាជីវកម្ម។ ការងារដែលមានកំពូលនៅពេលជាក់លាក់អាចប្តូរទៅម៉ោងផ្សេង ហើយការងារម្តងម្កាលអាចចាប់ផ្តើមតែពេលចាំបាច់។
បន្ទាប់មកសួរខ្លួនឯងថា៖ បើការងារនេះដំណើរការយឺតជាងមុនប្រាំមួយម៉ោង តើអាជីវកម្មរងផលប៉ះពាល់ទេ? បើប៉ះពាល់ ត្រូវរក្សាទុកនៅលើផ្លូវសំខាន់ ហើយដំណើរការតាមពេលវេលាពិត។ បើមិនប៉ះពាល់ សូមបម្លែងទៅជាការងារជាបាច់អាទិភាពទាប ហើយកំណត់ពេលនៅវគ្គដែលកូតាធូរជាង។ ការប្តូរការតាមដានតម្លៃគូប្រកួតពីរាល់មួយម៉ោងទៅពីរដងក្នុងមួយថ្ងៃ ជាទូទៅមិនបន្ថយតម្លៃព័ត៌មានយ៉ាងសំខាន់ទេ។
របៀបប៉ាន់ប្រមាណការប្រើប្រាស់ និងកំណត់ការដំណើរការស្របពេល
ពេលគិតថ្លៃតាមរយៈពេលដំណើរការរបស់ instance ការប្រើប្រាស់សរុបរបស់បាច់មួយ ប្រហែលស្មើនឹងរយៈពេលមធ្យមរបស់ការងារមួយ គុណនឹងចំនួនការងារ។ វាមិនអាស្រ័យលើកម្រិតដំណើរការស្របពេលទេ; ការដំណើរការស្របពេលកំណត់តែថាបាច់នោះបញ្ចប់លឿនប៉ុណ្ណោះ។ អ្វីដែលពាក់ព័ន្ធផ្ទាល់គឺសម្ពាធភ្លាមៗ៖ instance កាន់តែច្រើនចាប់ផ្តើមក្នុងពេលតែមួយ កាន់តែងាយប៉ះកម្រិតស្របពេលរបស់ resource pool ឬការកំណត់អត្រារបស់វេទិកា។
ដូច្នេះត្រូវចាប់ផ្តើមពីកម្រិតស្របពេលទាបបំផុត។ សាកល្បងការងារមួយសិន ដើម្បីបញ្ជាក់រយៈពេលមធ្យម និងអត្រាជោគជ័យ។ បន្ទាប់មកបង្កើនបន្តិចម្តងៗទៅពីរបីការងារ ហើយទៅប្រហែលដប់ជាង ដោយកត់ត្រាអត្រាបរាជ័យ និងចំនួនព្យាយាមឡើងវិញ។ ពេលអត្រាបរាជ័យកើនឡើងច្បាស់ក្រោយចំណុចណាមួយ នោះគឺជាកម្រិតអតិបរមាដែលអាចប្រើបានពិត។ បង្កើនលើសពីនេះ នឹងធ្វើឱ្យពេលវេលាដែលគិតថាសន្សំបាន ត្រូវចំណាយត្រឡប់ទៅលើការព្យាយាមឡើងវិញ។
ពេលប៉ាន់ប្រមាណ កុំភ្លេចពេលវេលាលាក់ខ្លួន៖ រង់ចាំចូលគណនី ផ្ទុកទំព័រ ជំហានផ្ទៀងផ្ទាត់ និងការព្យាយាមឡើងវិញក្រោយបរាជ័យ។ ទាំងនេះជាញឹកញាប់អាចយូរជាងដំណើរការសំខាន់។ ការទុកចន្លោះពេលសម្រាប់ការងារនីមួយៗ មានប្រយោជន៍ជាងការគណនាឲ្យត្រឹមនាទី។
ពេលកូតាអស់ វាបង្ហាញដូចម្តេច
ការអស់កូតាអាចពិបាកសម្គាល់ ព្រោះវាមើលទៅដូចបញ្ហាផ្សេងៗជាញឹកញាប់។
សញ្ញាមួយគឺការងារជាប់នៅដំណាក់កាលចាប់ផ្តើម ព្រោះសំណើបង្កើត environment ឬ instance ត្រូវបានបដិសេធ ហើយក្នុង log នៅសល់តែសារបរាជ័យមិនច្បាស់។ សញ្ញាមួយទៀតគឺ instance ត្រូវបានដកយកវិញនៅកណ្តាលដំណើរការ ធ្វើឱ្យវឌ្ឍនភាពមុនៗបាត់បង់។ ក៏អាចមានកំហុសកំណត់អត្រា ជោគជ័យខ្លះបរាជ័យខ្លះ ឬជួររង់ចាំដែលវែងឡើងៗ តែគ្មានអ្វីដំណើរការ។
អ្វីដែលងាយវិនិច្ឆ័យខុសបំផុតគឺការជាប់ក្លែងក្លាយ៖ instance នៅតែមាន ហើយការងារមើលទៅកំពុងដំណើរការ ប៉ុន្តែពិតប្រាកដវាជាប់នៅក្នុងការរង់ចាំ ខណៈកូតានៅតែត្រូវបានប្រើតាមពេលវេលា។ ក្នុងករណីនេះ សូមមើលផ្ទាំងប្រើកូតាជាមុន ហើយសាកល្បងការងារតូចមួយដោយឡែក។ បើការងារតូចក៏មិនអាចចាប់ផ្តើមបាន នោះគួរពិនិត្យកូតា ឬសិទ្ធិ។ បើវាដំណើរការធម្មតា បញ្ហានឹងទំនងជាការដំណើរការស្របពេល ឬការប្រើ environment ឡើងវិញ។
លំដាប់ដោះស្រាយ
ចាប់ផ្តើមពីជំហានដែលមិនចំណាយប្រាក់បន្ថែម។
ទីមួយ បញ្ឈប់ការប្រើប្រាស់ជាប់ជានិច្ចដែលមានតម្លៃទាប ហើយប្តូរការងារត្រួតពិនិត្យទៅដំណើរការតាមកាលវិភាគ។ ទីពីរ ផ្លាស់ទីការងារដែលអាចពន្យារពេលទៅវគ្គដែលមានកូតាធូរ ដើម្បីធ្វើឱ្យខ្សែកោងប្រើប្រាស់រាបស្មើ។ ទីបី បន្ថយកម្រិតស្របពេល ហើយបន្ថែម queue ដើម្បីឱ្យការងារត្រូវបានដំណើរការតាមសមត្ថភាពដែលមាន ជំនួសឱ្យចាប់ផ្តើមទាំងអស់ក្នុងពេលតែមួយ។ ទីបួន កាត់បន្ថយការប្រើប្រាស់ខ្ជះខ្ជាយ៖ ប្រើ cache សម្រាប់ធនធានដដែលជំនួសឱ្យទាញយកម្តងហើយម្តងទៀត យកទិន្នន័យច្រើនជាងមុនក្នុងសំណើមួយនៅពេលសមស្រប បញ្ឈប់សំណើដែលប្រាកដថានឹងបរាជ័យឱ្យលឿន ហើយកុំសាកល្បងឡើងវិញមិនចប់។
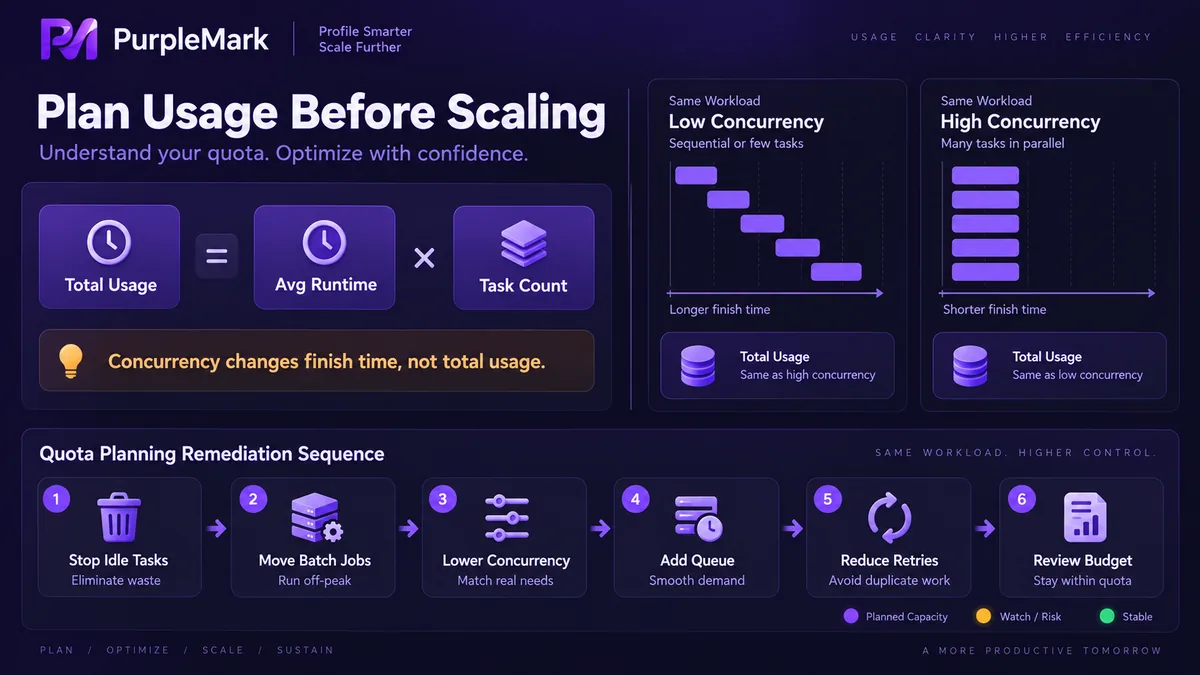
បន្ទាប់ពីជំហានទាំងបួននេះ ទើបពិចារណាថាតើត្រូវបន្ថែមថវិកា ឬឡើងកម្រិតសេវាឬអត់។ ជាញឹកញាប់អ្នកនឹងឃើញថាកូតាដែលត្រូវការពិតប្រាកដ តិចជាងអ្វីដែលគិតនៅដំបូង។ ផ្ទុយទៅវិញ បើបន្ថែមថវិកាជាមុន អ្នកក៏កំពុងបង់សម្រាប់ទម្លាប់ប្រើប្រាស់មិនមានប្រសិទ្ធភាពផងដែរ។
កុំបង្ហាប់ស្រទាប់ environment រួមជាមួយស្រទាប់គណនា
កំហុសទូទៅពេលសន្សំកូតា គឺឱ្យការងារច្រើនប្រើ browser environment តែមួយ ដោយគិតថាបើបើក environment ម្តងគឺគ្រប់គ្រាន់។
ផលប៉ះពាល់កើតឡើងភ្លាមៗ៖ session សរសេរជាន់គ្នា ស្ថានភាព login ត្រូវបានជំនួស cache លាយគ្នា ហើយការបរាជ័យរបស់ការងារមួយអាចប៉ះពាល់ដល់ការងារផ្សេងទៀត។ ពេល instance ដែលសន្សំបានតិចតួច នឹងត្រូវចំណាយត្រឡប់ច្រើនដងក្នុងការរកកំហុស និងរត់ការងារឡើងវិញ។
ស្រទាប់ទាំងពីរនេះគួរត្រូវបានមើលដោយឡែក។ ស្រទាប់គណនាទទួលខុសត្រូវដំណើរការតក្កវិជ្ជាការងារ កំណត់ពេលតាមតម្រូវការ និងផ្តោតលើប្រសិទ្ធភាពចំណាយ។ ស្រទាប់ environment ទទួលខុសត្រូវអត្តសញ្ញាណ និងការបំបែក ដោយមាន environment ឯករាជ្យមួយសម្រាប់ការងារនីមួយៗ ដើម្បីផ្តោតលើស្ថេរភាព។ បង្ហាប់ស្រទាប់ environment ព្រោះធនធានគណនាខ្វះ គឺជាការលាយចំណាយពីរប្រភេទខុសគ្នា។ ការបង្កើត និងដក environment ជាច្រើនគួរត្រូវបានគ្រប់គ្រងកណ្តាលដោយឧបករណ៍របស់ស្រទាប់ environment។ ពេល PurpleMark បំបែក session និង cache តាម environment ការងារ និង executor នៅស្រទាប់ខាងលើអាចរៀបចំកាលវិភាគបានបត់បែនជាង។
សេចក្តីរំលឹកចុងក្រោយ៖ កុំកាត់បន្ថយចំណាយដោយបំពានច្បាប់។ កុំប្រើសេវាមិនផ្លូវការដើម្បីសន្សំកូតា ហើយកុំបង្ខំ throughput ដោយបង្កើនប្រេកង់សំណើ។ បន្ទាប់ពីការកំណត់អត្រាត្រូវបានបើក ការព្យាយាមឡើងវិញជាធម្មតាប្រើកូតាច្រើនជាងការដំណើរការតាមល្បឿនដែលគ្រប់គ្រងបាន។


