
クラウドVMやクラウドブラウザは時間課金のため、バッチ処理ではクォータ超過が起きやすくなります。消費量を見積もり、実用的な同時実行上限を決め、超過時の対処順序をあらかじめ整理することが重要です。
時間課金のリソースは、稼働時間×インスタンス数という単純な課金構造です。クォータは明確な上限であり、到達するとタスクが単に遅くなるのではなく、そのまま失敗します。新しいインスタンスを作成できず、稼働中のインスタンスが回収され、APIがレート制限エラーを返し始めます。上限までどれだけ余裕があるかを把握しておくほうが、問題が起きてから予算を増やすより有効です。
まず必要な消費と不要な消費を分ける
同じクォータでも、どのタスクに使うかで得られる成果は大きく変わります。最初に棚卸しを行い、本当にリアルタイム実行が必要かどうかでタスクを分類します。
常時稼働タスクはクォータを消費しやすい代表例です。一日中動いていても、実際に処理している時間は数分だけということがあります。常時監視を定時実行に切り替えるだけで、業務への影響をほとんど出さずに大きく消費を削減できることがあります。特定時間帯に集中するピーク処理は時間をずらし、単発タスクは必要なときだけ起動します。
次に、「このタスクが6時間遅れても業務に影響しないか」と考えます。影響するならクリティカルパスに残してリアルタイムで実行します。影響しないなら低優先度のバッチ処理に切り替え、クォータに余裕のある時間帯へ移します。競合価格の監視を1時間ごとから1日2回に減らしても、多くの場面では情報価値が大きく下がるわけではありません。
消費量の見積もりと同時実行数の決め方
インスタンスの稼働時間で課金される場合、1バッチの総消費量は、おおむね「1タスクの平均所要時間×タスク数」です。同時実行数をいくつにしても総消費量そのものは変わらず、変わるのは完了までの時間です。一方、同時実行数は瞬間的な負荷に直結します。同時に起動するインスタンスが多いほど、リソースプールの同時実行上限やプラットフォーム側のレート制限に当たりやすくなります。
そのため、同時実行数は最小から試します。まず1件だけ実行し、平均所要時間と成功率を確認します。その後、数件、十数件へと段階的に増やし、失敗率とリトライ回数を記録します。ある地点から失敗率が明確に上がるなら、そこが実用上の上限です。さらに増やしても、短縮したはずの時間をリトライで失うだけです。
見積もりでは、ログイン待ち、ページ読み込み、検証処理、失敗後のリトライといった見えにくい時間を忘れないでください。これらが本処理より長いこともあります。分単位で厳密に計算するより、1タスクごとに余裕を持たせるほうが実用的です。
クォータを使い切るとどう見えるか
クォータ枯渇は、別の問題に見えることが多いため判別しにくい場合があります。
一つの症状は、環境やインスタンスの作成要求が拒否され、タスクが起動段階で止まり、ログには曖昧な失敗だけが残ることです。別の症状として、実行途中でインスタンスが回収され、それまでの進捗が無駄になることもあります。レート制限エラー、一部だけ成功して残りが失敗する状態、処理されないまま伸び続けるキューなども起こり得ます。
特に誤診しやすいのが「見かけ上のハング」です。インスタンスは存在し、タスクも動いているように見えますが、実際には待機状態で止まり、時間の経過とともにクォータだけが消費され続けます。この場合は、まずクォータ使用状況のパネルを確認し、次に小さなタスクを1件だけ試します。小さなタスクも起動できないなら、クォータか権限を疑います。正常に動くなら、同時実行数か環境の再利用が原因である可能性が高くなります。
対処の順序
まず、追加費用のかからない対策から行います。
第一に、価値の低い常時消費を止め、監視系タスクを定時実行へ切り替えます。第二に、遅延可能なタスクをクォータに余裕のある時間帯へ移し、消費曲線を平準化します。第三に、同時実行上限を下げてキューを追加し、すべてを一斉に起動するのではなく、利用可能な容量に応じて処理します。第四に、無駄な消費を減らします。同じリソースはキャッシュして再取得を避け、可能なら1回のリクエストでより多くのデータを取得し、失敗が確実なリクエストは早く終了し、無限にリトライしないようにします。
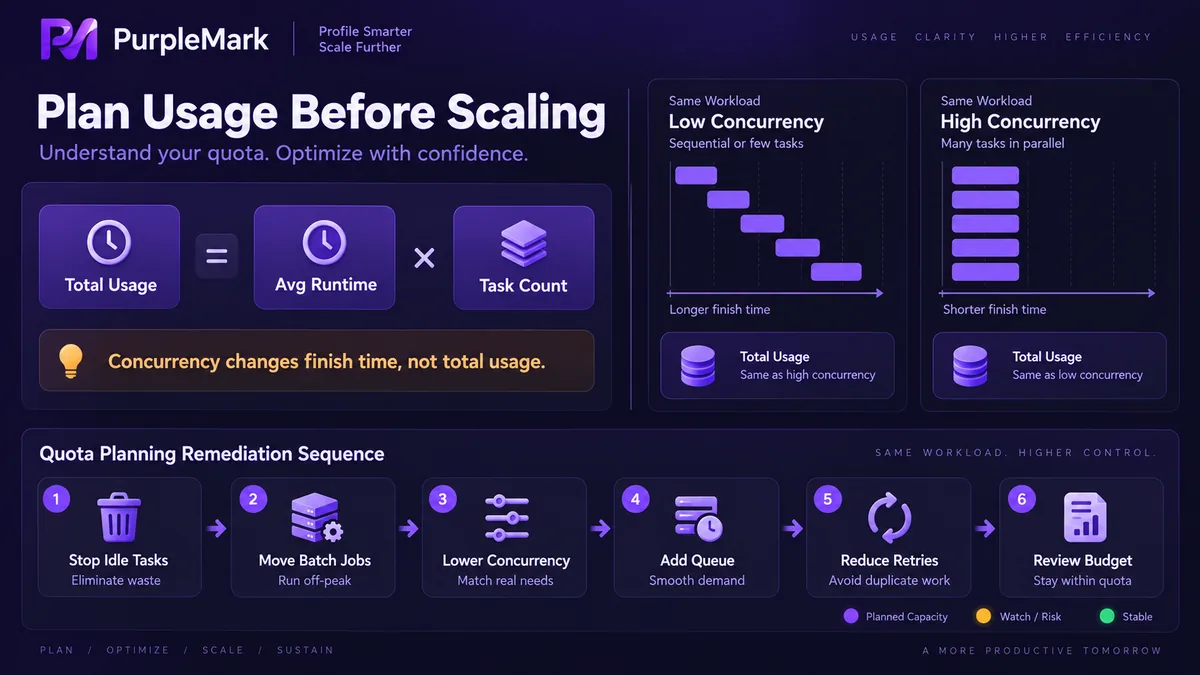
この4段階を終えてから、予算増額や上位プランが本当に必要かを判断します。実際に必要なクォータは、当初想定していたより少ないことも珍しくありません。逆に、最初に予算を増やすと、非効率な運用習慣までそのまま買い支えることになります。
コンピュート層と一緒に環境層まで圧縮しない
クォータを節約しようとしてよく起きる誤りが、「同じ環境なら一度起動すればよい」という理由で複数タスクに1つのブラウザ環境を共有させることです。
代償はすぐに現れます。セッション同士が上書きし、ログイン状態が崩れ、キャッシュが混ざり、1つのタスク失敗が他のタスクまで巻き込むことがあります。少し節約したインスタンス時間は、障害調査や再実行で何倍にもなって返ってきます。
この2つの層は分けて考えるべきです。コンピュート層はタスクロジックを実行し、必要に応じてスケジュールし、コスト効率を重視します。環境層はIDと分離を担い、1タスクにつき1つの独立環境を用意して安定性を重視します。計算資源が逼迫しているからといって環境層まで圧縮するのは、異なる2種類のコストを混同することです。環境の一括作成と回収は、本来、環境層のツールで一元管理すべきです。PurpleMarkのように環境単位でセッションとキャッシュを分離すれば、上位層のタスクや実行器を柔軟にスケジュールできます。
最後に一つ。コスト削減を規約違反の方向へ進めないでください。クォータ節約のために非公式なサービスを使ったり、リクエスト頻度を上げて無理に処理量を押し上げたりしないことです。レート制限が発生すると、繰り返しのリトライは制御されたペースで実行するより多くのクォータを消費します。


