
云主机、云浏览器按时间计费,批量任务最容易在配额上翻车。估算消耗、确定并发上限、超额后的补救顺序,是三个能提前做的动作,也是这篇要讲清的事。
按时计费的资源,账单逻辑很直白:运行时长乘以实例数。配额是硬上限,撞上去之后任务不是变慢,而是直接失败——新实例创建不出来,跑着的实例被回收,接口开始返回限流错误。搞清楚自己离上限还有多远,比事后加预算有用得多。
先分清哪些消耗是必要的
同一笔配额,花在不同任务上的产出差得很远。先做一轮盘点,按需不需要实时执行把任务分开。
常驻任务是最容易吃掉配额的一类,全天运行,实际有活干的时间可能只有几分钟。把常驻监控改成定时触发,往往能砍掉一大块消耗,业务上几乎感觉不到。集中在特定时段的波峰任务可以错峰,一次性任务按需启动。
然后问自己一句,这个任务延迟六小时执行,业务会受影响吗。会,就留在关键路径上实时跑;不会,就转成低优先级的批处理,放到配额宽松的时段。竞品价格监控从每小时一次改到每天两次,多数场景下的信息价值并没有实质下降。
消耗怎么估,并发怎么定
按实例运行时长计费时,一批任务的总消耗大致等于单个任务的平均时长乘以任务数,跟你把并发开多大无关;并发只决定你多久能跑完。真正和并发有关的是瞬时压力:同时起来的实例越多,越容易撞上资源池的并发上限和平台侧的限流。
所以并发从最小开始试。先跑一个,确认单个任务的平均时长和成功率;再逐步加到几个、十几个,记录失败率和重试次数。某个位置之后失败率明显抬头,那里就是实际可用的上限,再往上加,只会用重试把省下来的时间还回去。
估算时别漏掉隐性时长:登录等待、页面加载、验证步骤、失败重试,这些经常比主流程本身还长。给单个任务留出余量,比精确到分钟更有用。
超额之后是什么样子
配额耗尽的现场不太好认,因为它常常长得像别的问题。
一种表现是任务卡在启动阶段,环境或实例的创建请求被拒,日志里只剩一句语焉不详的失败。另一种是跑到一半被回收,前面的进度白做。还有限流错误、部分成功部分失败、队列越来越长但没人处理。
最容易误判的是假死:实例还在,任务看起来在跑,其实一直卡在等待上,配额也在按时间流逝。遇到这种情况,先看配额使用面板,再拿一个小任务单独试一次。小任务也起不来,方向就在配额或权限上;小任务正常,那就是并发或者环境复用的问题。
补救的顺序
先做不花钱的动作。
第一步停掉低价值的常驻消耗,把监控类任务改成定时。第二步把可延迟的任务挪到配额宽松的时段,让消耗曲线变平。第三步降并发上限、加队列,任务进队列后按容量消费,而不是一起启动。第四步才压无效消耗:同一份资源加缓存不重复拉取,一次请求多拿点数据,注定失败的请求快速退出,不要反复重试。
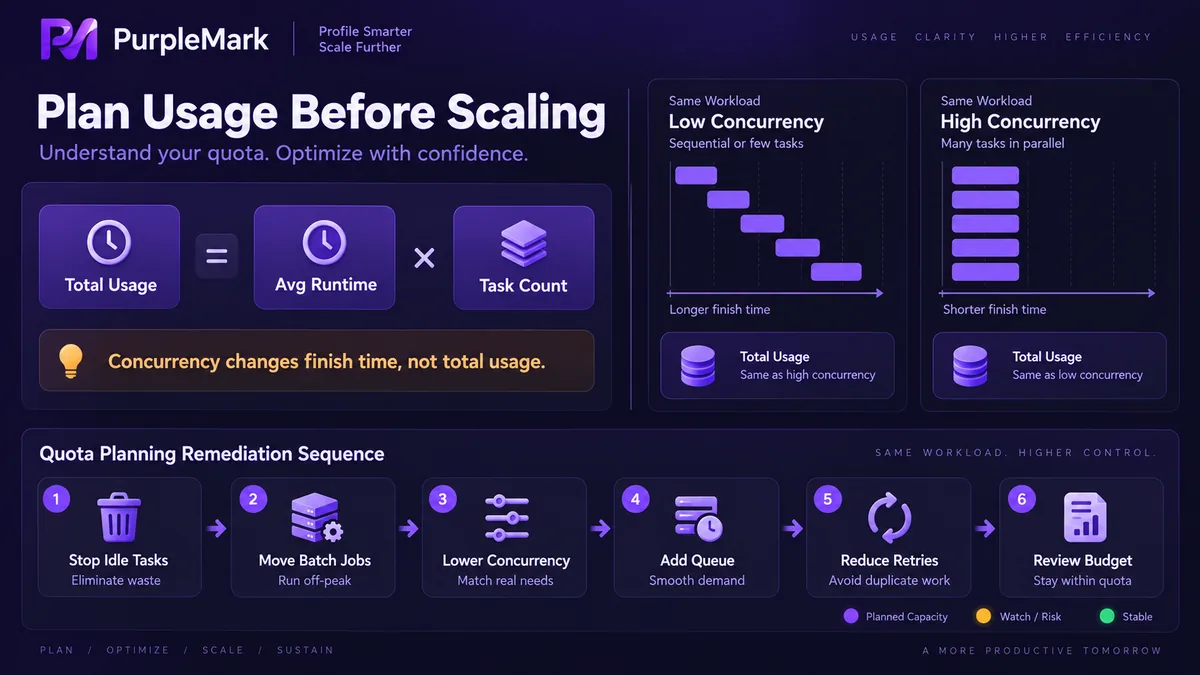
这四步走完再看要不要加预算或者换更高的层级,往往会发现需要的额度比一开始以为的少。反过来,先加预算,会把浪费的习惯一起买下来。
环境层不要跟着一起压缩
省配额时最常见的错误动作,是让多个任务共用一个浏览器环境,理由是同一个环境开一次就够了。
代价立刻出现:会话互相覆盖、登录态被顶掉、缓存串在一起,一个任务失败把其他任务一起拖下去。省下的那点实例时长,会在排查故障和重跑任务上加倍还回去。
这两层该分开看。计算层负责跑任务逻辑,按需调度,追求成本效率;环境层负责身份与隔离,一个任务一个独立环境,追求稳定。因为算力紧张就去压缩环境层,是把两类成本搞混了。批量创建和回收环境这件事本该由环境层的工具统一管,像 PurpleMark 这样按环境隔离会话与缓存,上层的任务和执行器才调度得开。
最后一句提醒:降本别往违规的方向走。不要为了省额度去用非官方渠道的服务,也不要靠提高请求频率硬冲,触发限流之后的重试比按节奏跑更费配额。


