
Cloud-VMs und Cloud-Browser werden nach Zeit abgerechnet, deshalb können Batch-Aufgaben Kontingente schnell ausschöpfen. Verbrauch abschätzen, eine praktikable Parallelitätsgrenze festlegen und bei Überschreitung in der richtigen Reihenfolge gegensteuern.
Bei zeitbasiert abgerechneten Ressourcen ist die Rechnungslogik einfach: Laufzeit mal Anzahl der Instanzen. Das Kontingent ist eine harte Obergrenze. Wird sie erreicht, werden Aufgaben nicht nur langsamer, sondern schlagen direkt fehl: Neue Instanzen lassen sich nicht erstellen, laufende Instanzen werden zurückgeholt und Schnittstellen liefern Drosselungsfehler. Zu wissen, wie weit man noch von der Grenze entfernt ist, ist nützlicher, als im Nachhinein einfach das Budget zu erhöhen.
Zuerst notwendigen von vermeidbarem Verbrauch trennen
Dasselbe Kontingent kann je nach Aufgabe sehr unterschiedlichen Nutzen bringen. Erstellen Sie zunächst eine Bestandsaufnahme und trennen Sie Aufgaben danach, ob sie wirklich in Echtzeit ausgeführt werden müssen.
Dauerläufer gehören zu den größten Kontingentfressern. Sie laufen den ganzen Tag, obwohl sie möglicherweise nur wenige Minuten tatsächlich arbeiten. Wird eine permanente Überwachung auf zeitgesteuerte Ausführung umgestellt, lässt sich oft ein großer Teil des Verbrauchs einsparen, ohne dass das Geschäft spürbar beeinträchtigt wird. Lastspitzen zu bestimmten Zeiten können verschoben werden, einmalige Aufgaben starten nur bei Bedarf.
Stellen Sie sich dann eine Frage: Würde es das Geschäft beeinträchtigen, wenn diese Aufgabe sechs Stunden später ausgeführt wird? Wenn ja, bleibt sie auf dem kritischen Pfad und läuft in Echtzeit. Wenn nein, wird sie zu einem Batch mit niedriger Priorität und in Zeiten mit mehr freiem Kontingent verschoben. Eine Wettbewerber-Preisüberwachung statt stündlich nur zweimal täglich auszuführen, verringert den Informationswert in den meisten Fällen nicht wesentlich.
Verbrauch schätzen und Parallelität festlegen
Bei Abrechnung nach Instanzlaufzeit entspricht der Gesamtverbrauch eines Batches ungefähr der durchschnittlichen Dauer einer Aufgabe multipliziert mit der Anzahl der Aufgaben. Wie hoch die Parallelität eingestellt ist, ändert daran nichts; sie bestimmt nur, wie schnell der Batch fertig wird. Von der Parallelität hängt dagegen die momentane Belastung ab: Je mehr Instanzen gleichzeitig starten, desto eher stößt man an die Parallelitätsgrenze des Ressourcenpools oder an Plattform-Drosselungen.
Beginnen Sie deshalb mit der kleinsten Parallelität. Führen Sie zuerst eine Aufgabe aus und prüfen Sie deren durchschnittliche Dauer und Erfolgsrate. Erhöhen Sie dann schrittweise auf einige und schließlich auf etwa ein Dutzend parallele Aufgaben und protokollieren Sie Fehlerrate und Wiederholungen. Steigt die Fehlerrate ab einem bestimmten Punkt deutlich, liegt dort die praktisch nutzbare Obergrenze. Noch mehr Parallelität gibt den gewonnenen Zeitvorteil durch zusätzliche Wiederholungen wieder zurück.
Vergessen Sie bei der Schätzung keine versteckten Zeiten: Warten auf Anmeldung, Seitenladezeiten, Verifizierungsschritte und fehlgeschlagene Wiederholungen dauern oft länger als der eigentliche Hauptablauf. Ein Zeitpuffer pro Aufgabe ist nützlicher als eine minutengenaue Rechnung.
Wie sich ein ausgeschöpftes Kontingent zeigt
Ein ausgeschöpftes Kontingent ist nicht immer leicht zu erkennen, weil die Symptome oft wie andere Probleme aussehen.
Ein mögliches Symptom ist, dass eine Aufgabe schon beim Start hängen bleibt, weil die Erstellung einer Umgebung oder Instanz abgelehnt wird und im Protokoll nur ein vager Fehler steht. In einem anderen Fall wird eine Instanz mitten in der Ausführung zurückgeholt und der bisherige Fortschritt geht verloren. Ebenso können Drosselungsfehler auftreten, einige Aufgaben gelingen und andere scheitern oder die Warteschlange wächst, ohne abgearbeitet zu werden.
Besonders leicht wird ein scheinbares Hängen falsch diagnostiziert: Die Instanz existiert noch und die Aufgabe sieht aktiv aus, wartet aber tatsächlich dauerhaft, während das Kontingent weiter zeitbasiert verbraucht wird. Prüfen Sie dann zuerst die Kontingentanzeige und testen Sie anschließend eine kleine Aufgabe separat. Startet auch sie nicht, liegt die Ursache eher bei Kontingent oder Berechtigungen. Läuft sie normal, sind Parallelität oder die Wiederverwendung von Umgebungen wahrscheinlicher.
Reihenfolge der Gegenmaßnahmen
Beginnen Sie mit Maßnahmen, die nichts kosten.
Erstens: Niedrigwertige Dauerverbräuche stoppen und Überwachungsaufgaben zeitgesteuert ausführen. Zweitens: Verzögerbare Aufgaben in Zeiten mit mehr freiem Kontingent verschieben und so die Verbrauchskurve glätten. Drittens: Parallelitätsgrenze senken und eine Warteschlange hinzufügen, damit Aufgaben entsprechend der verfügbaren Kapazität abgearbeitet werden, statt alle gleichzeitig zu starten. Viertens: Unnötigen Verbrauch reduzieren—gemeinsame Ressourcen zwischenspeichern statt mehrfach abrufen, pro Anfrage nach Möglichkeit mehr Daten holen, sicher scheiternde Anfragen früh abbrechen und nicht endlos wiederholen.
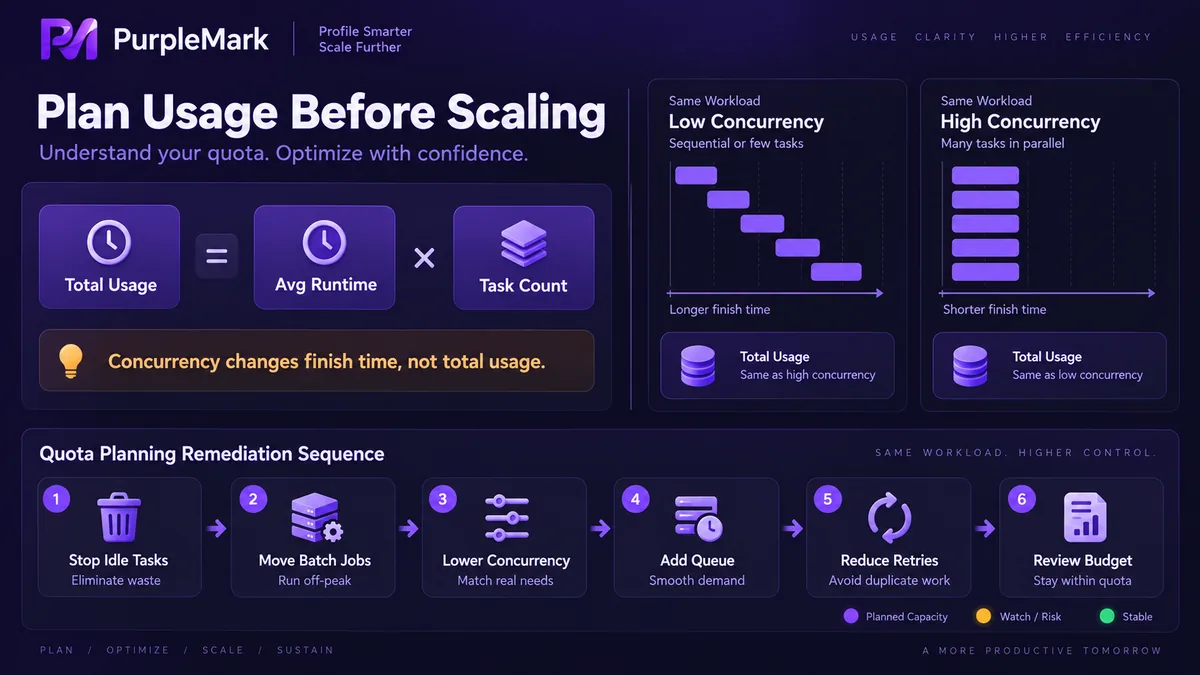
Prüfen Sie erst nach diesen vier Schritten, ob ein höheres Budget oder eine höhere Stufe nötig ist. Häufig zeigt sich, dass das tatsächlich benötigte Kontingent kleiner ist als zunächst gedacht. Wer zuerst das Budget erhöht, finanziert dagegen auch ineffiziente Gewohnheiten weiter.
Die Umgebungsebene nicht zusammen mit der Rechenebene komprimieren
Ein häufiger Fehler beim Sparen von Kontingent besteht darin, mehrere Aufgaben dieselbe Browserumgebung nutzen zu lassen, weil eine einmal gestartete Umgebung angeblich ausreichen sollte.
Die Nachteile zeigen sich sofort: Sitzungen überschreiben sich, Anmeldestatus werden verdrängt, Caches vermischen sich und ein Fehler in einer Aufgabe kann andere mitreißen. Die geringe Einsparung an Instanzlaufzeit wird bei Fehlersuche und erneuten Läufen mehrfach wieder ausgegeben.
Beide Ebenen sollten getrennt betrachtet werden. Die Rechenebene führt die Aufgabenlogik aus, plant Arbeit nach Bedarf und optimiert auf Kosteneffizienz. Die Umgebungsebene ist für Identität und Isolation zuständig; jede Aufgabe erhält eine unabhängige Umgebung, um Stabilität zu erreichen. Die Umgebungsebene wegen knapper Rechenleistung zu verdichten, vermischt zwei verschiedene Kostenarten. Das massenhafte Erstellen und Zurücknehmen von Umgebungen sollte zentral durch Werkzeuge der Umgebungsebene verwaltet werden. Wenn PurpleMark Sitzungen und Caches pro Umgebung isoliert, lassen sich Aufgaben und Ausführer der oberen Ebene flexibler planen.
Zum Schluss: Kostensenkung darf nicht in Regelverstöße führen. Nutzen Sie keine inoffiziellen Dienste nur zum Sparen von Kontingent und versuchen Sie nicht, mit höherer Anfragefrequenz mehr Durchsatz zu erzwingen. Sobald Drosselungen greifen, verbrauchen Wiederholungen meist mehr Kontingent als ein kontrolliertes Tempo.


