
越境運用にAIを組み込む際、ツールを増やすだけでは工程間の受け渡しが手作業のままになりがちです。商品リサーチ、コンテンツ制作、カスタマーサポート、データ分析を分担し、アカウントと環境も分離すると、全体の運用は大幅に安定します。
越境運用でよく起きる失敗は、ツール選びそのものではなく、すべてのツールを同じ環境、同じPC、同じブラウザに詰め込むことです。商品リサーチ、コンテンツ制作、カスタマーサポート、データ分析では必要なツールが異なり、必要なアカウントの識別情報も同じとは限りません。混在させるほど、問題は重なっていきます。
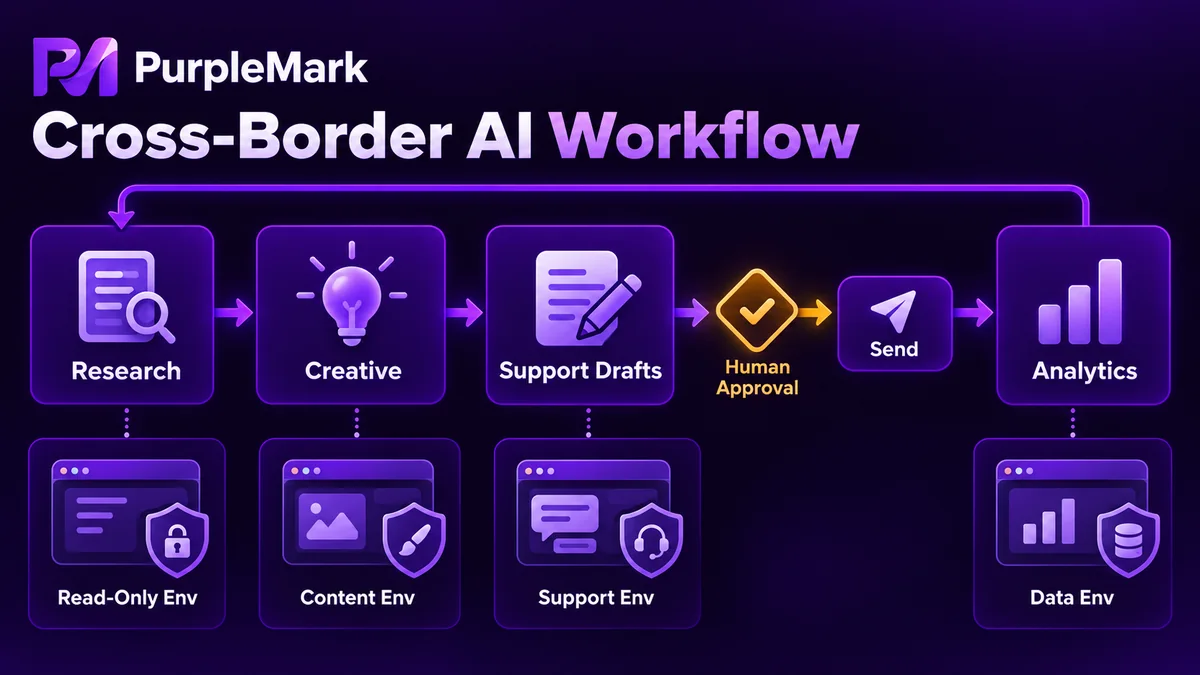
商品リサーチ:ページを読み、構造化した結果を出せるツール
この工程では、オンライン検索、ページの読み取り、情報の集約が必要です。対象サイトの商品ページ、レビュー、ランキングを読み、公開情報を表形式に整理できるツールが向いています。たとえば価格帯の分布、レビューで頻出する不満、同一カテゴリ内の競争密度などです。
最初に境界を決めます。対象サイトのrobotsルールと利用規約を守り、個人情報を収集せず、リクエスト頻度を制御し、相手側サービスの通常運用を妨げないようにします。調査段階は読み取り専用なので、環境要件は比較的緩やかです。ただし出口地域は対象市場と合わせる必要があります。そうしないと表示されるページ、価格、在庫が異なり、結論そのものが誤る可能性があります。
コンテンツ制作:1つの素材を複数プラットフォーム向けに書き換える
コピー、画像、短尺動画の台本などは、生成系ツールとテンプレート化したプロセスの組み合わせに向いています。複数プラットフォーム運用で時間がかかるのは、最初の原稿を書くことより、同じ商品情報をInstagram、X、LinkedInそれぞれのトーンと長さに合わせて作り替えることです。この書き換えをモデルに任せ、人は最終稿だけを確認します。
素材自体にも統一した置き場所が必要です。画像や動画は同じワークスペースに保存し、公開時に直接参照できるようにします。複数のツール間でファイルを往復させたり、何度も正しいバージョンを探したりしない形が理想です。
カスタマーサポートとメール:下書きまで、送信は人が行う
返信文やサポート文面は、文脈を読めるモデルに向いていますが、フローは必ず下書きで止めます。約束、返品、交換、価格に関わる内容は、人が確認してから送信します。送信された時点でアカウントとしての発言になるため、この確認工程は省けません。
この工程ではアカウントの識別情報を使うため、他の工程とは環境を分けます。カスタマーサポート用アカウントの環境では、データ収集タスクや一括投稿を実行しません。識別情報が混在すると、サポート側の1つの異常が運用側にも波及する可能性があります。
データ分析:先に構造化し、その後で傾向を見る
投稿結果、リーチ、エンゲージメント、コンバージョンは、ログテキストだけを残すのではなく、日付、プラットフォーム、アカウント単位で表にして保存します。ログは問題調査には向きますが、どの種類のコンテンツが有効か、どのアカウントが悪化しているかを判断する用途には向きません。この層の出力は、次のサイクルの入力として商品リサーチやコンテンツ制作に戻します。
準備、公開、振り返りまでを同じワークスペースで連続して実行することは可能です。見た目は1つの連続した対話でも、裏側では異なるツールがそれぞれの作業を行い、状態と結果を介してつながっています。
アカウントと環境をどう分けるか
意図的な設計が必要なのはこの層です。原則は1つだけです。すべてのツールを同じ環境に詰め込まないことです。
- 1つの事業ラインに対して、比較的固定した1つの環境を用意します。独立した出口、整合したタイムゾーンと言語設定、独立したローカルデータを持たせ、コンテンツ、広告、カスタマーサポートの各アカウントは別々のコンテナに配置します
- 性質の異なる操作には異なる環境を使います。読み取り専用の収集、アカウント運用、一括投稿を混在させると、ログイン状態やセッションが干渉し、1つの異常が全体に影響しやすくなります
- 環境とアカウントを固定的に紐づけて記録します。誰がどれくらい使っているかを追跡できれば、引き継ぎやトラブル調査の根拠になります
環境数が増えると、手作業でウィンドウを開き、紐づけ関係を記録する方法は現実的ではありません。PurpleMarkは独立環境と一括管理機能を提供します。各アカウントを1つの環境に固定し、グループ単位で起動して状態を確認できるため、環境と出口をスケジュール可能なリソースとして扱えます。
もう1つ明確にすべき点があります。ツールは原則として下書きまでにし、公開ボタンは人が押します。これは無人で動くマトリクス型の一括制御ではありません。何を、いつ公開し、アカウントをどう使うかは利用者の責任であり、プラットフォームのルールと自動化の境界も自分で守る必要があります。
4つの工程を一度に全部つなげない
まず、手順が明確で毎日繰り返すタスクを1つ選び、最初から最後まで安定して動かします。最初の目標はプロセス全体を完成させることではなく、環境の安定性を検証することです。次に、手順を計画できるモデルにフローを動かさせ、異常時の処理が十分に信頼できるかを確認します。その後に構造化データの層を追加し、最後に同じ環境とデータ基盤の上で他の工程へ広げます。こうすれば、新しい工程を追加するたびに環境管理やデータ保存を作り直す必要がなく、レイヤー化の利点が見えてきます。
ツールそのものの違いより、環境の配置方法の違いのほうが、実際には影響が大きいことがあります。


