
Під час підключення ШІ до транскордонних операцій часто просто накопичують інструменти, а переходи між етапами залишаються ручними. Поділ дослідження товарів, контенту, підтримки й аналізу даних, а також окремі акаунти та середовища роблять процес значно стабільнішим.
Найпоширеніша проблема в транскордонних операціях — не неправильний вибір інструмента, а запуск усіх інструментів в одному середовищі, на одному комп’ютері та в одному браузері. Дослідження товарів, створення контенту, підтримка клієнтів і аналіз даних потребують різних інструментів, а часто й різних ідентичностей акаунтів. Якщо все змішати, проблеми накладаються одна на одну.
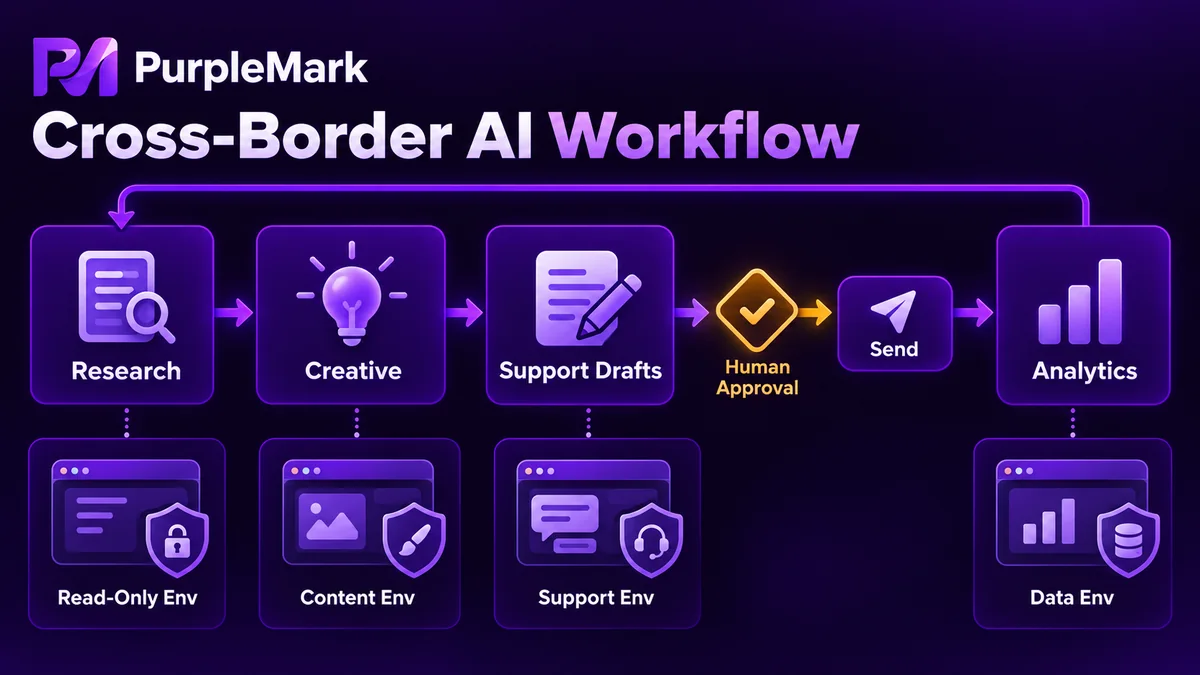
Дослідження товарів: інструменти, що читають сторінки й повертають структуровані результати
На цьому етапі потрібні пошук в інтернеті, читання сторінок і узагальнення інформації. Підходять інструменти, які можуть читати сторінки товарів, відгуки та рейтинги на цільових сайтах і впорядковувати публічні дані в таблиці: розподіл цінових діапазонів, часті скарги у відгуках і щільність конкуренції в одній категорії.
Спочатку потрібно визначити межі. Слід дотримуватися правил robots і умов використання цільових сайтів, не збирати персональні дані, контролювати частоту запитів і не заважати нормальній роботі сервісу. Дослідження працює лише на читання, тому вимоги до середовища тут відносно м’які. Проте регіон виходу має відповідати цільовому ринку, інакше сторінки, ціни та запаси можуть відрізнятися, а висновки стануть неправильними.
Виробництво контенту: одне джерело, версії для різних платформ
Тексти, зображення та сценарії коротких відео добре підходять для генеративних інструментів у поєднанні з шаблонним процесом. У роботі з кількома платформами найбільше часу зазвичай займає не перший варіант, а адаптація тієї самої інформації про товар для Instagram, X і LinkedIn, де відрізняються тон і довжина. Модель може зробити ці переписування, а людина — перевірити фінальну версію.
Самим матеріалам також потрібне єдине місце. Зберігайте зображення та відео в одному робочому просторі, щоб під час публікації посилатися на них безпосередньо, а не переносити файли між кількома інструментами й постійно шукати потрібну версію.
Підтримка та електронна пошта: лише чернетки, надсилає людина
Відповіді й тексти підтримки добре підходять для моделей, які читають контекст, але процес має зупинятися на чернетці. Усе, що стосується зобов’язань, повернень, обмінів або цін, перед надсиланням повинна перевірити людина. Після надсилання повідомлення говорить від імені акаунта, тому цей контрольний етап прибирати не можна.
На цьому етапі використовується ідентичність акаунтів, тому його середовище слід відокремити від інших. У середовищі акаунтів підтримки не варто запускати збір даних або масові публікації. Якщо ідентичності змішуються, одна аномалія на боці підтримки може вплинути на операційну частину.
Аналіз даних: спочатку структура, потім тенденції
Результати публікацій, охоплення, взаємодії та конверсії слід архівувати в таблицях за днями, платформами й акаунтами, а не зберігати лише великі масиви текстових логів. Логи корисні для пошуку проблем, але не для відповіді, який тип контенту працює або який акаунт погіршується. Результати цього шару мають повертатися до дослідження товарів і створення контенту як вхідні дані для наступного циклу.
Підготовку, публікацію та розбір результатів можна безперервно виконувати в одному робочому просторі. Зовні це виглядає як одна безперервна розмова, хоча у фоновому режимі різні інструменти все одно виконують окремі завдання й передають один одному стани та результати.
Як розподілити акаунти та середовища
Саме цей шар потрібно проєктувати свідомо. Головне правило одне: не розміщуйте всі інструменти в одному середовищі.
- Для кожної бізнес-лінії потрібне відносно постійне середовище з власним виходом, узгодженими часовим поясом і мовою та окремими локальними даними. Контентні, рекламні й сервісні акаунти слід розміщувати в різних контейнерах
- Для операцій різного характеру використовуйте різні середовища. Якщо змішати збір даних лише на читання, роботу з акаунтами й масову публікацію, стани входу та сесії можуть конфліктувати, а одна аномалія вплине на все
- Середовища потрібно стабільно прив’язувати до акаунтів і фіксувати ці зв’язки. Має бути видно, хто і як довго використовує середовище, щоб передавання роботи та діагностика мали основу
Коли середовищ стає багато, вручну відкривати вікна й записувати зв’язки з акаунтами вже непрактично. PurpleMark надає незалежні середовища та можливості пакетного керування. Кожен акаунт можна закріпити за одним середовищем, запускати середовища за групами та перевіряти їхній стан, використовуючи середовища й виходи як ресурси для планування.
Ще одну межу треба проговорити чітко: за замовчуванням інструменти повинні доходити лише до чернетки, а кнопка публікації залишається в руках людини. Це не автономне матричне керування акаунтами. Що публікувати, коли публікувати і як використовувати акаунти — відповідальність користувача; він також має дотримуватися правил платформ і меж автоматизації.
Не підключайте всі чотири етапи одразу
Почніть з одного чітко визначеного завдання, яке повторюється щодня, і доведіть його до стабільної роботи. Спершу перевірте стабільність середовища; повнота всього процесу на цьому етапі не є метою. Потім нехай модель, здатна планувати кроки, керує процесом, а ви спостерігайте, наскільки надійно вона обробляє винятки. Далі додайте шар структурованих даних і лише після цього розширюйте систему на інші етапи поверх тієї самої основи середовища та даних. Так новий етап не вимагатиме заново будувати керування середовищами чи сховище даних, а переваги шарової архітектури стануть помітними.
Відмінності між самими інструментами зазвичай впливають менше, ніж спосіб організації середовищ.


