
Bei grenzüberschreitenden Abläufen führt der Einsatz vieler KI-Tools oft zu manuellen Übergaben. Wenn Produktauswahl, Content, Kundenservice und Datenanalyse getrennt organisiert und Konten sowie Umgebungen voneinander isoliert werden, wird der Gesamtprozess deutlich stabiler.
Das häufigste Problem im grenzüberschreitenden Betrieb ist nicht die Wahl des falschen Tools, sondern dass alle Tools in derselben Umgebung, auf demselben Computer und im selben Browser laufen. Produktauswahl, Content-Erstellung, Kundenservice und Datenanalyse brauchen unterschiedliche Werkzeuge und oft auch unterschiedliche Kontoidentitäten. Werden sie vermischt, summieren sich die Probleme.
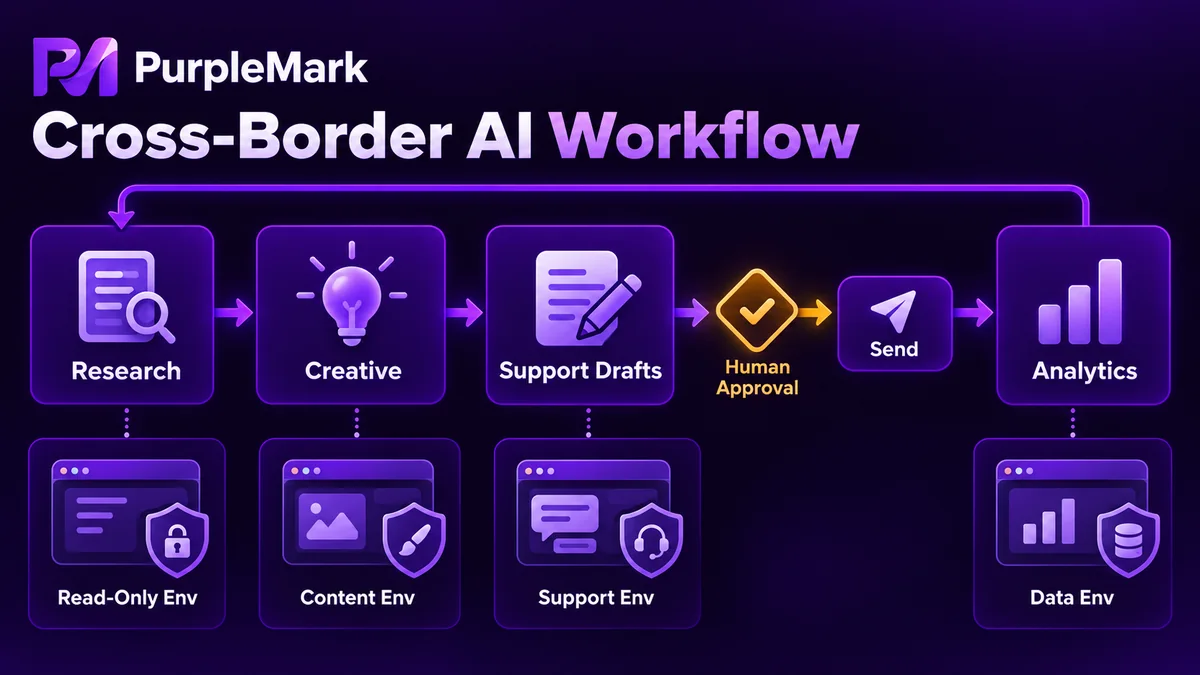
Produktauswahl und Recherche: Tools, die Seiten lesen und strukturierte Ergebnisse liefern
In diesem Schritt werden Websuche, Seitenanalyse und Zusammenfassung benötigt. Geeignet sind Tools, die auf Zielplattformen Produktseiten, Bewertungen und Rankings lesen und öffentliche Informationen tabellarisch aufbereiten, etwa Preisbereiche, häufig genannte Beschwerden und die Wettbewerbsdichte innerhalb einer Kategorie.
Die Grenzen müssen zuerst festgelegt werden. Die robots-Regeln und Nutzungsbedingungen der Zielseiten sind einzuhalten, personenbezogene Daten dürfen nicht gesammelt werden, die Anfragefrequenz muss begrenzt bleiben und der normale Betrieb der Gegenseite darf nicht beeinträchtigt werden. Die Recherche ist nur lesend und stellt daher geringere Anforderungen an die Umgebung. Die Ausgangsregion sollte jedoch zum Zielmarkt passen, sonst können Seiten, Preise und Bestände abweichen und die Schlussfolgerungen werden unzuverlässig.
Content-Produktion: eine Quelle, mehrere plattformspezifische Fassungen
Texte, Bilder und Skripte für Kurzvideos eignen sich für generative Tools in Verbindung mit einem standardisierten Ablauf. Bei der Arbeit auf mehreren Plattformen kostet meist nicht die erste Fassung am meisten Zeit, sondern die Anpassung derselben Produktinformationen für Instagram, X und LinkedIn mit jeweils anderer Tonalität und Länge. Das Modell kann diese Varianten erstellen, während ein Mensch nur die Endfassung prüft.
Auch die Materialien selbst brauchen einen einheitlichen Ablageort. Bilder und Videos sollten im selben Arbeitsbereich liegen und beim Veröffentlichen direkt referenziert werden, statt Dateien zwischen mehreren Tools hin und her zu übertragen oder immer wieder nach der richtigen Version zu suchen.
Kundenservice und E-Mail: nur Entwürfe, Versand durch Menschen
Antworten und Serviceformulierungen eignen sich für Modelle, die Kontext lesen können, doch der Prozess muss beim Entwurf enden. Inhalte zu Zusagen, Rückgaben, Umtausch oder Preisen sollten vor dem Versand von einem Menschen geprüft werden. Nach dem Versand spricht die Nachricht im Namen des Kontos; diese Kontrollstufe darf daher nicht entfallen.
Dieser Schritt arbeitet mit Kontoidentitäten und sollte deshalb in einer von den anderen Aufgaben getrennten Umgebung laufen. In der Umgebung der Kundenservice-Konten sollten weder Datensammlung noch Massenveröffentlichungen stattfinden. Werden Identitäten vermischt, kann eine Auffälligkeit im Servicebereich andere operative Bereiche mitbetreffen.
Datenanalyse: erst strukturieren, dann Trends betrachten
Veröffentlichungsergebnisse, Reichweite, Interaktionen und Conversions sollten nach Tag, Plattform und Konto in Tabellen archiviert werden, statt nur große Mengen an Protokolltext aufzubewahren. Logs helfen bei der Fehlersuche, beantworten aber nicht zuverlässig, welche Inhalte funktionieren oder welches Konto sich verschlechtert. Die Ergebnisse dieser Ebene fließen wieder in Produktauswahl und Content-Produktion ein und bilden den Input für die nächste Runde.
Vorbereitung, Veröffentlichung und Auswertung können fortlaufend in demselben Arbeitsbereich ausgeführt werden. Nach außen wirkt das wie ein durchgehender Dialog, im Hintergrund erledigen jedoch weiterhin verschiedene Tools getrennte Aufgaben und übergeben Status sowie Ergebnisse aneinander.
So werden Konten und Umgebungen aufgeteilt
Gerade diese Ebene muss bewusst gestaltet werden. Es gibt nur einen Grundsatz: Nicht alle Tools in dieselbe Umgebung legen.
- Eine Geschäftslinie erhält eine möglichst feste Umgebung mit eigenem Ausgang, abgestimmter Zeitzone und Sprache sowie getrennten lokalen Daten. Content-, Werbe- und Kundenservice-Konten kommen in unterschiedliche Container
- Unterschiedliche Arten von Vorgängen nutzen unterschiedliche Umgebungen. Werden reine Lesesammlung, Kontobetrieb und Massenveröffentlichung vermischt, können sich Login-Zustände und Sitzungen gegenseitig stören, sodass eine Auffälligkeit alles beeinträchtigt
- Umgebungen werden fest mit Konten verknüpft und dokumentiert. Wer sie wie lange genutzt hat, muss nachvollziehbar sein, damit Übergaben und Fehlersuche eine belastbare Grundlage haben
Wenn die Zahl der Umgebungen steigt, sind manuelles Öffnen von Fenstern und händische Zuordnungslisten nicht mehr praktikabel. PurpleMark bietet isolierte Umgebungen und Funktionen zur Stapelverwaltung. Jedes Konto kann fest einer Umgebung zugeordnet, nach Gruppen gestartet und im Status abgefragt werden, sodass Umgebungen und Ausgänge wie planbare Ressourcen genutzt werden können.
Ein weiterer Punkt muss klar sein: Tools enden standardmäßig beim Entwurf, der Veröffentlichungsbutton bleibt beim Menschen. Das ist keine unbeaufsichtigte Matrixsteuerung. Was veröffentlicht wird, wann es veröffentlicht wird und wie Konten eingesetzt werden, liegt in der Verantwortung des Nutzers; auch Plattformregeln und Grenzen der Automatisierung müssen eingehalten werden.
Nicht alle vier Bereiche auf einmal verbinden
Beginnen Sie mit einer klar definierten, täglich wiederkehrenden Aufgabe und bringen Sie diesen Ablauf zuerst stabil zum Laufen. Zunächst wird nur die Stabilität der Umgebung geprüft; Vollständigkeit des Gesamtprozesses ist noch nicht das Ziel. Danach kann ein Modell, das Schritte planen kann, den Ablauf steuern, wobei besonders der Umgang mit Ausnahmen beobachtet wird. Anschließend kommt die strukturierte Datenschicht hinzu. Erst zum Schluss werden auf derselben Umwelt- und Datenbasis weitere Bereiche ergänzt. So müssen Umgebungsverwaltung und Datenspeicherung bei jedem neuen Schritt nicht neu aufgebaut werden, und der Nutzen der Schichtung wird sichtbar.
Die Unterschiede zwischen den Tools haben meist weniger Einfluss als die Art, wie die Umgebungen organisiert sind.


