
Fertige MCP Server stellen meist nur Grundoperationen bereit; Geschäftsabläufe muss der Agent jedes Mal neu zusammensetzen. Eine schlanke Flask-Adapter-Schicht bündelt Tool-Deklaration, Request-Routing, Ausführung, Rückgaben und Fehlersemantik.
Wer eine Browserumgebung an einen AI Agent anbindet, kommt an einem Punkt nicht vorbei: Standard-Tools liefern nur Grundoperationen, während Geschäftsaktionen selbst zusammengesetzt werden müssen.
Ein konkretes Beispiel: Für einen vollständigen Erfassungslauf lautet der tatsächliche Ablauf „eine Umgebung für eine Region starten, den Ausgang binden, einmal zum Aufwärmen zugreifen und prüfen, ob der Ausgang funktioniert“ – erst danach übernimmt der Agent. Ein fertiger MCP Server bietet meist nur Einzelschritte wie Umgebung starten, navigieren, klicken oder Screenshot erstellen. Die obige Kombinationslogik übernimmt niemand. Der Agent muss sie jedes Mal von Grund auf planen; das ist langsam, und bei jedem Fehler in einem Zwischenschritt muss er selbst entscheiden, wie es weitergeht.
Genau dafür ist die Adapter-Schicht da: Kombinationslogik, Validierung und Zustand bleiben auf der eigenen Seite, nach außen wird nur eine Geschäftsaktion bereitgestellt.
Minimale lauffähige Struktur
Eine lauffähige Adapter-Schicht braucht nur drei Teile: Tool-Deklarationen, Request-Routing sowie Ausführung mit Rückgabe. Mit Flask passt das alles in einen Prozess.
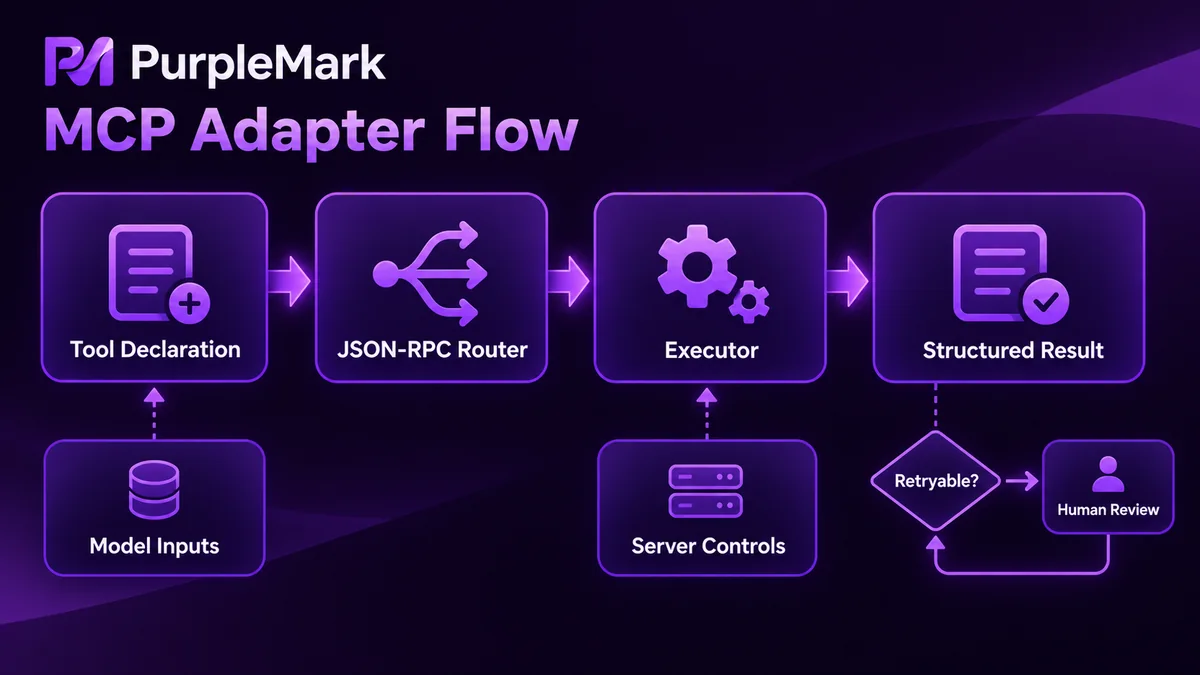
Zuerst die Tool-Deklarationen: Sie bestimmen, was der Agent sehen kann.
# adapter/tools.py
TOOLS = [
    {
        "name": "prepare_environment",
        "description": "Eine verfügbare Umgebung für eine Region vorbereiten und anschließend die Umgebungs-ID zurückgeben",
        "inputSchema": {
            "type": "object",
            "properties": {
                "region": {"type": "string", "description": "Ausgangsregion, z. B. US-CA"},
                "purpose": {"type": "string", "description": "Zweckkennzeichnung für Wiederverwendung und Quotenstatistik"},
                "timeout": {"type": "integer", "minimum": 10, "maximum": 120, "default": 60},
            },
            "required": ["region"],
            "additionalProperties": False,
        },
    },
    {
        "name": "open_page",
        "description": "Eine Seite in der angegebenen Umgebung öffnen und warten, bis sie interaktiv ist",
        "inputSchema": {
            "type": "object",
            "properties": {
                "env_id": {"type": "string"},
                "url": {"type": "string"},
            },
            "required": ["env_id", "url"],
            "additionalProperties": False,
        },
    },
]
Der Router verteilt die JSON-RPC-Methoden. Der Client fragt zuerst tools/list ab und ruft anschließend tools/call anhand des Namens auf.
# adapter/app.py
from flask import Flask, request, jsonify
from adapter.tools import TOOLS
from adapter.runner import run_tool

app = Flask(__name__)

@app.post("/mcp")
def mcp():
    req = request.get_json(force=True)
    method, rid = req.get("method"), req.get("id")

    if method == "tools/list":
        return jsonify({"jsonrpc": "2.0", "id": rid, "result": {"tools": TOOLS}})

    if method == "tools/call":
        name = req["params"]["name"]
        args = req["params"].get("arguments", {})
        return jsonify({"jsonrpc": "2.0", "id": rid, "result": run_tool(name, args)})

    return jsonify({"jsonrpc": "2.0", "id": rid,
                    "error": {"code": -32601, "message": "method not found"}})
Die Ausführungsschicht ist die einzige Stelle, die die Umgebungs-API und das Seitenprotokoll berührt. Mehrstufige Abläufe werden hier ausgeführt, und Fehler werden hier in ein einheitliches Format überführt.
# adapter/runner.py
def run_tool(name, args):
    try:
        payload = HANDLERS[name](**args)
        return ok(payload)
    except ToolError as e:
        return fail(e.code, e.retryable, e.message)
Das Rückgabeformat sollte früh festgelegt werden. Rohe Low-Level-Ausnahmen gehören nicht an den Agent; er versucht sonst, diese Strings zu interpretieren, und kann daraus merkwürdige Entscheidungen ableiten. Sinnvoll ist eine Struktur mit Ergebniscode, etwa {"ok": false, "code": "env_unavailable", "retryable": true, "attempts": 3}. Dann muss der Agent nur zwei Dinge beurteilen: Kann er erneut versuchen, und muss der Fall an einen Menschen übergeben werden?
Parameter sinnvoll entwerfen
Die Granularität von Tools sollte sich an Geschäftsaktionen orientieren, nicht an Schnittstellen. Jeden einzelnen Low-Level-Endpunkt als eigenes Tool zu kapseln, ist praktisch keine Abstraktion; der Agent muss die Reihenfolge weiterhin selbst festlegen.
Bei Parametern gibt es eine klare Trennlinie: was das Modell entscheiden soll und was die Adapter-Schicht selbst entscheidet. Region, Zweck und Ziel-URL gehören zur ersten Gruppe und werden vom Modell geliefert. Debug-Port, interne Queue-Namen und die Auswahl des Umgebungspools gehören zur zweiten Gruppe; sie sollten nicht im Schema auftauchen, sonst werden sie früher oder später falsch befüllt.
Selektoren sind eine typische Fehlerquelle. Ändert sich die Seitenstruktur, können fest verdrahtete Selektor-Aufrufe reihenweise ausfallen. Besser ist, wenn das Modell semantische Ziele übergibt, etwa relativ stabile Kennzeichnungen wie „Anmeldebutton“, während die Selektor-Zuordnung in der Adapter-Schicht gepflegt wird. Dann genügt bei Änderungen eine Anpassung an einer Stelle.
Numerische Parameter brauchen immer Obergrenzen. Haben Timeout, Anzahl der Wiederholungen oder Seitenzahl im Schema kein maximum, kann das Modell einen sehr großen Wert übergeben und aus einem einzelnen Aufruf einen mehr als zehn Minuten langen Vorgang machen. Jedes Tool mit Schleifenlogik braucht ein eindeutiges Ende. Ein Feld wie max_pages begrenzt den Ablauf besser als die Anweisung „weiterblättern, bis keine Daten mehr kommen“.
Auch Idempotenz ist wichtig. Der Aufrufer kann eine task_id mitsenden; wiederholte Requests geben dann direkt das vorherige Ergebnis zurück und verhindern, dass der Agent bei einem Retry eine zweite Umgebung startet.
Rückgabewerte sollten klein bleiben. Screenshots nicht als base64 zurückgeben, sondern als Dateireferenz. Listenergebnisse sollten count und ein Kürzungskennzeichen enthalten, statt die komplette Tabelle in den Kontext zu laden.
Beim Debugging zuerst diese drei Stellen prüfen
Bei stdio belegt JSON-RPC stdout; deshalb dürfen Logs niemals auf stdout geschrieben werden. Schon ein beiläufiges print kann die Protokollanalyse sofort zerstören und lange Fehlersuche auslösen. Logs gehören konsequent nach stderr oder in eine Datei.
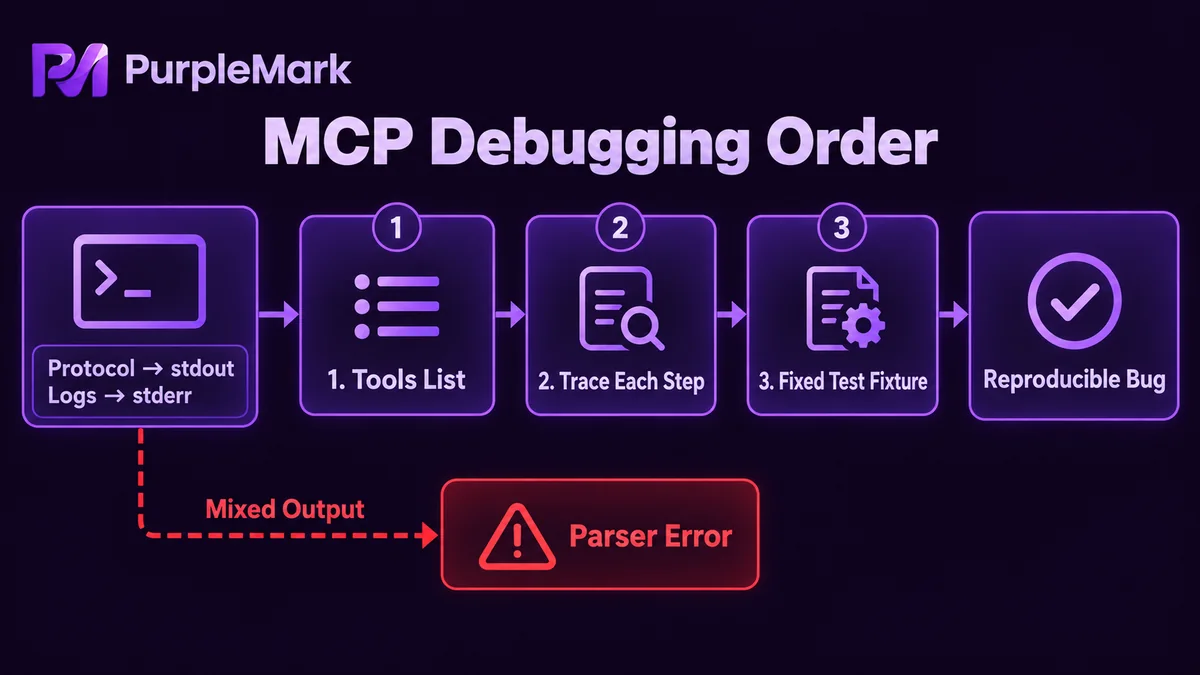
tools/list ist der erste Kontrollpunkt. Wenn die Deklarationen nicht geladen wurden, finden alle späteren Aufrufe gar nicht statt. Zuerst Tool-Namen, Schema-Struktur und mögliche Blockaden durch additionalProperties prüfen.
Der zweite Kontrollpunkt ist ein schrittweiser Trace. Für jeden Aufruf task_id, Parameterzusammenfassung, Laufzeit und Ergebniscode erfassen. Bei Problemen ist dann sichtbar, ob es beim Starten der Umgebung, beim Navigieren oder bei der Validierung hängt. Für Fehlerfälle die ursprünglichen Parameter speichern, damit sie exakt reproduziert werden können – reproduzierbare Bugs lassen sich deutlich schneller beheben.
Der dritte Kontrollpunkt ist ein Satz fester Fixtures: eine inhaltlich stabile Testseite mit einigen Element-Lokatoren, die sich nicht ändern. Nach jeder Änderung an der Adapter-Schicht einen Smoke-Test laufen zu lassen, ist effizienter als jede mündliche Bestätigung.
Berechtigungsgrenzen
Die Adapter-Schicht ist der Ort mit der höchsten Berechtigungskonzentration im gesamten System: Zugangsdaten, Umgebungen und Seitenaktionen liegen in ihrer Hand. Deshalb muss die Grenze genau hier durchgesetzt werden.
Zugangsdaten gehören in die serverseitige Konfiguration, nicht in Tool-Parameter oder den Modellkontext. Tools sollten nach Risiko getrennt werden: Nur-Lese-Tools wie Screenshots oder Textextraktion sind standardmäßig aktiv; Schreib-Tools wie Klicken, Absenden oder Löschen sind standardmäßig deaktiviert und werden nur für die jeweilige Aufgabe temporär freigeschaltet. So bleibt der mögliche Schaden begrenzt, selbst wenn das Modell falsch entscheidet.
Umgebungen sollten nach Zweck isoliert werden. Unterschiedliche Konten und Aufgaben verwenden unterschiedliche Umgebungen; eine Umgebung wird nicht gemischt genutzt. In Szenarien mit mehreren Konten können Umgebungserstellung, Bindung des Netzwerkausgangs und Zustandsverwaltung an eine spezialisierte Umgebungsschicht delegiert werden. Tools wie PurpleMark trennen genau diese Schicht ab; die Adapter-Schicht übernimmt nur Geschäftslogik und Validierung.
Audit-Logs müssen erhalten bleiben. Es sollte nach Zeit exportierbar sein, welche Aufgabe welche Umgebung genutzt und welche Schreib-Tools aufgerufen hat. Wenn tatsächlich etwas schiefläuft, ist diese Aufzeichnung die einzige Möglichkeit, den Ablauf zu rekonstruieren.
Zum Schluss die klare Grenze: Die Adapter-Schicht darf keinen Weg zum Umgehen von Plattformregeln anbieten. Aktionen wie Massenregistrierung, Umgehung von Verifizierungen oder Identitätsfälschung dürfen weder als Tools verpackt noch als interne Tools getarnt werden. Sobald ein Tool dem Modell zugänglich ist, können Aufrufe automatisch erfolgen; vorher gibt es keinen verlässlichen Sperrpunkt, und nachher lässt sich der Schaden nicht rückgängig machen.
Für Protokollversionen und Felddefinitionen ist die offizielle MCP-Dokumentation maßgeblich.


