
기성 MCP Server는 대개 기본 동작만 제공하므로 Agent가 매번 업무 동작을 다시 조합하고 중간 실패도 직접 판단해야 합니다. 얇은 Flask 어댑터 계층을 두면 도구 선언, 요청 라우팅, 실행 결과, 검증, 오류 의미를 한곳에서 관리할 수 있습니다.
브라우저 환경을 AI Agent에 연결할 때 피할 수 없는 문제가 하나 있습니다. 표준 도구가 제공하는 것은 기본 동작이고, 실제 업무 동작은 직접 조합해야 한다는 점입니다.
구체적인 예를 보겠습니다. 한 번의 수집 작업을 끝까지 수행하려면 실제로는 “지역에 맞는 환경을 열고, 네트워크 출구를 연결하고, 워밍업을 위해 한 번 접속한 뒤, 출구가 정상인지 확인”한 다음에야 Agent에게 작업을 넘깁니다. 기성 MCP Server는 보통 환경 열기, 이동, 클릭, 스크린샷 같은 단일 단계 도구만 제공합니다. 위와 같은 조합 로직을 대신 만들어 주지는 않습니다. Agent는 매번 처음부터 순서를 다시 짜야 하므로 느리고, 중간 단계 하나라도 실패하면 어떻게 처리할지도 스스로 판단해야 합니다.
어댑터 계층은 바로 이 문제를 해결합니다. 조합 로직, 검증, 상태는 자기 쪽에서 보관하고 외부에는 하나의 업무 동작만 노출합니다.
최소 실행 구조
실행 가능한 어댑터 계층에는 세 부분만 있으면 됩니다. 도구 선언, 요청 라우팅, 실행과 반환입니다. Flask를 쓰면 하나의 프로세스 안에 모두 넣을 수 있습니다.
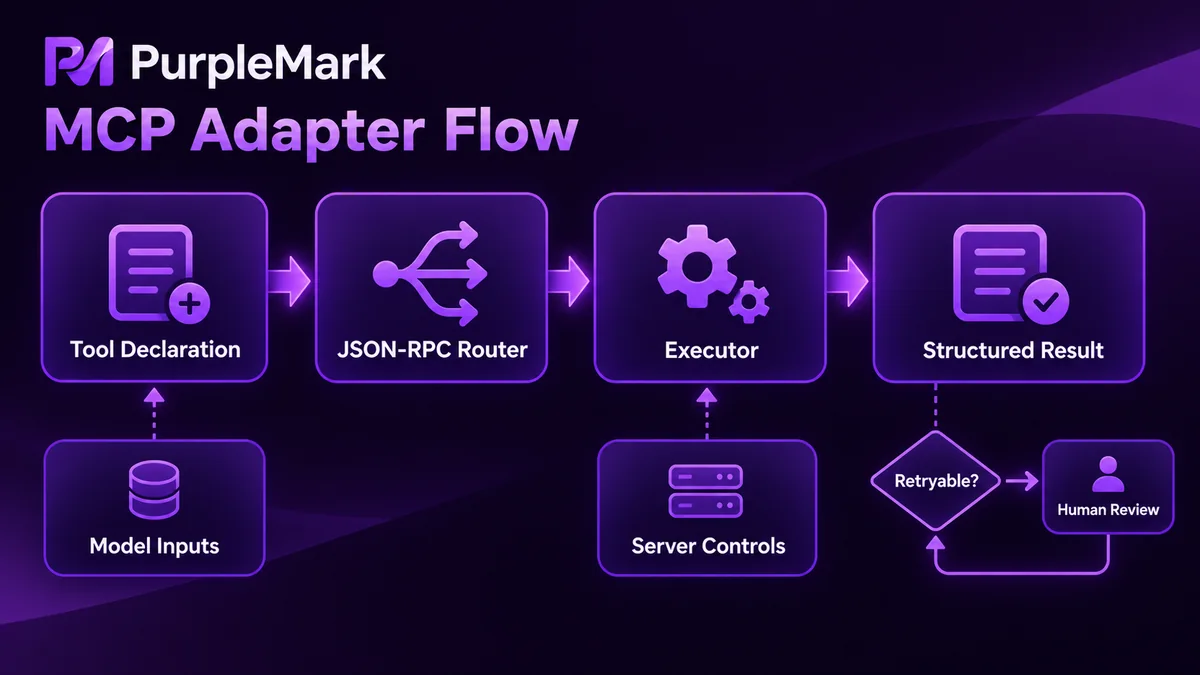
먼저 도구 선언을 봅니다. 이것이 Agent가 볼 수 있는 범위를 결정합니다.
# adapter/tools.py
TOOLS = [
    {
        "name": "prepare_environment",
        "description": "지역에 맞는 사용 가능한 환경을 준비하고 완료되면 환경 ID를 반환",
        "inputSchema": {
            "type": "object",
            "properties": {
                "region": {"type": "string", "description": "네트워크 출구 지역, 예: US-CA"},
                "purpose": {"type": "string", "description": "재사용과 할당량 통계를 위한 용도 라벨"},
                "timeout": {"type": "integer", "minimum": 10, "maximum": 120, "default": 60},
            },
            "required": ["region"],
            "additionalProperties": False,
        },
    },
    {
        "name": "open_page",
        "description": "지정한 환경에서 페이지를 열고 상호작용 가능할 때까지 대기",
        "inputSchema": {
            "type": "object",
            "properties": {
                "env_id": {"type": "string"},
                "url": {"type": "string"},
            },
            "required": ["env_id", "url"],
            "additionalProperties": False,
        },
    },
]
라우터는 JSON-RPC 메서드를 분배합니다. 클라이언트는 먼저 tools/list를 요청한 뒤 이름으로 tools/call을 호출합니다.
# adapter/app.py
from flask import Flask, request, jsonify
from adapter.tools import TOOLS
from adapter.runner import run_tool

app = Flask(__name__)

@app.post("/mcp")
def mcp():
    req = request.get_json(force=True)
    method, rid = req.get("method"), req.get("id")

    if method == "tools/list":
        return jsonify({"jsonrpc": "2.0", "id": rid, "result": {"tools": TOOLS}})

    if method == "tools/call":
        name = req["params"]["name"]
        args = req["params"].get("arguments", {})
        return jsonify({"jsonrpc": "2.0", "id": rid, "result": run_tool(name, args)})

    return jsonify({"jsonrpc": "2.0", "id": rid,
                    "error": {"code": -32601, "message": "method not found"}})
실행 계층은 환경 API와 페이지 프로토콜에 직접 닿는 유일한 곳입니다. 여러 단계의 연결 작업은 여기서 끝내고, 실패도 여기서 통일된 형식으로 바꿉니다.
# adapter/runner.py
def run_tool(name, args):
    try:
        payload = HANDLERS[name](**args)
        return ok(payload)
    except ToolError as e:
        return fail(e.code, e.retryable, e.message)
반환 형식은 일찍 정해 두는 편이 좋습니다. 하위 계층의 원시 예외를 Agent에게 그대로 넘기지 마세요. Agent가 문자열을 해석하려다 엉뚱한 판단을 할 수 있습니다. 예를 들어 {"ok": false, "code": "env_unavailable", "retryable": true, "attempts": 3} 같은 결과 코드 구조를 정해 둡니다. 그러면 Agent는 두 가지만 판단하면 됩니다. 재시도할 수 있는지, 사람에게 넘겨야 하는지입니다.
파라미터는 어떻게 설계할까
도구의 단위는 API가 아니라 업무 동작을 기준으로 나눠야 합니다. 하위 계층 endpoint 하나하나를 도구로 감싸면 사실상 추상화가 없는 것과 같아서 Agent가 여전히 직접 순서를 정해야 합니다.
파라미터에는 분명한 경계가 있습니다. 모델이 결정해야 할 것과 어댑터 계층이 내부에서 결정해야 할 것을 나눕니다. 지역, 용도, 대상 URL은 전자이므로 모델이 채우게 합니다. 디버그 포트, 내부 큐 이름, 어떤 환경 풀을 쓸지는 후자이므로 schema에 넣지 마세요. 넣어 두면 언젠가 모델이 잘못 채우게 됩니다.
selector는 자주 문제를 일으키는 지점입니다. 페이지 구조가 바뀌면 selector를 하드코딩한 호출이 한꺼번에 깨질 수 있습니다. 모델에는 “로그인 버튼”처럼 비교적 안정적인 의미 기반 대상을 전달하게 하고, selector 매핑은 어댑터 계층에서 관리하는 편이 좋습니다. 그러면 페이지가 바뀌어도 한 곳만 수정하면 됩니다.
숫자 파라미터에는 반드시 상한이 있어야 합니다. timeout, 재시도 횟수, 페이지 수에 schema의 maximum이 없으면 모델이 매우 큰 값을 넣어 한 번의 호출이 10분 넘게 이어질 수 있습니다. 반복 의미가 있는 모든 도구에는 명확한 종료점이 필요합니다. “데이터가 없어질 때까지 계속 넘긴다”가 아니라 max_pages 같은 필드로 범위를 닫아야 합니다.
멱등성도 고려해야 합니다. 호출자가 task_id를 전달하게 하면 반복 요청에 이전 결과를 바로 반환할 수 있어 Agent가 retry할 때 환경을 두 번 여는 일을 막을 수 있습니다.
반환값은 최대한 작게 유지합니다. 스크린샷을 base64로 돌려주지 말고 파일 참조를 반환합니다. 목록 결과에는 count와 잘림 표시를 넣고 전체 표를 context에 밀어 넣지 않습니다.
디버깅할 때 먼저 볼 세 곳
stdio를 쓰는 경우 JSON-RPC가 stdout을 사용하므로 로그는 절대 stdout에 쓰면 안 됩니다. 무심코 넣은 print 한 줄이 프로토콜 파싱을 즉시 깨뜨리고 오랫동안 원인을 찾게 만들 수 있습니다. 로그는 stderr나 파일로 통일해서 보냅니다.
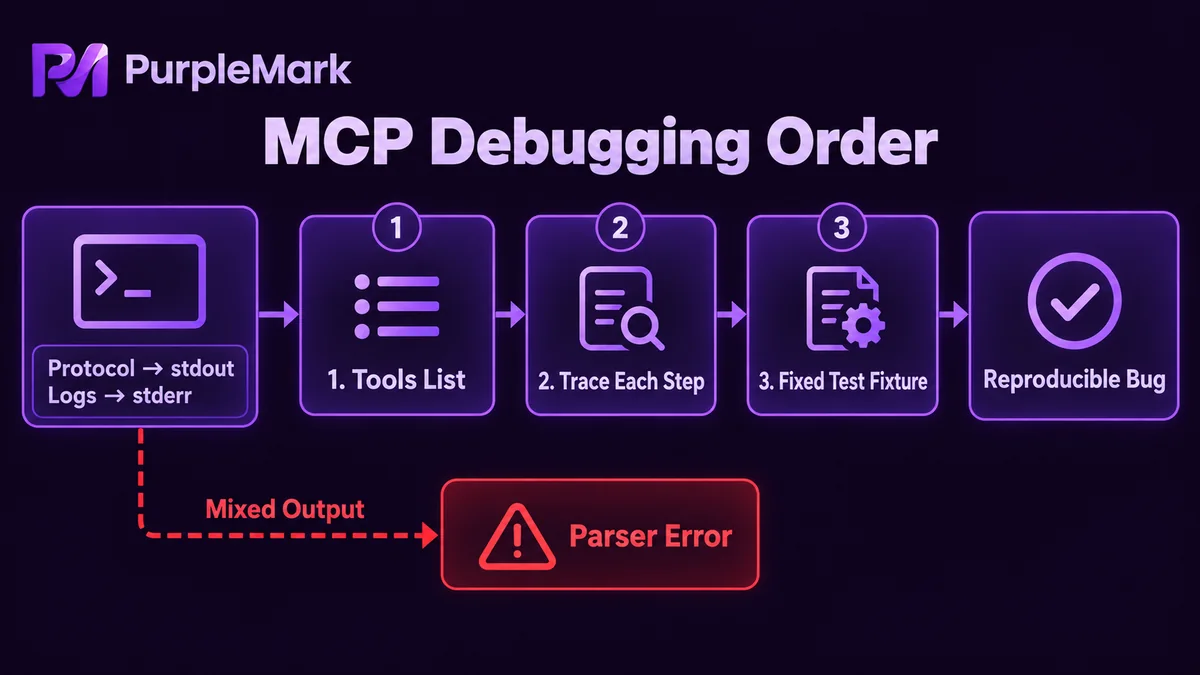
tools/list가 첫 번째 확인 지점입니다. 선언이 읽히지 않으면 이후 호출은 하나도 일어나지 않습니다. 먼저 도구 이름 철자, schema 구조, additionalProperties 가 파라미터를 막고 있는지 확인합니다.
두 번째 확인 지점은 단계별 trace입니다. 호출마다 task_id, 파라미터 요약, 소요 시간, 결과 코드를 기록합니다. 문제가 생기면 환경 열기, 이동, 검증 중 어디에서 막혔는지 알 수 있습니다. 실패 사례의 원래 파라미터를 저장해 그대로 재현할 수 있게 하세요. 재현 가능한 bug가 훨씬 빨리 고쳐집니다.
세 번째 확인 지점은 고정된 fixtures 묶음입니다. 내용이 안정적인 테스트 페이지 하나와 바뀌지 않는 요소 locator 몇 개를 준비합니다. 어댑터 계층을 수정할 때마다 smoke test를 돌리는 편이 어떤 구두 확인보다 효율적입니다.
권한 경계
어댑터 계층은 전체 시스템에서 권한이 가장 집중되는 곳입니다. 자격 증명, 환경, 페이지 조작이 모두 이곳에 있으므로 경계도 여기에서 설정해야 합니다.
자격 증명은 서버 측 설정에 두고 도구 파라미터나 모델 context에는 넣지 않습니다. 도구는 위험도에 따라 나눕니다. 스크린샷, 텍스트 가져오기 같은 읽기 전용 도구는 기본 활성화하고, 클릭, 제출, 삭제 같은 쓰기 도구는 기본 비활성화한 뒤 작업별로 임시 활성화합니다. 이렇게 하면 모델이 판단을 잘못해도 피해 범위가 제한됩니다.
환경은 용도별로 분리합니다. 서로 다른 계정과 서로 다른 작업은 서로 다른 환경을 사용하고, 하나의 환경을 섞어 쓰지 않습니다. 다계정 관리에서는 환경 생성, 네트워크 출구 연결, 상태 유지를 전용 환경 계층에 맡길 수 있습니다. PurpleMark 같은 도구가 이 계층을 분리하며, 어댑터 계층은 업무 로직 조합과 검증만 담당합니다.
감사 로그는 남겨야 합니다. 어떤 작업이 언제 어떤 환경을 사용했고 어떤 쓰기 도구를 호출했는지 시간 기준으로 내보낼 수 있어야 합니다. 실제 문제가 생겼을 때 과정을 복원할 수 있는 유일한 기록입니다.
마지막으로 지켜야 할 선이 있습니다. 어댑터 계층은 플랫폼 규칙을 우회하는 어떤 통로도 제공하면 안 됩니다. 대량 가입, 인증 우회, 신원 위조 같은 동작을 도구로 포장하거나 내부 도구라는 이름으로 달아 두지 마세요. 한 번 도구가 모델에 노출되면 호출은 자동으로 발생할 수 있고, 사전에 확실히 막을 지점도 없으며, 사후에 되돌릴 수도 없습니다.
프로토콜 버전과 필드 정의는 MCP 공식 문서를 기준으로 확인하세요.


