
다중 계정 관리 시스템을 만들 때 가장 먼저 정해야 할 것은 화면이 아니라 디바이스 계층의 필드와 수명주기입니다. 추상화를 잘못 설계하면 계정 수가 늘거나 디바이스 유형이 바뀔 때 상위 기능까지 연쇄적으로 다시 손봐야 합니다.
다중 계정 관리 시스템을 개발할 때 많은 사람은 첫 버전을 화면부터 생각합니다. 계정 목록을 만들고 각 계정에 브라우저 프로필을 연결한 다음, 인터페이스를 호출해 작업하는 방식입니다. 실제 운영이 시작되기 전까지는 충분해 보입니다.
첫 구현은 대개 아주 직접적입니다. 계정 A는 프로필 001을 가리키고, 계정 B는 프로필 002를 가리키며, 계정 C에는 클라우드 폰을 연결합니다. 문제는 세 곳에서 나타납니다. 운영팀이 특정 장비가 고장 났으니 계정 A를 클라우드 폰으로 옮길 수 있느냐고 묻는데, 답은 DB를 수정하고 수작업으로 처리해야 하며 위험도 있다는 것입니다. 새로운 디바이스 소스를 연동하려고 하면 계정 모듈을 리팩터링해야 한다는 결론이 나옵니다. 또는 같은 계정을 오전에는 브라우저 환경에서, 오후에는 클라우드 폰에서 시간대별로 돌리고 싶어도 거의 구현하기 어렵습니다.
이 세 상황은 서로 무관해 보이지만 근본 원인은 하나입니다. 계정 엔터티 안에 원래 계정에 속하지 않는 정보가 들어가 있습니다. 현재 로그인에 사용하는 디바이스, 과거에 사용한 디바이스, 핑거프린트 매개변수, 출구 주소를 모두 계정에 저장합니다. 그 결과 디바이스를 바꾸는 일이 곧 계정을 수정하는 일이 되고, 하나를 바꾸면 전체가 연쇄적으로 영향을 받습니다.
디바이스를 별도의 객체 유형으로 분리하기
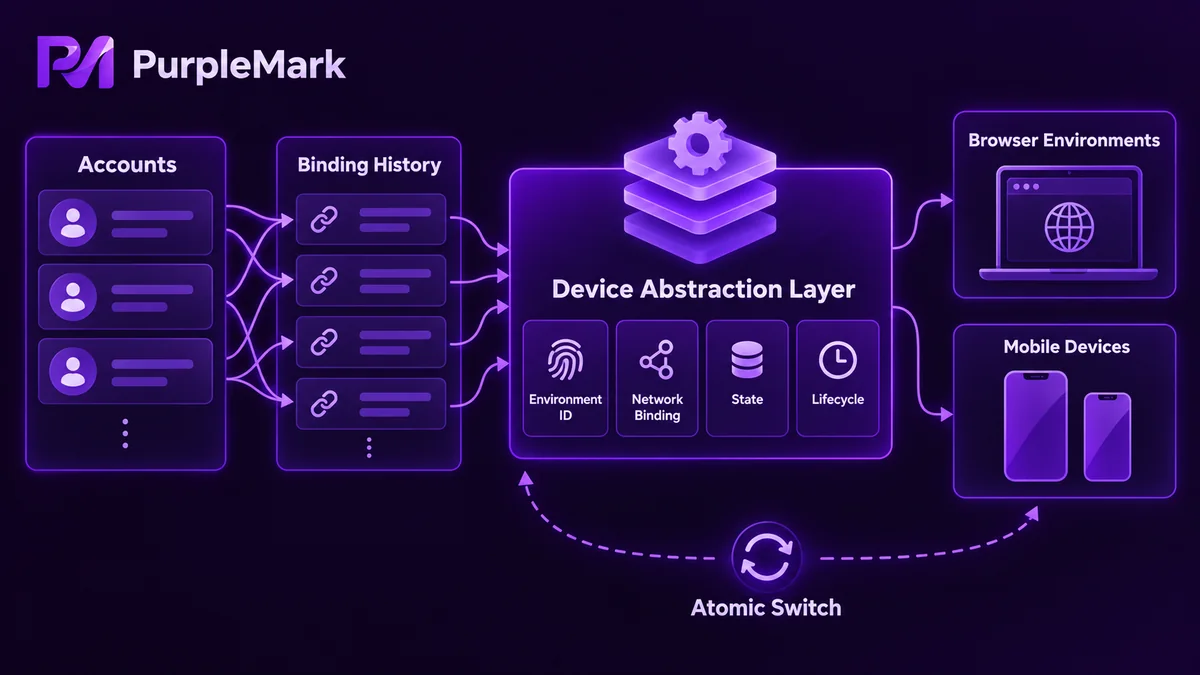
분리한 뒤에는 계정과 디바이스가 다대다 관계여야 합니다. 계정은 핑거프린트를 저장하지 않고 현재 어떤 디바이스에 바인딩되어 있는지만 기록합니다. 디바이스 전환은 원자적 연산으로 만들고, 과거 바인딩 이력은 별도 테이블에 보관하며, 각 디바이스에는 외부에서 유일하게 사용하는 고유 식별자를 부여하고 상태를 실시간으로 조회할 수 있어야 합니다.
이렇게 하는 이유는 모델을 보기 좋게 만들기 위해서가 아닙니다. 운영팀이 원하는 조정과 개발자가 코드를 바꿔야 하는 지점 사이의 거리를 줄이기 위해서이며, 그 거리는 디바이스 수가 늘수록 더 커집니다.
추상화 계층이 명확히 정의해야 할 네 가지 필드 그룹
확장성을 버틸 수 있는 디바이스 추상화는 외부에 네 가지 사항만 설명하면 됩니다.
- 환경 ID: 고유하고 안정적이어야 합니다. 상위 계층은 이 ID로만 환경을 참조하고, 내부 번호, 컨테이너 이름, 프로세스 ID는 외부에 노출하지 않습니다
- 출구 바인딩: 해당 환경이 어느 네트워크 출구를 사용하는지, 그리고 연관된 시간대, 언어, DNS가 하나의 일관된 세트로 구성되는지 나타냅니다. 출구를 별도로 추상화하면 환경 자체를 바꾸지 않고 출구만 교체할 수 있습니다
- 상태: 생성 중, 시작 가능, 실행 중, 작업이 점유 중, 비정상, 회수 대기. 상태 모델이 없으면 풀링과 회수를 제대로 관리할 수 없습니다
- 수명주기: 생성, 시작, 점유, 해제, 회수를 누가 트리거하는지, 작업이 타임아웃되면 어떻게 할지, 환경에 이상이 생기면 누가 마무리할지를 정의합니다
상태와 수명주기를 하나의 필드로 합치는 경우가 많습니다. 가장 간단하지만 동시에 가장 비싼 방식입니다. 상태는 지금 어떤 모습인지 답하고, 수명주기는 다음에 누가 이 자원을 움직일 수 있는지 답합니다. 실제 운영에서 문제는 거의 항상 후자에서 생깁니다. 작업이 죽었는데 아무도 환경을 해제하지 않거나, 환경이 아직 실행 중인데 회수되어 다음 시작 시점에야 출구가 바뀌었다는 사실을 알게 됩니다.
잘못된 추상화의 비용은 확장할 때 드러난다
환경이 열 개일 때는 아무 문제가 없어 보일 수 있습니다. 수십 개, 수백 개가 되면 문제가 한꺼번에 터집니다.
- 새로운 디바이스 유형을 추가할 때 계정 모듈까지 수정해야 해 회귀 테스트 범위가 디바이스 계층에서 계정 계층으로 확대됩니다
- 디바이스를 바꾸려면 DB를 수정해야 하므로 운영팀이 손대기를 꺼리고, 시스템은 점차 개발자만 유지보수할 수 있게 됩니다
- 상태와 점유 기록이 없으면 비정상 종료 후 남은 환경을 아무도 회수하지 않아 좀비 환경이 계속 쌓입니다
- 상위 계층의 작업, 콘텐츠, 자동화가 계정과 디바이스의 일대일 관계를 전제로 만들어져 있으면, 이를 바꾸는 순간 전체 체인을 다시 만들어야 합니다
서로 다른 소스의 디바이스는 구현 방식이 크게 다릅니다. 로컬 브라우저 환경과 클라우드 폰은 사용하는 인터페이스 자체가 다릅니다. 추상화 계층의 역할은 이들을 같은 인터페이스 집합 뒤에 두는 것입니다. 새로운 디바이스 유형을 추가할 때는 시작, 중지, 상태 조회를 구현하는 어댑터 하나를 추가하는 것으로 충분해야 하며, 상위 계층 로직은 바뀌지 않아야 합니다. 추상화가 올바른지 확인하는 간단한 방법도 있습니다. 새 디바이스 유형을 추가할 때 변경해야 하는 코드가 한 파일에만 머무는가를 보면 됩니다.
첫 단계에서는 가능한 한 적게 만들기
기술 모델이 정해지면 화면도 훨씬 자연스럽게 구성됩니다. 메뉴는 설정, 매개변수, 로그가 아니라 계정, 작업, 디바이스 같은 비즈니스 객체를 기준으로 나누는 것이 좋습니다. 화면에서 가장 잘 보여야 하는 것은 상태와 예외입니다. 사용자는 레코드가 몇 개인지가 아니라 문제가 있는지를 찾기 때문입니다.
기능 측면에서 첫 단계에는 디바이스 목록, 디바이스 추가, 그리고 최소한의 종단 간 작업 흐름 하나면 충분합니다. 메뉴는 최대한 줄이고, 먼저 한 가지 일을 처음부터 끝까지 돌아가게 만든 뒤 필요하지 않은 기능은 나중으로 미룹니다.
환경 격리를 처음부터 직접 구현하고 싶지 않다면 기존 기능을 활용할 수도 있습니다. PurpleMark는 독립 환경과 출구 바인딩을 제공하고, 그룹별 일괄 생성과 상태 조회를 지원합니다. 상위 계층에서는 템플릿, 점유, 작업 스케줄링만 구현하면 되므로 개발 역량을 비즈니스 로직에 집중할 수 있습니다.
다중 계정 시스템의 복잡성은 계정 수가 아니라 디바이스 수명주기 관리에 있습니다. 디바이스를 먼저 식별자, 출구, 상태, 수명주기를 가진 자원으로 다루면, 새로운 기능을 추가할 때마다 상위 계층을 다시 뒤엎을 필요가 없습니다.


