
Al crear un sistema de gestión multicuenta, lo primero no debería ser la interfaz, sino los campos y el ciclo de vida de la capa de dispositivos. Una mala abstracción provoca refactorizaciones encadenadas cuando crecen las cuentas o cambian los tipos de dispositivo.
Al desarrollar un sistema de gestión multicuenta, la primera versión suele pensarse desde la interfaz: crear una lista de cuentas, asociar a cada cuenta un perfil de navegador y después llamar a interfaces para operar. Parece suficiente hasta que el sistema entra realmente en funcionamiento.
La primera implementación suele ser muy directa. La cuenta A apunta al perfil 001, la cuenta B al perfil 002 y la cuenta C queda vinculada a un teléfono en la nube. Los problemas aparecen en tres sitios: operaciones dice que una máquina se ha averiado y pregunta si la cuenta A puede moverse al teléfono en la nube, y la única respuesta es modificar la base de datos, hacerlo a mano y asumir el riesgo; se integra una nueva fuente de dispositivos y, al preguntar cómo añadirla, resulta que hay que refactorizar el módulo de cuentas; o se quiere que una misma cuenta use un entorno de navegador por la mañana y un teléfono en la nube por la tarde, algo casi imposible de programar por franjas.
Estos tres escenarios parecen no tener relación, pero comparten una sola causa: la entidad cuenta contiene datos que no le pertenecen. El dispositivo conectado actualmente, los dispositivos usados antes, los parámetros de huella y la dirección de salida se guardan todos en la cuenta. Por eso cambiar de dispositivo equivale a modificar la cuenta y una sola modificación afecta a todo.
El dispositivo debe ser un tipo de objeto independiente
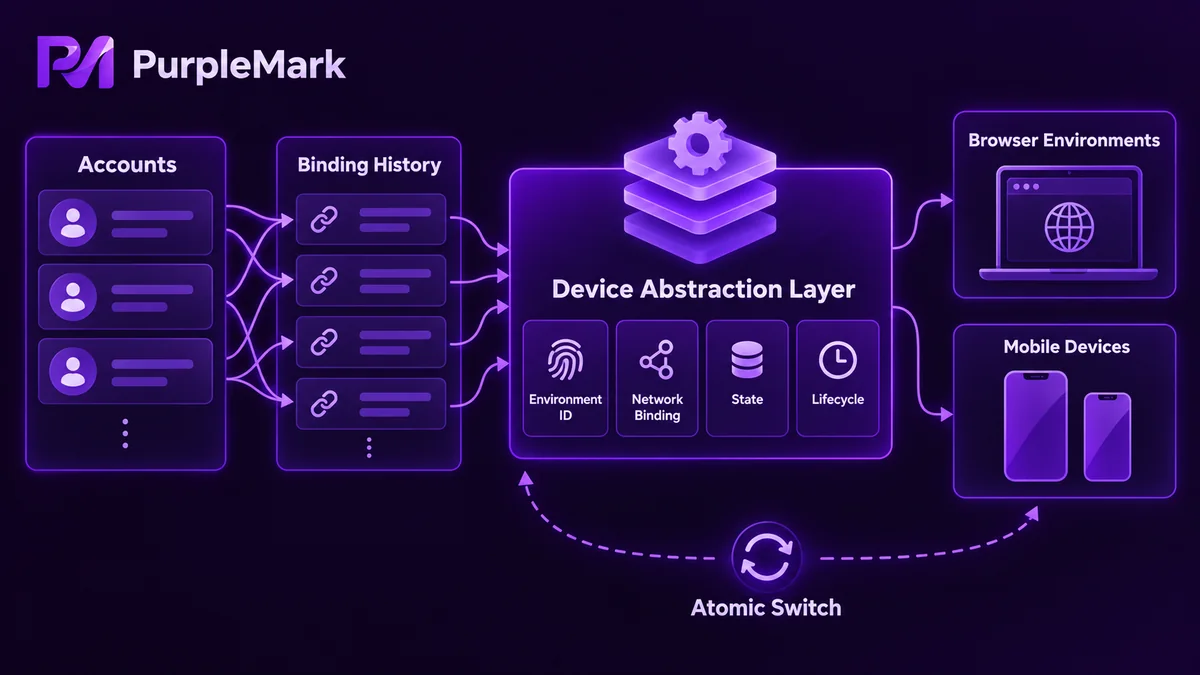
Tras separar ambos conceptos, cuentas y dispositivos deberían mantener una relación de muchos a muchos. La cuenta no guarda la huella; solo registra a qué dispositivo está vinculada en ese momento. El cambio de dispositivo debe ser una operación atómica, el historial de vinculaciones debe conservarse en una tabla independiente y cada dispositivo debe tener un identificador único, que sea la única referencia expuesta al exterior, con estado consultable en tiempo real.
No se hace para que el modelo resulte más elegante. Se hace para acortar la distancia entre un ajuste que quiere operaciones y un cambio de código que tiene que hacer desarrollo, una distancia que crece junto con el número de dispositivos.
Cuatro grupos de campos que la capa de abstracción debe definir con claridad
Una abstracción de dispositivos capaz de escalar solo necesita responder cuatro cuestiones hacia el exterior.
- ID de entorno: único y estable. Las capas superiores solo deben referirse al entorno mediante este ID; los números internos, nombres de contenedores e identificadores de proceso no deben quedar expuestos
- Vinculación de salida: por qué salida de red se conecta el entorno y si la zona horaria, el idioma y el DNS asociados forman una configuración coherente. Separar la salida permite cambiarla sin modificar el propio entorno
- Estado: creando, listo para iniciar, en ejecución, ocupado por una tarea, anómalo, pendiente de recuperación. Sin un modelo de estados no es posible gestionar agrupaciones ni recuperación
- Ciclo de vida: quién activa la creación, el inicio, la ocupación, la liberación y la recuperación; qué ocurre cuando una tarea supera el tiempo límite; y quién se ocupa del cierre cuando el entorno falla
Estado y ciclo de vida suelen fusionarse en un solo campo. Es la solución más cómoda y también la más cara. El estado responde cómo está ahora el entorno; el ciclo de vida responde quién puede actuar sobre él a continuación. En producción, los problemas reales casi siempre aparecen en el segundo punto: una tarea falla y nadie libera el entorno, o se recupera un entorno que todavía está activo y solo en el siguiente inicio se descubre que la salida ya ha cambiado.
Una mala abstracción pasa factura al escalar
Con diez entornos quizá no se note nada. Al llegar a decenas o cientos, los problemas aparecen a la vez:
- Añadir un nuevo tipo de dispositivo obliga a tocar el módulo de cuentas y amplía el alcance de las pruebas de regresión desde la capa de dispositivos hasta la de cuentas
- Cambiar de dispositivo exige modificar la base de datos, por lo que operaciones evita hacerlo y poco a poco solo desarrollo puede mantener el sistema
- Sin registros de estado y ocupación, los entornos que quedan tras salidas anómalas no se recuperan y los entornos zombis se acumulan
- Las tareas, el contenido y la automatización de las capas superiores se construyen sobre una relación uno a uno entre cuenta y dispositivo, de modo que un cambio obliga a rehacer toda la cadena
Los dispositivos de distintas fuentes son muy diferentes en su implementación: un entorno de navegador local y un teléfono en la nube utilizan interfaces distintas. La función de la capa de abstracción es colocarlos detrás del mismo conjunto de interfaces. Para añadir un tipo de dispositivo debería bastar con incorporar un adaptador que implemente inicio, parada y consulta de estado; la lógica superior no tendría que cambiar. También existe una prueba sencilla para saber si la abstracción es correcta: al añadir un tipo de dispositivo, ¿el código que hay que modificar queda limitado a un único archivo?
En la primera fase, cuanto menos mejor
Una vez definido el modelo técnico, la interfaz surge de forma más natural. Los menús deben organizarse por objetos de negocio, con cuentas, tareas y dispositivos en secciones independientes, en lugar de girar en torno a configuración, parámetros y registros. El estado y las anomalías deben ser lo más visible, porque el usuario busca si hay problemas, no cuántos registros existen.
En cuanto a funciones, para la primera fase basta con una lista de dispositivos, la opción de añadir dispositivos y un flujo mínimo de tarea de extremo a extremo. Conviene reducir el menú al máximo, conseguir primero que una sola cosa funcione de principio a fin y dejar para después lo que no sea necesario.
Si no se quiere implementar el aislamiento de entornos desde cero, también se pueden usar capacidades ya disponibles. PurpleMark ofrece entornos independientes y vinculación de salida, admite creación masiva por grupos y consulta de estados. La capa superior solo tiene que implementar plantillas, ocupación y programación de tareas, dejando el esfuerzo de ingeniería en la lógica de negocio.
La complejidad de un sistema multicuenta nunca está en el número de cuentas, sino en la gestión del ciclo de vida de los dispositivos. Si primero se trata cada dispositivo como un recurso con identidad, salida, estado y ciclo de vida, las funciones de las capas superiores no tendrán que rehacerse cada vez que se añada algo.


