
Pour construire un système de gestion multi-comptes, il faut d’abord définir les champs et le cycle de vie de la couche appareil, pas l’interface. Une mauvaise abstraction entraîne des refontes en chaîne lorsque le nombre de comptes augmente ou que les types d’appareils évoluent.
Lors du développement d’un système de gestion multi-comptes, la première version est souvent pensée à partir de l’interface : créer une liste de comptes, associer un profil de navigateur à chacun, puis appeler des interfaces pour exécuter des actions. Cela semble suffisant jusqu’au moment où le système fonctionne réellement.
La première implémentation est généralement très directe. Le compte A pointe vers le profil 001, le compte B vers le profil 002 et le compte C est rattaché à un téléphone cloud. Les difficultés apparaissent alors à trois endroits : l’équipe opérationnelle signale qu’une machine est en panne et demande si le compte A peut être déplacé vers le téléphone cloud, mais la réponse implique une modification de base de données, une intervention manuelle et du risque ; une nouvelle source d’appareils doit être intégrée et la question de son ajout conduit à refondre le module des comptes ; ou encore le même compte doit utiliser un environnement de navigateur le matin et un téléphone cloud l’après-midi, ce qui devient presque impossible à planifier proprement.
Ces trois situations semblent sans rapport, mais elles ont une cause unique : l’entité compte contient des éléments qui ne lui appartiennent pas. L’appareil actuellement connecté, les appareils utilisés auparavant, les paramètres d’empreinte et l’adresse de sortie sont tous enregistrés sur le compte. Changer d’appareil revient donc à modifier le compte, avec des répercussions partout.
Faire de l’appareil une catégorie d’objet distincte
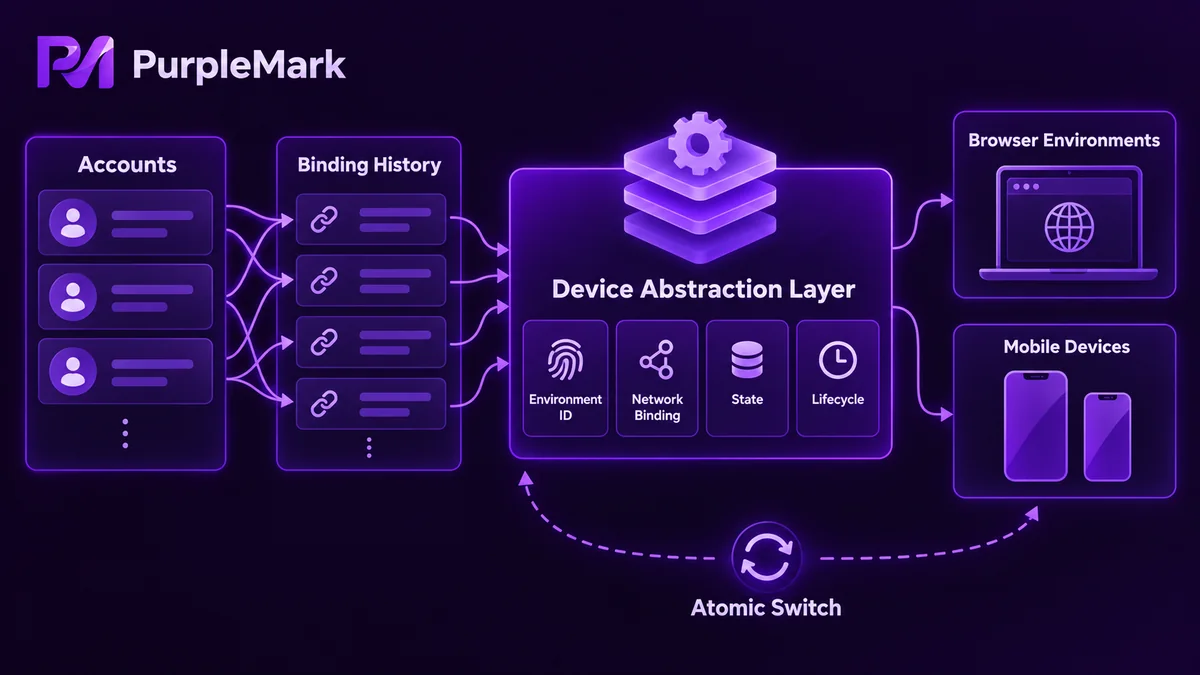
Une fois les concepts séparés, les comptes et les appareils doivent avoir une relation plusieurs-à-plusieurs. Le compte ne stocke pas l’empreinte ; il indique uniquement l’appareil auquel il est actuellement lié. Le changement d’appareil devient une opération atomique, l’historique des liaisons est conservé dans une table séparée et chaque appareil possède un identifiant unique, seul identifiant exposé vers l’extérieur, avec un état consultable en temps réel.
Le but n’est pas d’obtenir un modèle plus élégant. Il s’agit de réduire la distance entre un ajustement souhaité par les opérations et une modification de code côté développement, distance qui augmente avec le nombre d’appareils.
Quatre groupes de champs que la couche d’abstraction doit définir clairement
Une abstraction d’appareil capable d’évoluer n’a besoin de répondre qu’à quatre questions vers l’extérieur.
- ID d’environnement : unique et stable. Les couches supérieures ne référencent l’environnement que par cet ID ; les numéros internes, noms de conteneurs et identifiants de processus ne doivent pas être exposés
- Liaison de sortie : par quelle sortie réseau l’environnement communique et si le fuseau horaire, la langue et le DNS associés forment un ensemble cohérent. Séparer la sortie permet de la remplacer sans modifier l’environnement lui-même
- État : création en cours, prêt à démarrer, en cours d’exécution, occupé par une tâche, anormal, en attente de récupération. Sans modèle d’état, la mutualisation et la récupération ne peuvent pas être gérées
- Cycle de vie : qui déclenche la création, le démarrage, l’occupation, la libération et la récupération ; que faire en cas d’expiration d’une tâche ; et qui termine le nettoyage lorsqu’un environnement devient anormal
L’état et le cycle de vie sont souvent fusionnés dans un seul champ. C’est la solution la plus simple, mais aussi la plus coûteuse. L’état répond à la question de la situation actuelle ; le cycle de vie indique qui peut agir ensuite. En production, les vrais problèmes viennent presque toujours du second point : une tâche plante et personne ne libère l’environnement, ou un environnement encore actif est récupéré et ce n’est qu’au démarrage suivant que l’on découvre que la sortie a changé.
Une mauvaise abstraction se paie au moment de passer à l’échelle
Avec dix environnements, rien ne paraît anormal. À plusieurs dizaines ou centaines, les problèmes surgissent ensemble :
- L’ajout d’un nouveau type d’appareil oblige à modifier le module des comptes et étend les tests de régression de la couche appareil à la couche compte
- Changer d’appareil nécessite une modification en base ; les opérations hésitent à intervenir et le système finit progressivement par n’être maintenable que par les développeurs
- Sans suivi de l’état et de l’occupation, les environnements abandonnés après une sortie anormale ne sont pas récupérés et les environnements zombies s’accumulent
- Les tâches, le contenu et l’automatisation des couches supérieures reposent sur une relation un-à-un entre compte et appareil ; un changement oblige alors à reprendre toute la chaîne
Les appareils de sources différentes sont très différents dans leur implémentation : un environnement de navigateur local et un téléphone cloud n’utilisent pas les mêmes interfaces. La couche d’abstraction sert à les placer derrière un ensemble d’interfaces commun. Pour ajouter un type d’appareil, il devrait suffire d’ajouter un adaptateur qui implémente le démarrage, l’arrêt et la consultation d’état ; la logique des couches supérieures reste inchangée. Un test simple permet aussi de juger la qualité de l’abstraction : lorsqu’on ajoute un type d’appareil, les modifications de code se limitent-elles à un seul fichier ?
En première phase, mieux vaut en faire le moins possible
Une fois le modèle technique fixé, l’interface devient beaucoup plus naturelle. Les menus doivent être organisés par objets métier, avec des sections distinctes pour les comptes, les tâches et les appareils, plutôt que par configuration, paramètres et journaux. L’état et les anomalies doivent être les éléments les plus visibles, car l’utilisateur cherche à savoir s’il existe un problème, pas combien d’enregistrements sont présents.
Pour les fonctions, la première phase a seulement besoin d’une liste d’appareils, de l’ajout d’appareils et d’un flux de tâche minimal de bout en bout. Réduisez le menu au strict nécessaire, faites d’abord fonctionner un processus complet et reportez ce qui n’est pas utile.
Si vous ne souhaitez pas mettre en œuvre l’isolation des environnements à partir de zéro, vous pouvez vous appuyer sur des capacités existantes. PurpleMark fournit des environnements indépendants et la liaison de sortie, prend en charge la création en masse par groupe et les requêtes d’état. La couche supérieure n’a plus qu’à gérer les modèles, l’occupation et la planification des tâches, afin de concentrer l’effort d’ingénierie sur la logique métier.
La complexité d’un système multi-comptes n’a jamais résidé dans le nombre de comptes, mais dans la gestion du cycle de vie des appareils. Traitez d’abord chaque appareil comme une ressource dotée d’une identité, d’une sortie, d’un état et d’un cycle de vie, et les fonctions des couches supérieures n’auront plus à être reconstruites à chaque ajout.


