
做多账号管理系统,最早该定下来的不是界面,而是设备这一层的字段与生命周期。抽象做错,账号一多、设备类型一变,上层功能就得整体返工,改起来是连锁的。
开发一个多账号管理系统,多数人的第一版都是从界面开始想的:做一个账号列表,每个账号挂一个浏览器配置,然后调接口去操作。看上去够用,直到真正跑起来。
第一版的写法往往很直接。账号 A 指向配置 001,账号 B 指向配置 002,账号 C 挂一台云手机。麻烦会在三个地方冒出来:运营说那台机器坏了,能不能把账号 A 挪到云手机上,你只能说改库、手动弄、有风险;接进来一个新的设备来源,问怎么加,得到的回答是账号模块要重构;想让同一个账号上午用浏览器环境、下午用云手机分时段跑,基本做不到。
这三个场景看着互不相干,根因只有一个:账号这个实体里塞进了本来不属于它的东西。当前登录的设备、历史用过的设备、指纹参数、出口地址,全都写在账号上。于是换设备就等于改账号,牵一发动全身。
设备要单独成为一类对象
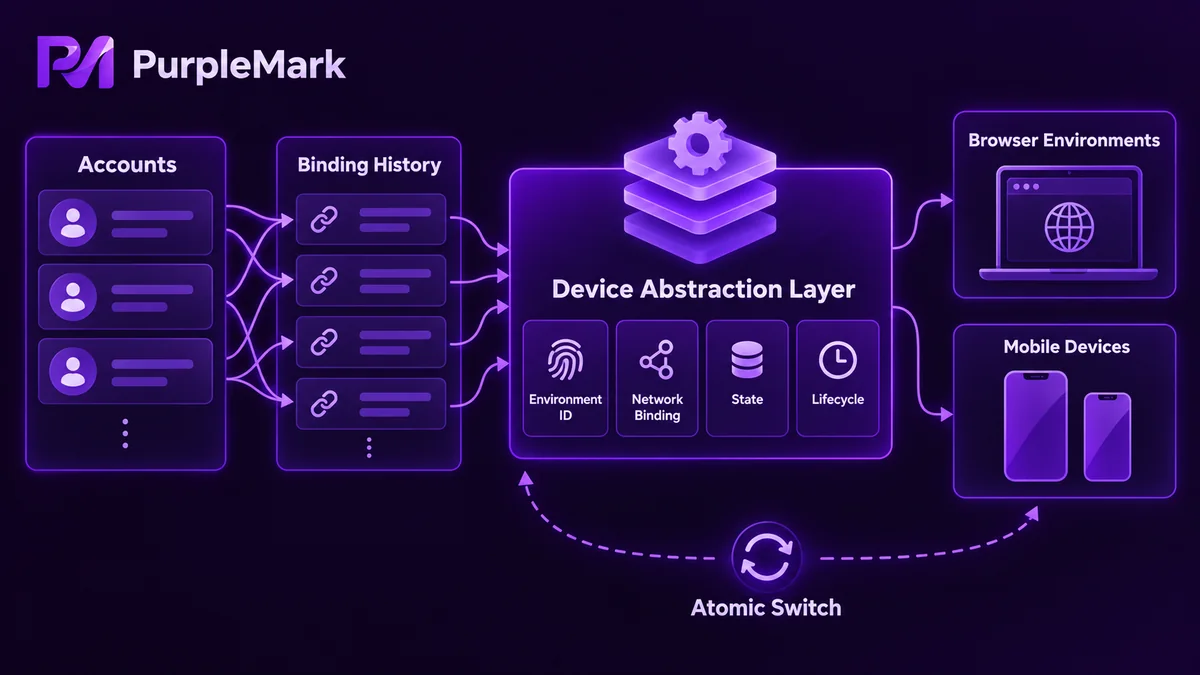
拆开之后,账号和设备之间应该是多对多。账号不存指纹,只记录当前绑定在哪个设备上;切换设备做成一次原子操作,历史绑定单独留一张表备查;设备自己有唯一标识,对外只认这个标识,状态实时可查。
这么做不是因为模型好看。它缩短的是运营想调整时和开发要改代码之间的距离,而这个距离会随着设备数量一起放大。
抽象层要交代清楚的四类字段
一个撑得住扩展的设备抽象,对外只需要回答四件事。
- 环境 ID:唯一且稳定。上层只通过它引用环境,底层实现里的编号、容器名、进程号都不该暴露出去
- 出口绑定:这个环境从哪个网络出口出去,以及配套的时区、语言、DNS 是否成套。出口单独抽出来的好处是,换出口不动环境本身
- 状态:创建中、可启动、运行中、被任务占用、异常、待回收。没有状态模型,池化和回收就无从谈起
- 生命周期:创建、启动、占用、释放、回收分别由谁触发,任务超时怎么办,环境异常了谁来收尾
状态和生命周期经常被合并成一个字段,这是最省事也最贵的做法。状态回答现在是什么样,生命周期回答下一步谁能动它。生产环境里真正的麻烦几乎都出在后者:任务崩了没人释放环境,或者环境还开着就被回收,下一次启动才发现出口已经变了。
抽象做错,代价会在扩展时结账
十个环境的时候什么都看不出来。到了几十上百个,问题集中爆发:
- 新增一类设备要动账号模块,回归范围从设备层扩到账号层
- 换设备要走改库,运营不敢碰,系统慢慢只有开发能维护
- 没有状态和占用记录,异常退出的环境没人回收,僵尸环境越积越多
- 上层任务、内容、自动化全都建立在账号与设备一对一的前提上,改一次全链路重来
不同来源的设备在实现上差别很大,本地浏览器环境、云手机走的接口都不一样。抽象层的作用是把它们放在同一组接口后面:新增一类设备,补一个适配器把启停和状态查询实现掉就够了,上层逻辑不用动。也有一个土办法能判断抽象对不对:加一种设备,需要改的代码是不是只落在一个文件里。
第一阶段做得越少越好
技术模型定下来之后,界面会自然很多。菜单按业务对象组织,账号、任务、设备各占一块,而不是配置、参数、日志。界面上最该显眼的是状态和异常,因为使用者找的是有没有问题,不是有多少条记录。
功能上,第一阶段只做设备列表、添加设备和一条最小任务闭环就够了。菜单能省就省,先把一件事跑通,不用的先不做。
如果不想从零实现环境隔离,也可以把这些交给现成能力。PurpleMark 提供独立环境与出口绑定,支持按分组批量创建和状态查询,上层只需要实现模板、占用和任务调度这几件事,把工程投入留在业务逻辑上。
多账号系统的复杂度从来不在账号数量上,而在设备的生命周期管理。先把设备当成一个有身份、有出口、有状态、有生命周期的资源,上层功能才不会被加一次推翻一次。


