
ในการสร้างระบบจัดการหลายบัญชี สิ่งที่ควรกำหนดก่อนไม่ใช่หน้าจอ แต่คือฟิลด์และวงจรชีวิตของชั้นอุปกรณ์ หากออกแบบ abstraction ผิด เมื่อจำนวนบัญชีเพิ่มขึ้นหรือชนิดอุปกรณ์เปลี่ยน จะเกิดงานแก้โครงสร้างต่อเนื่องไปถึงฟังก์ชันชั้นบน
เมื่อพัฒนาระบบจัดการหลายบัญชี คนส่วนใหญ่มักเริ่มเวอร์ชันแรกจากหน้าจอ: สร้างรายการบัญชี ผูก browser profile ให้แต่ละบัญชี แล้วเรียกอินเทอร์เฟซเพื่อสั่งงาน ดูเหมือนเพียงพอจนกว่าระบบจะเริ่มทำงานจริง
การทำเวอร์ชันแรกมักตรงไปตรงมามาก บัญชี A ชี้ไปที่ profile 001 บัญชี B ชี้ไปที่ profile 002 และบัญชี C ผูกกับ cloud phone ปัญหาจะโผล่ขึ้นมาในสามจุด: ทีมปฏิบัติการบอกว่าเครื่องหนึ่งเสียและถามว่าย้ายบัญชี A ไป cloud phone ได้หรือไม่ แต่คำตอบคือต้องแก้ฐานข้อมูล ทำด้วยมือ และมีความเสี่ยง; เมื่อเชื่อมต่อแหล่งอุปกรณ์ชนิดใหม่แล้วถามว่าจะเพิ่มอย่างไร กลับพบว่าต้อง refactor โมดูลบัญชี; หรืออยากให้บัญชีเดียวกันใช้ browser environment ตอนเช้าและ cloud phone ตอนบ่ายตามช่วงเวลา ซึ่งแทบทำไม่ได้อย่างเป็นระบบ
ทั้งสามกรณีดูไม่เกี่ยวกัน แต่มีสาเหตุเดียวกัน: มีข้อมูลที่ไม่ควรเป็นของบัญชีถูกยัดเข้าไปใน account entity อุปกรณ์ที่ล็อกอินอยู่ตอนนี้ อุปกรณ์ที่เคยใช้ พารามิเตอร์ fingerprint และที่อยู่ขาออก ล้วนถูกเก็บไว้กับบัญชี ดังนั้นการเปลี่ยนอุปกรณ์จึงเท่ากับแก้บัญชี และการเปลี่ยนจุดเดียวกระทบทั้งระบบ
แยกอุปกรณ์ให้เป็นวัตถุอีกประเภทหนึ่ง
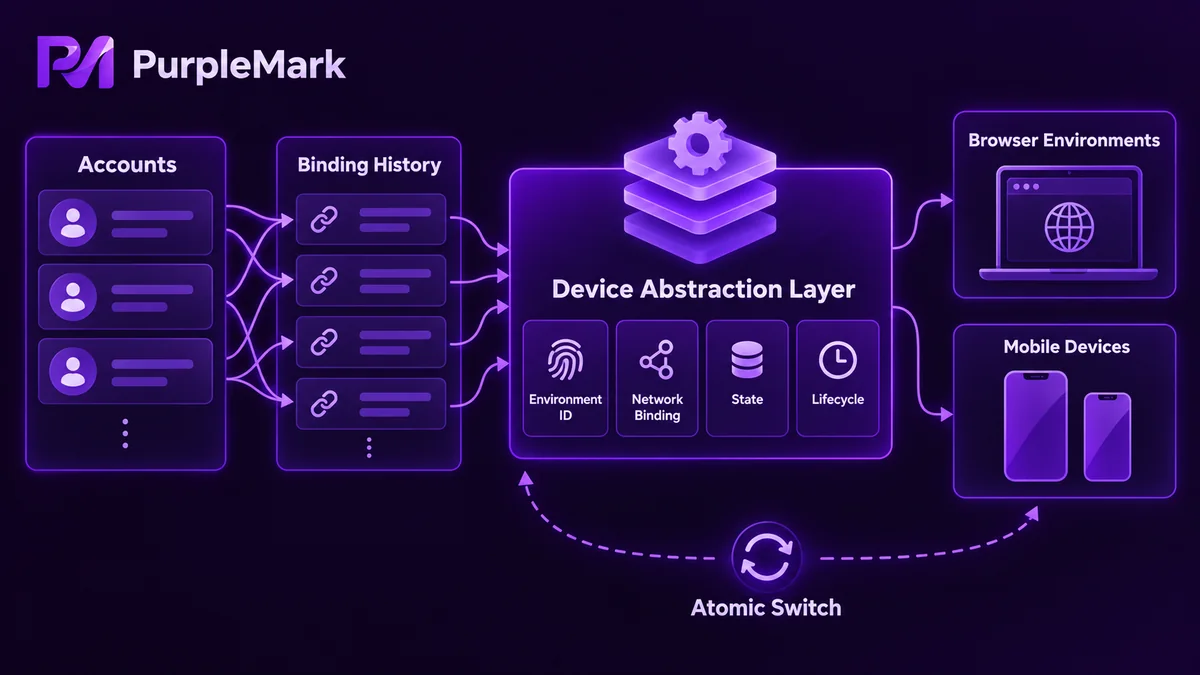
หลังแยกแล้ว บัญชีกับอุปกรณ์ควรมีความสัมพันธ์แบบ many-to-many บัญชีไม่เก็บ fingerprint แต่บันทึกเพียงว่าตอนนี้ผูกกับอุปกรณ์ใด การสลับอุปกรณ์ควรเป็น atomic operation ประวัติการผูกควรเก็บในตารางแยก และอุปกรณ์แต่ละตัวควรมี identifier ที่ไม่ซ้ำ ซึ่งเป็นตัวอ้างอิงเดียวที่เปิดให้ชั้นภายนอกใช้ พร้อมสถานะที่ตรวจสอบได้แบบเรียลไทม์
เหตุผลไม่ใช่เพื่อให้โมเดลดูสวย แต่เพื่อย่นระยะห่างระหว่างสิ่งที่ทีมปฏิบัติการต้องการปรับกับสิ่งที่ทีมพัฒนาต้องแก้ในโค้ด และระยะห่างนี้จะขยายตามจำนวนอุปกรณ์
ฟิลด์ 4 กลุ่มที่ชั้น abstraction ต้องระบุให้ชัด
Device abstraction ที่รองรับการขยายตัวได้ต้องตอบคำถามต่อภายนอกเพียงสี่เรื่อง
- Environment ID: ต้องไม่ซ้ำและคงที่ ชั้นบนอ้างอิง environment ผ่าน ID นี้เท่านั้น เลขภายใน ชื่อ container และ process ID ไม่ควรถูกเปิดเผย
- Egress binding: environment ออกสู่เครือข่ายผ่านทางใด และ time zone ภาษา และ DNS ที่เกี่ยวข้องถูกตั้งเป็นชุดที่สอดคล้องกันหรือไม่ การแยก egress ออกมาต่างหากทำให้เปลี่ยนทางออกได้โดยไม่ต้องเปลี่ยนตัว environment
- Status: กำลังสร้าง, พร้อมเริ่ม, กำลังทำงาน, ถูก task ใช้งาน, ผิดปกติ, รอ reclaim หากไม่มีโมเดลสถานะ ก็ไม่มีพื้นฐานสำหรับ pooling และการ reclaim
- Lifecycle: ใครเป็นผู้ทริกเกอร์การสร้าง การเริ่ม การครอบครอง การปล่อย และการ reclaim; จะทำอย่างไรเมื่อ task timeout; และใครเป็นผู้เก็บงานเมื่อ environment ผิดปกติ
Status กับ lifecycle มักถูกรวมไว้ในฟิลด์เดียว ซึ่งง่ายที่สุดแต่ก็แพงที่สุดเช่นกัน Status ตอบว่าตอนนี้ environment อยู่ในสภาพใด ส่วน lifecycle ตอบว่าใครมีสิทธิ์ทำอะไรกับมันเป็นลำดับถัดไป ปัญหาจริงใน production แทบทั้งหมดเกิดในส่วนหลัง: task ล่มแล้วไม่มีใครปล่อย environment หรือ environment ยังทำงานอยู่แต่ถูก reclaim ไปแล้ว และเพิ่งมารู้ตอนเริ่มครั้งถัดไปว่า egress เปลี่ยนไปแล้ว
ถ้า abstraction ผิด ต้นทุนจะปรากฏตอนขยายระบบ
เมื่อมี environment สิบตัว อาจยังไม่เห็นปัญหา แต่เมื่อเพิ่มเป็นหลายสิบหรือหลายร้อย ปัญหาจะเกิดพร้อมกัน:
- การเพิ่มอุปกรณ์ชนิดใหม่ต้องแก้โมดูลบัญชี ทำให้ขอบเขต regression ขยายจากชั้นอุปกรณ์ไปถึงชั้นบัญชี
- การเปลี่ยนอุปกรณ์ต้องแก้ฐานข้อมูล ทีมปฏิบัติการจึงไม่กล้าแตะ และระบบค่อย ๆ กลายเป็นสิ่งที่มีเพียงนักพัฒนาที่ดูแลได้
- หากไม่มีบันทึกสถานะและการครอบครอง environment ที่เหลือจากการจบแบบผิดปกติจะไม่ถูก reclaim และ zombie environment จะสะสมขึ้นเรื่อย ๆ
- task, content และ automation ในชั้นบนถูกสร้างบนสมมติฐานว่าบัญชีกับอุปกรณ์เป็น one-to-one เมื่อเปลี่ยนสมมติฐานนี้ก็ต้องทำทั้งสายใหม่
อุปกรณ์จากคนละแหล่งแตกต่างกันมากในด้าน implementation เช่น local browser environment กับ cloud phone ใช้อินเทอร์เฟซต่างกัน หน้าที่ของ abstraction layer คือวางทั้งหมดไว้หลังชุดอินเทอร์เฟซเดียวกัน การเพิ่มอุปกรณ์ชนิดใหม่ควรเพียงแค่เพิ่ม adapter ที่ทำ start, stop และ status query ให้ครบ โดยไม่ต้องเปลี่ยน logic ชั้นบน นอกจากนี้ยังมีวิธีทดสอบง่าย ๆ ว่า abstraction ถูกหรือไม่: เมื่อเพิ่มอุปกรณ์หนึ่งชนิด โค้ดที่ต้องแก้จำกัดอยู่ในไฟล์เดียวหรือเปล่า
ระยะแรกยิ่งทำน้อยยิ่งดี
เมื่อโมเดลทางเทคนิคถูกกำหนดแล้ว หน้าจอจะเป็นธรรมชาติมากขึ้น จัดเมนูตาม business object โดยแยกบัญชี task และอุปกรณ์ออกจากกัน แทนที่จะจัดตาม configuration, parameter และ log สิ่งที่ควรเด่นที่สุดคือ status และ exception เพราะผู้ใช้ต้องการรู้ว่ามีปัญหาหรือไม่ ไม่ใช่มีเรกคอร์ดกี่รายการ
ด้านฟังก์ชัน ในระยะแรกมีเพียงรายการอุปกรณ์ การเพิ่มอุปกรณ์ และ task flow แบบ end-to-end ที่เล็กที่สุดก็เพียงพอ ลดเมนูเท่าที่ทำได้ ทำเรื่องหนึ่งให้ทำงานครบก่อน และสิ่งที่ยังไม่จำเป็นให้เลื่อนไปทีหลัง
หากไม่ต้องการสร้าง environment isolation ตั้งแต่ศูนย์ ก็สามารถใช้ความสามารถที่มีอยู่ได้ PurpleMark มี independent environment และ egress binding รองรับการสร้างแบบ batch ตามกลุ่มและการสอบถามสถานะ ชั้นบนจึงต้องทำเพียง template, occupancy และ task scheduling ทำให้เก็บแรงพัฒนาไว้กับ business logic ได้
ความซับซ้อนของระบบหลายบัญชีไม่เคยอยู่ที่จำนวนบัญชี แต่อยู่ที่การจัดการ lifecycle ของอุปกรณ์ หากเริ่มจากมองอุปกรณ์เป็น resource ที่มี identity, egress, status และ lifecycle ฟังก์ชันชั้นบนก็ไม่ต้องถูกล้มแล้วสร้างใหม่ทุกครั้งที่มีการเพิ่มสิ่งใหม่


