
При создании системы управления несколькими аккаунтами сначала стоит определить не интерфейс, а поля и жизненный цикл слоя устройств. Ошибка в абстракции приводит к цепочке переделок, когда растёт число аккаунтов или меняются типы устройств.
При разработке системы управления несколькими аккаунтами первую версию чаще всего начинают с интерфейса: делают список аккаунтов, к каждому привязывают профиль браузера, а затем вызывают интерфейсы для выполнения операций. Этого кажется достаточно, пока система не начинает работать по-настоящему.
Первая реализация обычно очень прямолинейна. Аккаунт A указывает на профиль 001, аккаунт B — на профиль 002, аккаунт C привязан к облачному телефону. Затем проблемы появляются в трёх местах: операционная команда сообщает, что машина сломалась, и просит перенести аккаунт A на облачный телефон, но для этого приходится менять базу данных вручную и принимать риск; подключается новый источник устройств, и выясняется, что для его добавления нужно переделывать модуль аккаунтов; либо один и тот же аккаунт должен утром работать в браузерной среде, а днём на облачном телефоне, что практически невозможно нормально организовать по расписанию.
Эти три сценария кажутся несвязанными, но причина у них одна: в сущность аккаунта помещены данные, которые ей не принадлежат. Текущее устройство входа, ранее использованные устройства, параметры отпечатка и выходной адрес хранятся прямо в аккаунте. Поэтому смена устройства превращается в изменение аккаунта и затрагивает всё вокруг.
Устройство должно быть отдельным типом объекта
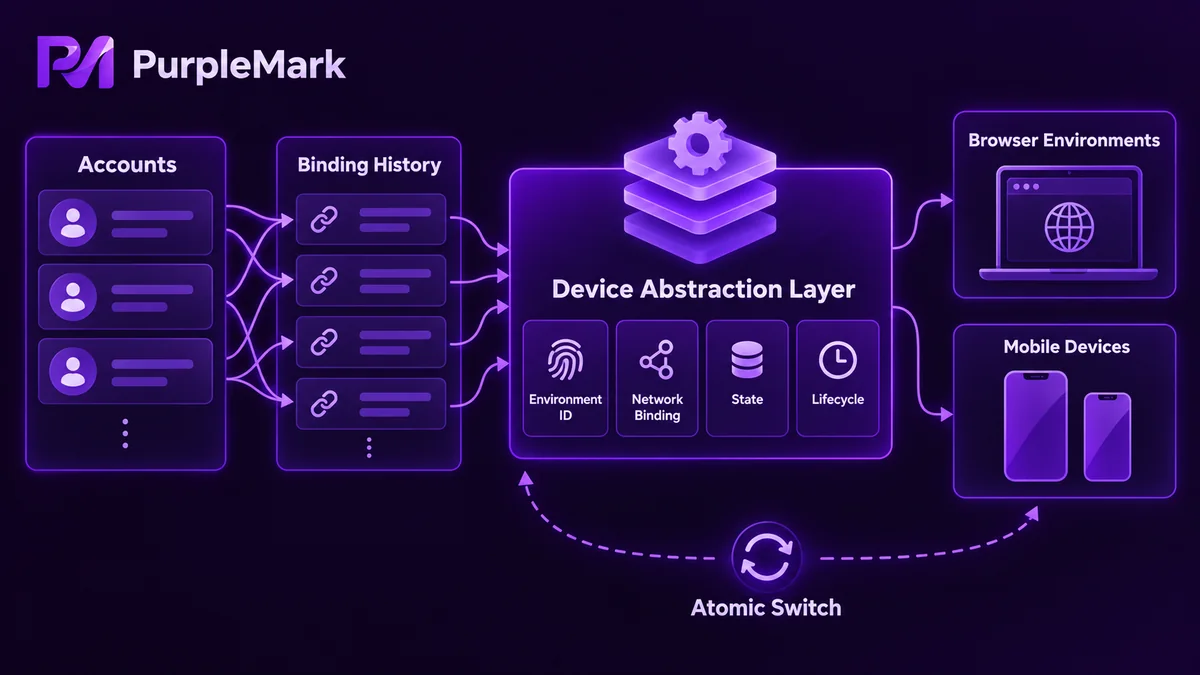
После разделения аккаунты и устройства должны иметь отношение многие-ко-многим. Аккаунт не хранит отпечаток, а только фиксирует, к какому устройству он сейчас привязан. Смена устройства должна быть атомарной операцией, история привязок — храниться в отдельной таблице, а каждое устройство — иметь уникальный идентификатор, который единственный используется вовне, при этом его статус доступен в реальном времени.
Это делается не ради красоты модели. Такая схема сокращает расстояние между изменением, которое хочет сделать операционная команда, и изменением кода, которое требуется от разработчиков, а это расстояние увеличивается вместе с количеством устройств.
Четыре группы полей, которые должен чётко определять слой абстракции
Масштабируемая абстракция устройств должна отвечать наружу всего на четыре вопроса.
- ID среды: уникальный и стабильный. Верхние слои ссылаются на среду только через него; внутренние номера, имена контейнеров и ID процессов не должны выходить наружу
- Привязка выхода: через какой сетевой выход работает среда и составляют ли связанный часовой пояс, язык и DNS единый согласованный набор. Если выход абстрагирован отдельно, его можно менять, не трогая саму среду
- Статус: создаётся, готова к запуску, работает, занята задачей, неисправна, ожидает освобождения. Без модели статусов нельзя нормально организовать пул и возврат ресурсов
- Жизненный цикл: кто запускает создание, старт, занятие, освобождение и возврат; что происходит при тайм-ауте задачи; и кто завершает очистку при сбое среды
Статус и жизненный цикл часто объединяют в одно поле. Это самый простой и одновременно самый дорогой вариант. Статус отвечает, в каком состоянии среда находится сейчас; жизненный цикл — кто может изменить её следующим. В продакшене реальные проблемы почти всегда возникают во втором пункте: задача падает, а среду никто не освобождает, либо ещё работающую среду возвращают в пул, и только при следующем запуске обнаруживается, что выход уже изменился.
Ошибка в абстракции проявляет цену при масштабировании
При десяти средах проблемы могут быть незаметны. При десятках и сотнях они возникают одновременно:
- Добавление нового типа устройства требует изменений в модуле аккаунтов, и область регрессионного тестирования расширяется со слоя устройств на слой аккаунтов
- Смена устройства требует правки базы данных, поэтому операционная команда боится её выполнять, и постепенно систему могут обслуживать только разработчики
- Без записей о статусе и занятости среды, оставшиеся после аварийных выходов, не возвращаются, а «зомби»-среды накапливаются
- Задачи, контент и автоматизация верхних слоёв построены на предположении об отношении один-к-одному между аккаунтом и устройством, поэтому изменение этого предположения заставляет переделывать всю цепочку
Устройства из разных источников сильно отличаются по реализации: локальные браузерные среды и облачные телефоны используют совершенно разные интерфейсы. Задача слоя абстракции — скрыть их за одним набором интерфейсов. Для добавления нового типа устройства должно быть достаточно нового адаптера, который реализует запуск, остановку и запрос статуса; логика верхних слоёв при этом не меняется. Есть и простой практический тест: когда добавляется новый тип устройства, ограничиваются ли изменения кода одним файлом?
На первом этапе лучше сделать как можно меньше
После определения технической модели интерфейс становится гораздо естественнее. Меню стоит организовывать по бизнес-объектам: отдельные разделы для аккаунтов, задач и устройств, а не для конфигурации, параметров и логов. Самыми заметными должны быть статус и исключения, потому что пользователь ищет проблемы, а не количество записей.
По функциям на первом этапе достаточно списка устройств, добавления устройств и одного минимального сквозного цикла выполнения задачи. Меню лучше сократить до минимума, сначала полностью запустить один сценарий и отложить всё ненужное.
Если не хочется реализовывать изоляцию сред с нуля, можно использовать готовые возможности. PurpleMark предоставляет независимые среды и привязку выхода, поддерживает пакетное создание по группам и запросы статуса. Верхнему уровню остаётся реализовать шаблоны, занятость и планирование задач, сохранив инженерные усилия для бизнес-логики.
Сложность системы с несколькими аккаунтами заключается не в количестве аккаунтов, а в управлении жизненным циклом устройств. Если сначала рассматривать устройство как ресурс с идентичностью, выходом, статусом и жизненным циклом, функции верхнего уровня не придётся переделывать при каждом расширении.


