
मल्टी-अकाउंट मैनेजमेंट सिस्टम बनाते समय सबसे पहले इंटरफ़ेस नहीं, बल्कि डिवाइस लेयर के फ़ील्ड और लाइफ़साइकल तय करने चाहिए। गलत एब्स्ट्रैक्शन से अकाउंट बढ़ने या डिवाइस प्रकार बदलने पर लगातार रीफ़ैक्टरिंग करनी पड़ती है।
मल्टी-अकाउंट मैनेजमेंट सिस्टम बनाते समय ज़्यादातर लोग पहले संस्करण की शुरुआत इंटरफ़ेस से करते हैं: अकाउंट की सूची बनाना, हर अकाउंट के साथ एक ब्राउज़र प्रोफ़ाइल जोड़ना और फिर काम कराने के लिए इंटरफ़ेस कॉल करना। यह तब तक पर्याप्त लगता है, जब तक सिस्टम सच में चलना शुरू नहीं करता।
पहला इम्प्लीमेंटेशन आम तौर पर बहुत सीधा होता है। अकाउंट A प्रोफ़ाइल 001 को इंगित करता है, अकाउंट B प्रोफ़ाइल 002 को, और अकाउंट C एक क्लाउड फ़ोन से जुड़ा होता है। फिर तीन जगह समस्या आती है: ऑपरेशंस टीम कहती है कि मशीन खराब है और पूछती है कि क्या अकाउंट A को क्लाउड फ़ोन पर ले जाया जा सकता है, लेकिन जवाब होता है डेटाबेस बदलना, हाथ से काम करना और जोखिम लेना; कोई नया डिवाइस स्रोत जुड़ता है और उसे जोड़ने का तरीका पूछने पर पता चलता है कि अकाउंट मॉड्यूल को रीफ़ैक्टर करना पड़ेगा; या वही अकाउंट सुबह ब्राउज़र एनवायरनमेंट और दोपहर में क्लाउड फ़ोन पर चलाना हो, जिसे समय के हिसाब से व्यवस्थित करना लगभग असंभव हो जाता है।
ये तीनों स्थितियाँ अलग दिखती हैं, लेकिन मूल कारण एक है: अकाउंट एंटिटी में ऐसी चीज़ें भर दी गई हैं जो उसकी नहीं हैं। वर्तमान लॉगिन डिवाइस, पहले इस्तेमाल हुए डिवाइस, फ़िंगरप्रिंट पैरामीटर और एग्रेस एड्रेस—सब अकाउंट पर ही रखे गए हैं। इसलिए डिवाइस बदलना अकाउंट बदलने के बराबर हो जाता है और एक बदलाव पूरे सिस्टम को प्रभावित करता है।
डिवाइस को अलग ऑब्जेक्ट प्रकार बनाइए
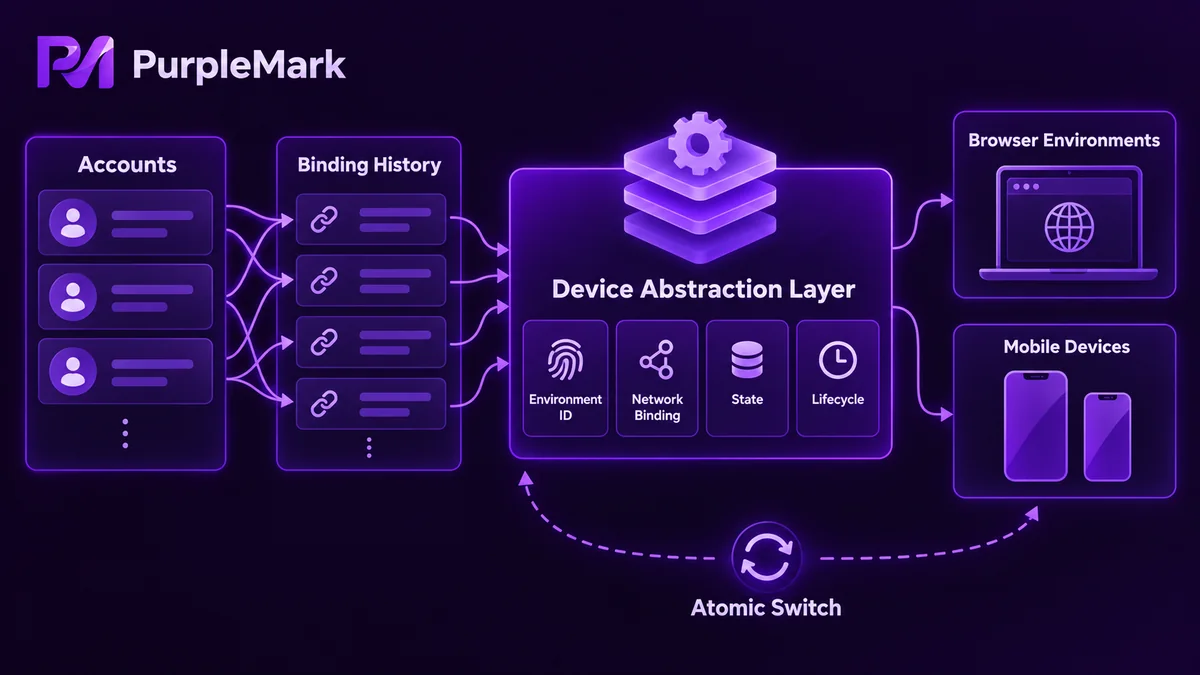
अलग करने के बाद अकाउंट और डिवाइस के बीच many-to-many संबंध होना चाहिए। अकाउंट फ़िंगरप्रिंट नहीं रखता; वह केवल यह दर्ज करता है कि इस समय किस डिवाइस से बाइंड है। डिवाइस बदलना एक एटॉमिक ऑपरेशन होना चाहिए, पुरानी बाइंडिंग का इतिहास अलग टेबल में रखा जाना चाहिए, और हर डिवाइस का एक यूनिक आइडेंटिफ़ायर होना चाहिए जो बाहर की दुनिया में उसकी एकमात्र पहचान हो, जबकि उसकी स्थिति रियल टाइम में देखी जा सके।
यह मॉडल को सुंदर दिखाने के लिए नहीं है। इसका उद्देश्य उस दूरी को कम करना है जो ऑपरेशंस की इच्छित एडजस्टमेंट और डेवलपमेंट के कोड बदलाव के बीच होती है; और यह दूरी डिवाइस की संख्या के साथ बढ़ती है।
एब्स्ट्रैक्शन लेयर को स्पष्ट करने वाले चार फ़ील्ड समूह
स्केल करने योग्य डिवाइस एब्स्ट्रैक्शन को बाहर की ओर केवल चार बातों का जवाब देना चाहिए।
- एनवायरनमेंट ID: यूनिक और स्थिर। ऊपरी लेयर केवल इसी ID से एनवायरनमेंट को रेफ़र करे; अंदरूनी नंबर, कंटेनर नाम और प्रोसेस ID बाहर नहीं आने चाहिए
- एग्रेस बाइंडिंग: एनवायरनमेंट किस नेटवर्क एग्रेस से बाहर जाता है और उससे जुड़े टाइम ज़ोन, भाषा और DNS एक संगत सेट के रूप में कॉन्फ़िगर हैं या नहीं। एग्रेस को अलग एब्स्ट्रैक्ट करने से एनवायरनमेंट बदले बिना एग्रेस बदला जा सकता है
- स्टेटस: बन रहा है, शुरू करने के लिए तैयार, चल रहा है, किसी टास्क द्वारा उपयोग में, असामान्य, रिक्लेम होने की प्रतीक्षा में। स्टेटस मॉडल के बिना पूलिंग और रिक्लेमेशन को व्यवस्थित नहीं किया जा सकता
- लाइफ़साइकल: creation, startup, occupation, release और reclamation कौन ट्रिगर करता है; टास्क के टाइम आउट होने पर क्या होगा; और एनवायरनमेंट में समस्या आने पर cleanup कौन पूरा करेगा
स्टेटस और लाइफ़साइकल को अक्सर एक ही फ़ील्ड में मिला दिया जाता है। यह सबसे आसान और साथ ही सबसे महँगा तरीका है। स्टेटस बताता है कि एनवायरनमेंट अभी कैसा है; लाइफ़साइकल बताता है कि अगला कदम कौन उठा सकता है। प्रोडक्शन में असली परेशानी लगभग हमेशा दूसरे हिस्से में आती है: टास्क क्रैश हो जाता है और कोई एनवायरनमेंट रिलीज़ नहीं करता, या एनवायरनमेंट चलते हुए ही रिक्लेम हो जाता है और अगली बार स्टार्ट करने पर पता चलता है कि एग्रेस बदल चुका है।
गलत एब्स्ट्रैक्शन की कीमत स्केल करते समय चुकानी पड़ती है
दस एनवायरनमेंट पर शायद कुछ भी गलत न दिखे। दर्जनों या सैकड़ों पर समस्याएँ एक साथ सामने आती हैं:
- नया डिवाइस प्रकार जोड़ने के लिए अकाउंट मॉड्यूल बदलना पड़ता है, जिससे रिग्रेशन का दायरा डिवाइस लेयर से अकाउंट लेयर तक फैल जाता है
- डिवाइस बदलने के लिए डेटाबेस बदलना पड़ता है, इसलिए ऑपरेशंस उसे छूने से डरता है और धीरे-धीरे सिस्टम केवल डेवलपर्स द्वारा मेंटेन किया जा सकता है
- स्टेटस और occupancy रिकॉर्ड न होने पर असामान्य एग्ज़िट के बाद बचे एनवायरनमेंट रिक्लेम नहीं होते और ज़ॉम्बी एनवायरनमेंट जमा होते जाते हैं
- ऊपरी लेयर के टास्क, कंटेंट और ऑटोमेशन अकाउंट और डिवाइस के one-to-one संबंध की धारणा पर बने होते हैं, इसलिए इसे बदलने पर पूरी चेन फिर से बनानी पड़ती है
अलग-अलग स्रोतों के डिवाइस इम्प्लीमेंटेशन में बहुत अलग होते हैं: लोकल ब्राउज़र एनवायरनमेंट और क्लाउड फ़ोन अलग इंटरफ़ेस इस्तेमाल करते हैं। एब्स्ट्रैक्शन लेयर का काम उन्हें एक ही इंटरफ़ेस सेट के पीछे रखना है। नया डिवाइस प्रकार जोड़ने के लिए इतना ही काफ़ी होना चाहिए कि start, stop और status query लागू करने वाला एक adapter जोड़ा जाए; ऊपरी लेयर की logic न बदले। एब्स्ट्रैक्शन सही है या नहीं, यह जाँचने का एक सरल तरीका भी है: नया डिवाइस प्रकार जोड़ते समय क्या बदला जाने वाला code केवल एक file तक सीमित रहता है?
पहले चरण में जितना कम हो, उतना बेहतर
तकनीकी मॉडल तय हो जाने पर इंटरफ़ेस अधिक स्वाभाविक बनता है। मेनू को business objects के अनुसार व्यवस्थित करें—accounts, tasks और devices के अलग हिस्से हों—न कि configuration, parameters और logs के अनुसार। सबसे स्पष्ट रूप से status और exceptions दिखने चाहिए, क्योंकि उपयोगकर्ता यह देखना चाहता है कि समस्या है या नहीं, रिकॉर्ड कितने हैं यह नहीं।
फ़ंक्शन के स्तर पर पहले चरण में केवल device list, device जोड़ने की सुविधा और एक न्यूनतम end-to-end task flow पर्याप्त है। मेनू जितना छोटा हो सके रखें, पहले एक काम पूरी तरह चलाएँ और जो अभी ज़रूरी नहीं है उसे बाद के लिए छोड़ दें।
यदि आप environment isolation शुरू से नहीं बनाना चाहते, तो तैयार क्षमताओं का उपयोग किया जा सकता है। PurpleMark स्वतंत्र environments और egress binding देता है, group के अनुसार batch creation और status queries को support करता है। ऊपरी layer को केवल templates, occupancy और task scheduling लागू करनी होती है, ताकि engineering effort business logic पर केंद्रित रहे।
मल्टी-अकाउंट सिस्टम की जटिलता कभी अकाउंट की संख्या में नहीं, बल्कि डिवाइस के lifecycle management में होती है। पहले डिवाइस को identity, egress, status और lifecycle वाले resource की तरह मानिए, ताकि हर नई चीज़ जुड़ने पर ऊपरी layer की सुविधाएँ फिर से न बनानी पड़ें।


