
Bei einem Multi-Account-Managementsystem sollte zuerst nicht die Oberfläche, sondern die Felder und der Lebenszyklus der Geräteebene festgelegt werden. Eine falsche Abstraktion führt bei mehr Konten oder neuen Gerätetypen zu Ketten von Umbauten.
Bei der Entwicklung eines Multi-Account-Managementsystems denken die meisten bei der ersten Version zuerst an die Oberfläche: eine Kontoliste anlegen, jedem Konto ein Browserprofil zuordnen und anschließend über Schnittstellen Aktionen ausführen. Das wirkt ausreichend, bis das System tatsächlich im Betrieb ist.
Die erste Umsetzung ist meist sehr direkt. Konto A verweist auf Profil 001, Konto B auf Profil 002 und Konto C hängt an einem Cloud-Telefon. Dann tauchen Probleme an drei Stellen auf: Das Betriebsteam meldet, dass ein Gerät ausgefallen ist, und möchte Konto A auf das Cloud-Telefon verschieben — möglich ist das nur per Datenbankänderung, manuell und mit Risiko. Eine neue Gerätequelle soll integriert werden — und plötzlich muss dafür das Kontomodul umgebaut werden. Oder dasselbe Konto soll morgens eine Browserumgebung und nachmittags ein Cloud-Telefon nutzen — praktisch nicht sauber umsetzbar.
Diese drei Szenarien wirken unabhängig, haben aber dieselbe Ursache: Im Kontoobjekt stecken Daten, die dort nicht hingehören. Aktuell genutztes Gerät, früher verwendete Geräte, Fingerprint-Parameter und Ausgangsadresse werden direkt am Konto gespeichert. Ein Gerätewechsel wird damit zu einer Kontenänderung und zieht Änderungen im ganzen System nach sich.
Geräte als eigene Objektklasse behandeln
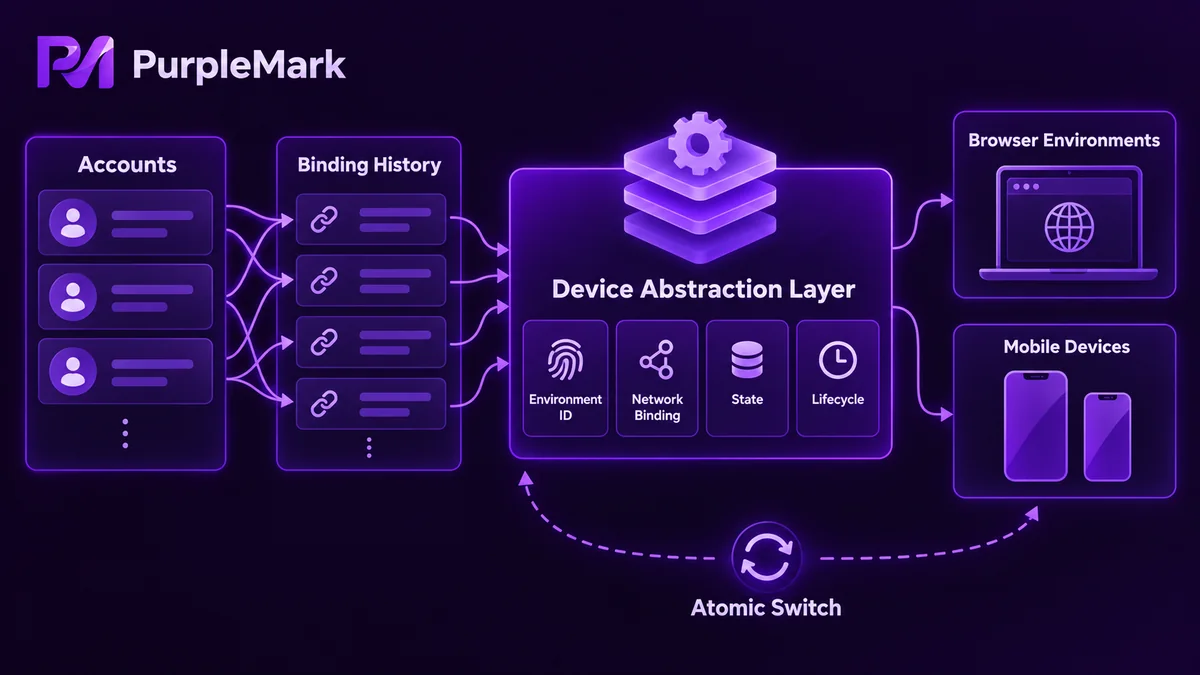
Nach der Trennung sollten Konten und Geräte in einer Viele-zu-viele-Beziehung stehen. Das Konto speichert keinen Fingerprint, sondern nur, an welches Gerät es aktuell gebunden ist. Ein Gerätewechsel wird als atomare Operation ausgeführt, historische Bindungen werden in einer separaten Tabelle aufbewahrt, und jedes Gerät besitzt eine eindeutige Kennung, die nach außen allein verwendet wird; der Status ist in Echtzeit abrufbar.
Das dient nicht der Schönheit des Modells. Es verkürzt den Weg zwischen einer gewünschten betrieblichen Anpassung und einer notwendigen Codeänderung — und genau dieser Abstand wächst mit der Zahl der Geräte.
Vier Feldgruppen, die die Abstraktionsschicht klar definieren muss
Eine skalierbare Geräteabstraktion muss nach außen nur vier Fragen beantworten.
- Umgebungs-ID: eindeutig und stabil. Höhere Schichten referenzieren die Umgebung ausschließlich über diese ID; interne Nummern, Containernamen und Prozess-IDs dürfen nicht nach außen dringen
- Ausgangsbindung: über welchen Netzwerkausgang die Umgebung kommuniziert und ob Zeitzone, Sprache und DNS als zusammengehöriger Satz konfiguriert sind. Wird der Ausgang separat abstrahiert, kann er gewechselt werden, ohne die Umgebung selbst zu ändern
- Status: wird erstellt, startbereit, läuft, von einer Aufgabe belegt, fehlerhaft, zur Rückgewinnung vorgemerkt. Ohne Statusmodell lassen sich Pooling und Rückgewinnung nicht sinnvoll verwalten
- Lebenszyklus: wer Erstellung, Start, Belegung, Freigabe und Rückgewinnung auslöst; was bei einem Aufgaben-Timeout passiert; und wer bei einem Fehler der Umgebung aufräumt
Status und Lebenszyklus werden häufig in einem Feld zusammengefasst. Das ist die bequemste, aber zugleich teuerste Lösung. Der Status beschreibt, wie die Umgebung jetzt aussieht; der Lebenszyklus legt fest, wer sie als Nächstes verändern darf. In Produktion entstehen die eigentlichen Probleme fast immer beim zweiten Punkt: Eine Aufgabe stürzt ab und niemand gibt die Umgebung frei, oder eine noch laufende Umgebung wird zurückgewonnen und erst beim nächsten Start fällt auf, dass sich der Ausgang geändert hat.
Eine falsche Abstraktion wird beim Skalieren teuer
Bei zehn Umgebungen fällt oft nichts auf. Bei Dutzenden oder Hunderten treten die Probleme geballt auf:
- Für einen neuen Gerätetyp muss das Kontomodul geändert werden, sodass sich der Regressionstest von der Geräte- auf die Kontoschicht ausweitet
- Ein Gerätewechsel erfordert eine Datenbankänderung; das Betriebsteam fasst ihn deshalb ungern an und nach und nach können nur noch Entwickler das System pflegen
- Ohne Status- und Belegungsdaten werden nach abnormalen Abbrüchen zurückgelassene Umgebungen nicht freigegeben und Zombie-Umgebungen sammeln sich an
- Aufgaben, Inhalte und Automatisierung in höheren Schichten beruhen auf einer Eins-zu-eins-Annahme zwischen Konto und Gerät; eine Änderung zwingt zur Überarbeitung der gesamten Kette
Geräte aus unterschiedlichen Quellen unterscheiden sich technisch stark. Lokale Browserumgebungen und Cloud-Telefone verwenden ganz verschiedene Schnittstellen. Die Abstraktionsschicht stellt sie hinter eine einheitliche Schnittstellengruppe. Für einen neuen Gerätetyp sollte ein Adapter genügen, der Start, Stopp und Statusabfrage implementiert; die Logik der höheren Schichten bleibt unverändert. Ein einfacher Praxistest zeigt, ob die Abstraktion stimmt: Beschränkt sich die Codeänderung beim Hinzufügen eines Gerätetyps auf eine einzige Datei?
In der ersten Phase so wenig wie möglich bauen
Sobald das technische Modell steht, ergibt sich auch die Oberfläche natürlicher. Menüs sollten nach Geschäftsobjekten organisiert sein: Konten, Aufgaben und Geräte jeweils als eigener Bereich, statt Konfiguration, Parameter und Protokolle in den Mittelpunkt zu stellen. Am sichtbarsten sollten Status und Ausnahmen sein, denn Nutzer suchen nach Problemen und nicht nach der Anzahl von Datensätzen.
Für die erste Phase genügen funktional eine Geräteliste, das Hinzufügen von Geräten und ein minimaler geschlossener Aufgabenablauf. Menüpunkte können zunächst entfallen; wichtiger ist, zuerst einen Ablauf vollständig zum Laufen zu bringen und Unnötiges später zu ergänzen.
Wer die Umgebungsisolation nicht von Grund auf selbst bauen möchte, kann vorhandene Fähigkeiten nutzen. PurpleMark stellt unabhängige Umgebungen und Ausgangsbindungen bereit, unterstützt die gruppenweise Massenerstellung und Statusabfragen. Die obere Schicht muss dann nur noch Vorlagen, Belegung und Aufgabenplanung umsetzen, sodass Entwicklungsaufwand in der Geschäftslogik bleibt.
Die Komplexität eines Multi-Account-Systems liegt nie in der Zahl der Konten, sondern im Management des Gerätelebenszyklus. Wird ein Gerät von Anfang an als Ressource mit Identität, Ausgang, Status und Lebenszyklus behandelt, müssen Funktionen der oberen Schichten nicht bei jeder Erweiterung wieder neu gebaut werden.


