
Ao criar um sistema de gestão de múltiplas contas, o primeiro passo não deve ser a interface, mas os campos e o ciclo de vida da camada de dispositivos. Uma abstração errada gera refatorações em cadeia quando o número de contas cresce ou surgem novos tipos de dispositivo.
Ao desenvolver um sistema de gestão de múltiplas contas, a primeira versão costuma começar pela interface: criar uma lista de contas, associar um perfil de navegador a cada conta e depois chamar interfaces para executar ações. Parece suficiente até o sistema começar a funcionar de verdade.
A primeira implementação normalmente é muito direta. A conta A aponta para o perfil 001, a conta B para o perfil 002 e a conta C fica ligada a um telefone na nuvem. Os problemas aparecem em três lugares: a equipa de operações diz que uma máquina avariou e pergunta se a conta A pode passar para o telefone na nuvem, mas a resposta exige alterar a base de dados, fazer o processo manualmente e assumir riscos; entra uma nova origem de dispositivos e, ao perguntar como adicioná-la, descobre-se que o módulo de contas precisa de ser refatorado; ou pretende-se que a mesma conta use um ambiente de navegador de manhã e um telefone na nuvem à tarde, algo quase impossível de organizar por horários.
Estes três cenários parecem não ter relação, mas têm uma única causa: a entidade conta recebeu dados que não lhe pertencem. O dispositivo atualmente ligado, os dispositivos usados no passado, os parâmetros de impressão digital e o endereço de saída ficam todos guardados na conta. Assim, trocar de dispositivo passa a significar alterar a conta, e uma mudança desencadeia efeitos em todo o sistema.
O dispositivo deve ser uma classe de objeto independente
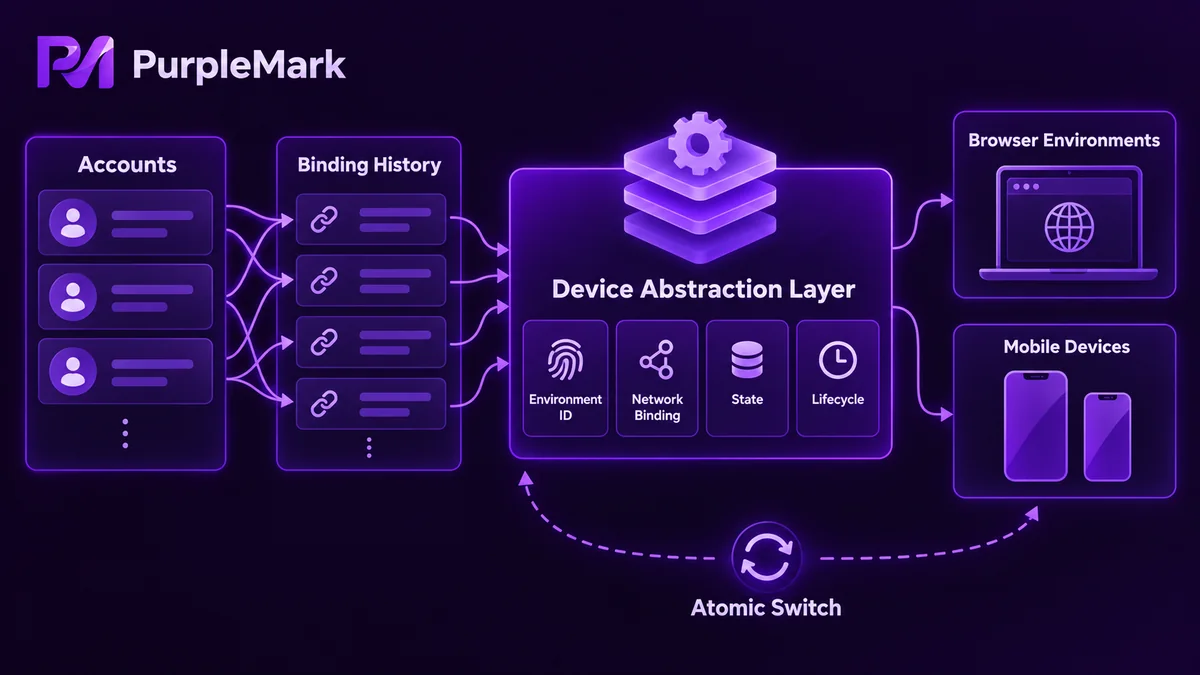
Depois da separação, contas e dispositivos devem ter uma relação muitos-para-muitos. A conta não guarda a impressão digital; apenas regista a que dispositivo está ligada no momento. A troca de dispositivo deve ser uma operação atómica, o histórico de ligações deve ficar numa tabela separada para consulta e cada dispositivo deve ter um identificador único, sendo esse o único identificador exposto externamente, com estado consultável em tempo real.
Isto não é feito para deixar o modelo mais bonito. Serve para reduzir a distância entre um ajuste pretendido pela operação e uma alteração de código necessária no desenvolvimento, distância que aumenta juntamente com o número de dispositivos.
Quatro grupos de campos que a camada de abstração deve definir claramente
Uma abstração de dispositivos preparada para crescer só precisa de responder a quatro questões externamente.
- ID do ambiente: único e estável. As camadas superiores só devem referenciar o ambiente por este ID; números internos, nomes de contentores e IDs de processos não devem ficar expostos
- Associação de saída: por que saída de rede o ambiente comunica e se o fuso horário, o idioma e o DNS associados formam um conjunto coerente. Separar a saída permite trocá-la sem alterar o próprio ambiente
- Estado: em criação, pronto para iniciar, em execução, ocupado por uma tarefa, anómalo, a aguardar recuperação. Sem um modelo de estados, não há base para gerir pooling e recuperação
- Ciclo de vida: quem aciona a criação, o arranque, a ocupação, a libertação e a recuperação; o que acontece quando uma tarefa excede o tempo limite; e quem encerra o processo quando o ambiente apresenta uma anomalia
Estado e ciclo de vida são muitas vezes fundidos num único campo. É a solução mais fácil e também a mais cara. O estado responde como o ambiente está agora; o ciclo de vida responde quem pode agir sobre ele a seguir. Em produção, os problemas reais aparecem quase sempre no segundo ponto: uma tarefa falha e ninguém liberta o ambiente, ou um ambiente ainda em execução é recuperado e só no arranque seguinte se percebe que a saída mudou.
Uma abstração errada cobra o preço quando o sistema cresce
Com dez ambientes, pode não parecer haver problema algum. Ao chegar a dezenas ou centenas, os problemas surgem todos ao mesmo tempo:
- Adicionar um novo tipo de dispositivo exige alterar o módulo de contas, ampliando o âmbito da regressão da camada de dispositivos para a camada de contas
- Trocar de dispositivo exige alterar a base de dados, por isso a equipa de operações evita fazê-lo e o sistema acaba por ser mantido apenas por programadores
- Sem registos de estado e ocupação, ambientes deixados por saídas anómalas não são recuperados e os ambientes zombie acumulam-se
- Tarefas, conteúdo e automação das camadas superiores são construídos com base numa relação um-para-um entre conta e dispositivo; mudar essa premissa obriga a refazer toda a cadeia
Dispositivos de origens diferentes variam muito na implementação: ambientes de navegador locais e telefones na nuvem usam interfaces distintas. A função da camada de abstração é colocá-los atrás do mesmo conjunto de interfaces. Para adicionar um tipo de dispositivo, deve bastar criar um adaptador que implemente arranque, paragem e consulta de estado; a lógica das camadas superiores não precisa de mudar. Há também um teste simples para avaliar se a abstração está correta: ao adicionar um tipo de dispositivo, o código que precisa de ser alterado fica limitado a um único ficheiro?
Na primeira fase, fazer menos é melhor
Depois de definir o modelo técnico, a interface torna-se muito mais natural. Os menus devem ser organizados por objetos de negócio, com áreas separadas para contas, tarefas e dispositivos, em vez de configuração, parâmetros e registos. O estado e as anomalias devem ser os elementos mais visíveis, porque os utilizadores querem saber se existe algum problema, não quantos registos existem.
Em termos de funções, a primeira fase precisa apenas de uma lista de dispositivos, da opção de adicionar dispositivos e de um fluxo mínimo de tarefa de ponta a ponta. Reduza o menu ao necessário, faça primeiro uma coisa funcionar completamente e deixe o que não é necessário para depois.
Se não quiser implementar o isolamento de ambientes do zero, também pode recorrer a capacidades já existentes. PurpleMark fornece ambientes independentes e associação de saída, suporta criação em lote por grupo e consultas de estado. A camada superior só precisa de implementar modelos, ocupação e agendamento de tarefas, mantendo o esforço de engenharia concentrado na lógica de negócio.
A complexidade de um sistema de múltiplas contas nunca está no número de contas, mas na gestão do ciclo de vida dos dispositivos. Trate primeiro cada dispositivo como um recurso com identidade, saída, estado e ciclo de vida, e as funções das camadas superiores não terão de ser reconstruídas sempre que algo for acrescentado.


