
Przy budowie systemu zarządzania wieloma kontami najpierw warto zdefiniować nie interfejs, lecz pola i cykl życia warstwy urządzeń. Błędna abstrakcja powoduje kaskadę przeróbek, gdy rośnie liczba kont lub zmieniają się typy urządzeń.
Podczas tworzenia systemu zarządzania wieloma kontami pierwsza wersja zwykle zaczyna się od interfejsu: lista kont, profil przeglądarki przypisany do każdego konta, a następnie wywołania interfejsów wykonujące operacje. Wygląda to wystarczająco, dopóki system nie zacznie naprawdę działać.
Pierwsza implementacja jest zazwyczaj bardzo bezpośrednia. Konto A wskazuje profil 001, konto B profil 002, a konto C jest powiązane z telefonem w chmurze. Problemy pojawiają się w trzech miejscach: zespół operacyjny zgłasza awarię maszyny i pyta, czy konto A można przenieść na telefon w chmurze, a odpowiedź brzmi: zmiana bazy, ręczna operacja i ryzyko; pojawia się nowe źródło urządzeń i okazuje się, że jego dodanie wymaga przebudowy modułu kont; albo to samo konto ma rano działać w środowisku przeglądarkowym, a po południu na telefonie w chmurze, czego praktycznie nie da się sensownie rozplanować.
Te trzy sytuacje wyglądają na niezależne, ale mają jedną przyczynę: encja konta zawiera dane, które do niej nie należą. Bieżące urządzenie logowania, wcześniej używane urządzenia, parametry fingerprintu i adres wyjściowy są zapisane bezpośrednio na koncie. W efekcie zmiana urządzenia oznacza zmianę konta, a jedna modyfikacja pociąga za sobą kolejne.
Urządzenie powinno być osobnym typem obiektu
Po rozdzieleniu pojęć konta i urządzenia powinny pozostawać w relacji wiele-do-wielu. Konto nie przechowuje fingerprintu, a jedynie informację o urządzeniu, z którym jest obecnie powiązane. Zmiana urządzenia powinna być operacją atomową, historia powiązań powinna trafić do osobnej tabeli, a każde urządzenie powinno mieć unikalny identyfikator, będący jedyną referencją widoczną na zewnątrz, ze statusem dostępnym w czasie rzeczywistym.
Nie chodzi o to, by model wyglądał elegancko. Chodzi o skrócenie dystansu między zmianą potrzebną zespołowi operacyjnemu a zmianą kodu po stronie programistów, a ten dystans rośnie wraz z liczbą urządzeń.
Cztery grupy pól, które warstwa abstrakcji musi jasno określić
Skalowalna abstrakcja urządzeń musi na zewnątrz odpowiadać tylko na cztery pytania.
- ID środowiska: unikalne i stabilne. Wyższe warstwy odwołują się do środowiska wyłącznie przez ten identyfikator; wewnętrzne numery, nazwy kontenerów i identyfikatory procesów nie powinny być ujawniane
- Powiązanie wyjścia: przez jakie wyjście sieciowe środowisko komunikuje się na zewnątrz oraz czy odpowiadające mu strefa czasowa, język i DNS są skonfigurowane jako jeden spójny zestaw. Oddzielenie wyjścia pozwala je zmienić bez zmiany samego środowiska
- Status: tworzenie, gotowe do uruchomienia, uruchomione, zajęte przez zadanie, nieprawidłowe, oczekujące na odzyskanie. Bez modelu statusów nie da się sensownie zarządzać pulą i odzyskiwaniem
- Cykl życia: kto uruchamia tworzenie, start, zajęcie, zwolnienie i odzyskanie; co dzieje się po przekroczeniu limitu czasu zadania; i kto sprząta po awarii środowiska
Status i cykl życia są często łączone w jedno pole. To najprostsze, ale zarazem najdroższe rozwiązanie. Status mówi, w jakim stanie środowisko jest teraz; cykl życia mówi, kto może wykonać kolejny krok. W produkcji prawdziwe problemy niemal zawsze dotyczą tego drugiego: zadanie się wysypuje i nikt nie zwalnia środowiska albo środowisko zostaje odzyskane, mimo że nadal działa, a dopiero przy kolejnym uruchomieniu wychodzi na jaw, że wyjście się zmieniło.
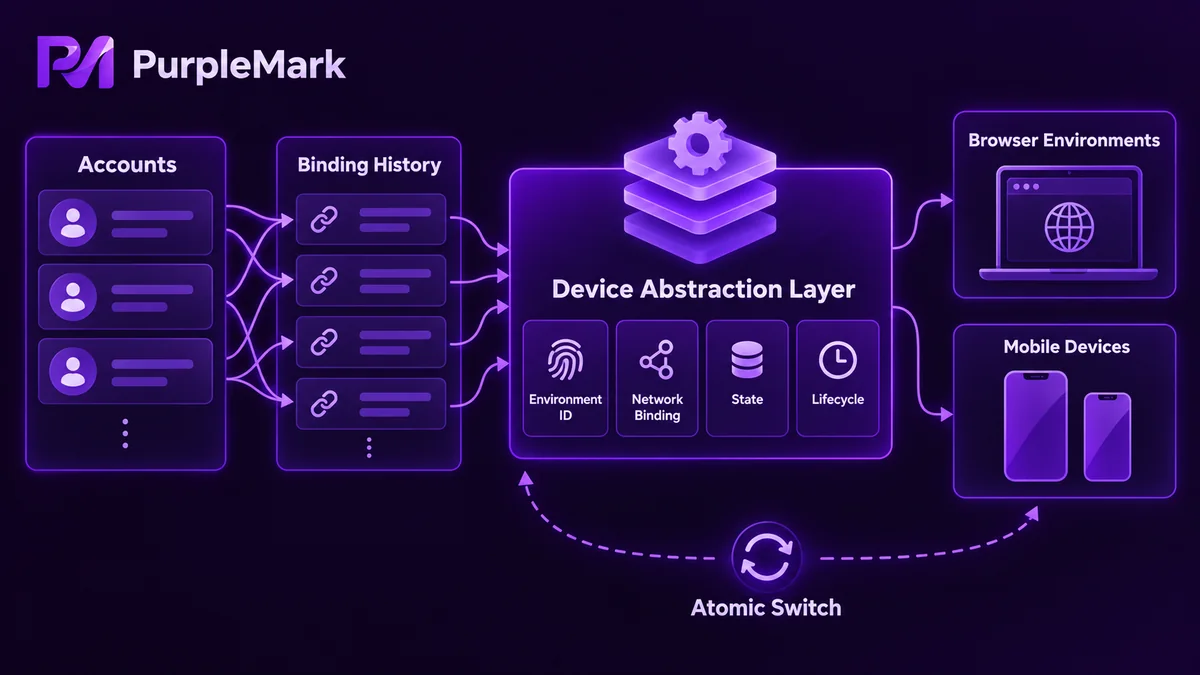
Błędna abstrakcja wystawia rachunek przy skalowaniu
Przy dziesięciu środowiskach można niczego nie zauważyć. Przy dziesiątkach lub setkach problemy pojawiają się naraz:
- Dodanie nowego typu urządzenia wymaga zmian w module kont, więc zakres regresji rozszerza się z warstwy urządzeń na warstwę kont
- Zmiana urządzenia wymaga modyfikacji bazy danych, przez co zespół operacyjny boi się jej wykonywać, a system stopniowo staje się utrzymywalny wyłącznie przez programistów
- Bez rejestru statusu i zajętości środowiska pozostawione po nieprawidłowym zakończeniu nie są odzyskiwane, a środowiska zombie narastają
- Zadania, treści i automatyzacja wyższych warstw opierają się na relacji jeden-do-jednego między kontem a urządzeniem, więc zmiana tej podstawy wymaga przebudowy całego łańcucha
Urządzenia z różnych źródeł bardzo różnią się implementacją: lokalne środowiska przeglądarkowe i telefony w chmurze korzystają z innych interfejsów. Zadaniem warstwy abstrakcji jest ukrycie ich za tym samym zestawem interfejsów. Aby dodać nowy typ urządzenia, powinno wystarczyć dopisanie adaptera realizującego uruchamianie, zatrzymywanie i odczyt statusu; logika wyższych warstw nie powinna się zmieniać. Jest też prosty test jakości abstrakcji: czy po dodaniu nowego typu urządzenia zmiany w kodzie mieszczą się w jednym pliku?
W pierwszej fazie rób jak najmniej
Po ustaleniu modelu technicznego interfejs staje się znacznie bardziej naturalny. Menu warto organizować według obiektów biznesowych, z osobnymi obszarami dla kont, zadań i urządzeń, zamiast według konfiguracji, parametrów i logów. Najbardziej widoczne powinny być statusy i wyjątki, ponieważ użytkownik chce wiedzieć, czy jest problem, a nie ile istnieje rekordów.
W pierwszej fazie funkcjonalnie wystarczy lista urządzeń, dodawanie urządzeń i jeden minimalny zamknięty przepływ zadania. Menu powinno być możliwie małe: najpierw należy doprowadzić jedną rzecz do pełnego działania, a elementy niepotrzebne odłożyć.
Jeśli nie chcesz budować izolacji środowisk od zera, możesz skorzystać z gotowych możliwości. PurpleMark zapewnia niezależne środowiska i powiązanie wyjścia, obsługuje grupowe tworzenie wsadowe oraz zapytania o status. Wyższa warstwa musi wtedy zaimplementować tylko szablony, zajętość i harmonogramowanie zadań, dzięki czemu wysiłek inżynieryjny pozostaje przy logice biznesowej.
Złożoność systemu wielokontowego nigdy nie wynika z liczby kont, lecz z zarządzania cyklem życia urządzeń. Jeśli urządzenie od początku potraktujesz jako zasób z tożsamością, wyjściem, statusem i cyklem życia, funkcje wyższych warstw nie będą musiały być przebudowywane przy każdym rozszerzeniu.


