
Bij het bouwen van een multi-accountbeheersysteem moet je niet eerst de interface vastleggen, maar de velden en levenscyclus van de apparaatlaag. Een verkeerde abstractie leidt tot kettingreacties van herbouw zodra het aantal accounts groeit of apparaattypen veranderen.
Bij de ontwikkeling van een multi-accountbeheersysteem begint de eerste versie vaak bij de interface: maak een accountlijst, koppel aan elk account een browserprofiel en roep vervolgens interfaces aan om acties uit te voeren. Dat lijkt voldoende, totdat het systeem echt gaat draaien.
De eerste implementatie is meestal heel direct. Account A wijst naar profiel 001, account B naar profiel 002 en account C is gekoppeld aan een cloudtelefoon. Problemen duiken dan op drie plaatsen op: operations meldt dat een machine defect is en vraagt of account A naar de cloudtelefoon kan worden verplaatst, maar dat betekent de database aanpassen, handmatig werken en risico nemen; er wordt een nieuwe apparaatbron aangesloten en op de vraag hoe die moet worden toegevoegd, blijkt dat de accountmodule moet worden herbouwd; of hetzelfde account moet 's ochtends een browseromgeving gebruiken en 's middags een cloudtelefoon, wat vrijwel niet netjes per tijdsblok is in te plannen.
Deze drie situaties lijken los van elkaar te staan, maar hebben één oorzaak: het accountobject bevat gegevens die daar niet thuishoren. Het momenteel aangemelde apparaat, eerder gebruikte apparaten, fingerprintparameters en het uitgaande adres worden allemaal op het account opgeslagen. Daardoor staat een apparaatwissel gelijk aan een accountwijziging, met gevolgen door het hele systeem.
Maak van het apparaat een afzonderlijk objecttype
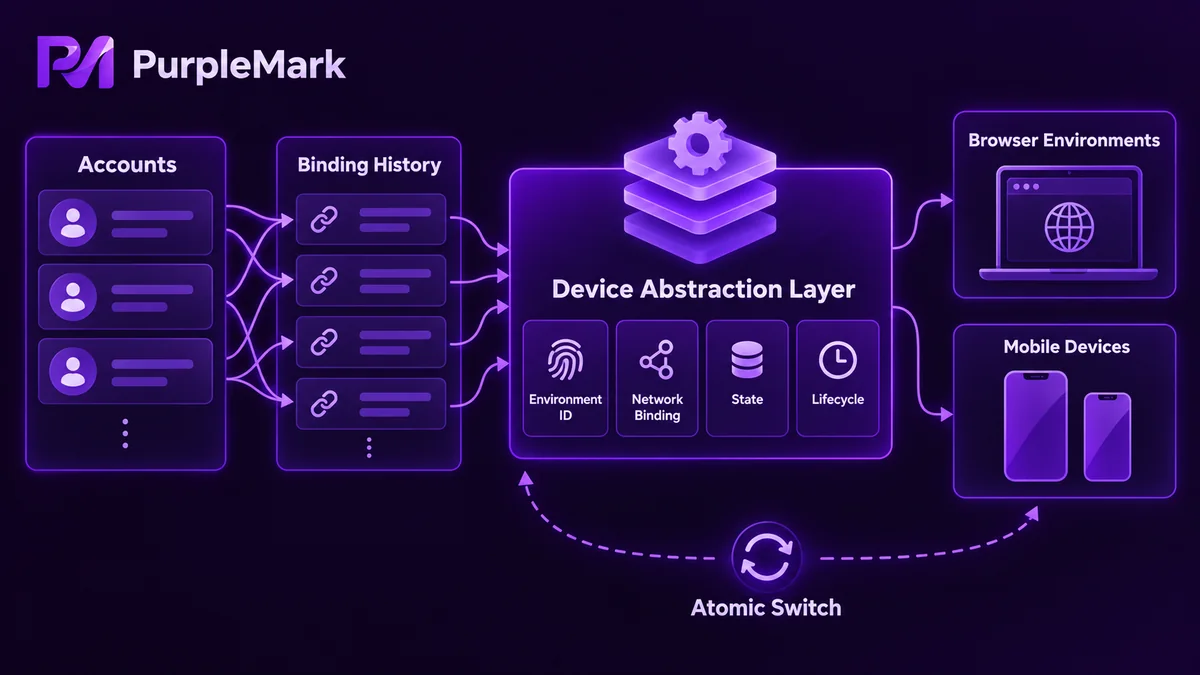
Na de scheiding moeten accounts en apparaten een veel-op-veelrelatie hebben. Het account slaat geen fingerprint op, maar registreert alleen aan welk apparaat het op dat moment is gekoppeld. Een apparaatwissel wordt een atomaire bewerking, historische koppelingen worden in een aparte tabel bewaard en elk apparaat krijgt een unieke identifier die als enige extern wordt gebruikt, terwijl de status realtime kan worden opgevraagd.
Dit is niet bedoeld om het model mooier te maken. Het verkort de afstand tussen een aanpassing die operations wil uitvoeren en een codewijziging die development moet doen, en die afstand groeit mee met het aantal apparaten.
Vier veldcategorieën die de abstractielaag duidelijk moet definiëren
Een schaalbare apparaatabstractie hoeft naar buiten toe maar vier zaken te beantwoorden.
- Omgevings-ID: uniek en stabiel. Hogere lagen verwijzen alleen via deze ID naar de omgeving; interne nummers, containernamen en proces-ID's mogen niet worden blootgesteld
- Uitgangskoppeling: via welke netwerkuitgang de omgeving naar buiten gaat en of de bijbehorende tijdzone, taal en DNS als één samenhangende set zijn geconfigureerd. Door de uitgang apart te abstraheren kan die worden gewijzigd zonder de omgeving zelf te veranderen
- Status: wordt aangemaakt, klaar om te starten, actief, bezet door een taak, afwijkend, wacht op terugwinning. Zonder statusmodel zijn pooling en terugwinning niet goed te beheren
- Levenscyclus: wie aanmaak, start, bezetting, vrijgave en terugwinning activeert; wat er gebeurt bij een taak-time-out; en wie opruimt als de omgeving een fout heeft
Status en levenscyclus worden vaak samengevoegd tot één veld. Dat is de gemakkelijkste en tegelijk de duurste oplossing. Status beschrijft hoe de omgeving er nu voor staat; de levenscyclus bepaalt wie er vervolgens iets mee mag doen. In productie ontstaan de echte problemen bijna altijd bij dat tweede punt: een taak crasht en niemand geeft de omgeving vrij, of een nog actieve omgeving wordt teruggewonnen en pas bij de volgende start blijkt dat de uitgang is veranderd.
Een verkeerde abstractie wordt duur zodra je schaalt
Bij tien omgevingen lijkt er vaak niets aan de hand. Bij tientallen of honderden komen de problemen tegelijk:
- Voor een nieuw apparaattype moet de accountmodule worden aangepast, waardoor regressietests van de apparaatlaag naar de accountlaag uitbreiden
- Een apparaatwissel vereist een databasewijziging, waardoor operations er liever niet aan komt en het systeem geleidelijk alleen nog door developers kan worden onderhouden
- Zonder status- en bezettingsregistratie worden omgevingen die na abnormale afsluitingen achterblijven niet teruggewonnen en stapelen zombie-omgevingen zich op
- Taken, content en automatisering in hogere lagen zijn gebaseerd op een één-op-éénrelatie tussen account en apparaat; een wijziging betekent dat de hele keten opnieuw moet worden opgebouwd
Apparaten uit verschillende bronnen verschillen sterk in implementatie. Lokale browseromgevingen en cloudtelefoons gebruiken bijvoorbeeld totaal andere interfaces. De abstractielaag zet ze achter dezelfde set interfaces. Om een nieuw apparaattype toe te voegen, zou het voldoende moeten zijn om een adapter te maken voor starten, stoppen en statusopvraging; de logica in hogere lagen hoeft dan niet te wijzigen. Er is ook een eenvoudige praktijktest: blijft de codewijziging voor een nieuw apparaattype beperkt tot één bestand?
Doe in de eerste fase zo weinig mogelijk
Zodra het technische model vaststaat, wordt de interface vanzelf logischer. Orden menu's op bedrijfsobjecten, met aparte onderdelen voor accounts, taken en apparaten, in plaats van configuratie, parameters en logs centraal te stellen. Status en uitzonderingen moeten het meest opvallen, want gebruikers willen weten of er problemen zijn, niet hoeveel records er bestaan.
Functioneel is voor de eerste fase een apparatenlijst, de mogelijkheid om apparaten toe te voegen en één minimale end-to-end taakstroom voldoende. Houd het menu zo klein mogelijk, zorg eerst dat één proces volledig werkt en stel alles wat niet nodig is uit.
Als je omgevingsisolatie niet vanaf nul wilt bouwen, kun je bestaande mogelijkheden gebruiken. PurpleMark biedt onafhankelijke omgevingen en uitgangskoppeling, ondersteunt batchgewijze creatie per groep en statusopvraging. De hogere laag hoeft dan alleen sjablonen, bezetting en taakplanning te implementeren, zodat ontwikkelcapaciteit in de bedrijfslogica kan blijven.
De complexiteit van een multi-accountsysteem zit nooit in het aantal accounts, maar in het beheer van de levenscyclus van apparaten. Behandel een apparaat eerst als een resource met een identiteit, uitgang, status en levenscyclus, zodat functies in hogere lagen niet bij elke uitbreiding opnieuw hoeven te worden gebouwd.


