
Під час створення системи керування кількома акаунтами спочатку варто визначити не інтерфейс, а поля й життєвий цикл шару пристроїв. Невдала абстракція спричиняє каскад переробок, коли зростає кількість акаунтів або змінюються типи пристроїв.
Під час розробки системи керування кількома акаунтами першу версію найчастіше починають з інтерфейсу: створюють список акаунтів, до кожного прив’язують профіль браузера, а потім викликають інтерфейси для виконання операцій. Це здається достатнім, доки система не починає працювати по-справжньому.
Перша реалізація зазвичай дуже прямолінійна. Акаунт A вказує на профіль 001, акаунт B — на профіль 002, а акаунт C під’єднаний до хмарного телефона. Далі проблеми з’являються в трьох місцях: операційна команда каже, що машина зламалася, і питає, чи можна перенести акаунт A на хмарний телефон, але відповідь означає зміну бази даних, ручну роботу й ризик; підключається нове джерело пристроїв, і на запитання, як його додати, з’ясовується, що треба переробляти модуль акаунтів; або один і той самий акаунт має вранці працювати в браузерному середовищі, а після обіду — на хмарному телефоні, що майже неможливо нормально організувати за часовими слотами.
Ці три сценарії здаються не пов’язаними, але причина в них одна: у сутність акаунта поміщено дані, які їй не належать. Поточний пристрій входу, раніше використані пристрої, параметри відбитка та вихідна адреса зберігаються безпосередньо в акаунті. У результаті зміна пристрою стає зміною акаунта й тягне наслідки для всієї системи.
Пристрій має бути окремим типом об’єкта
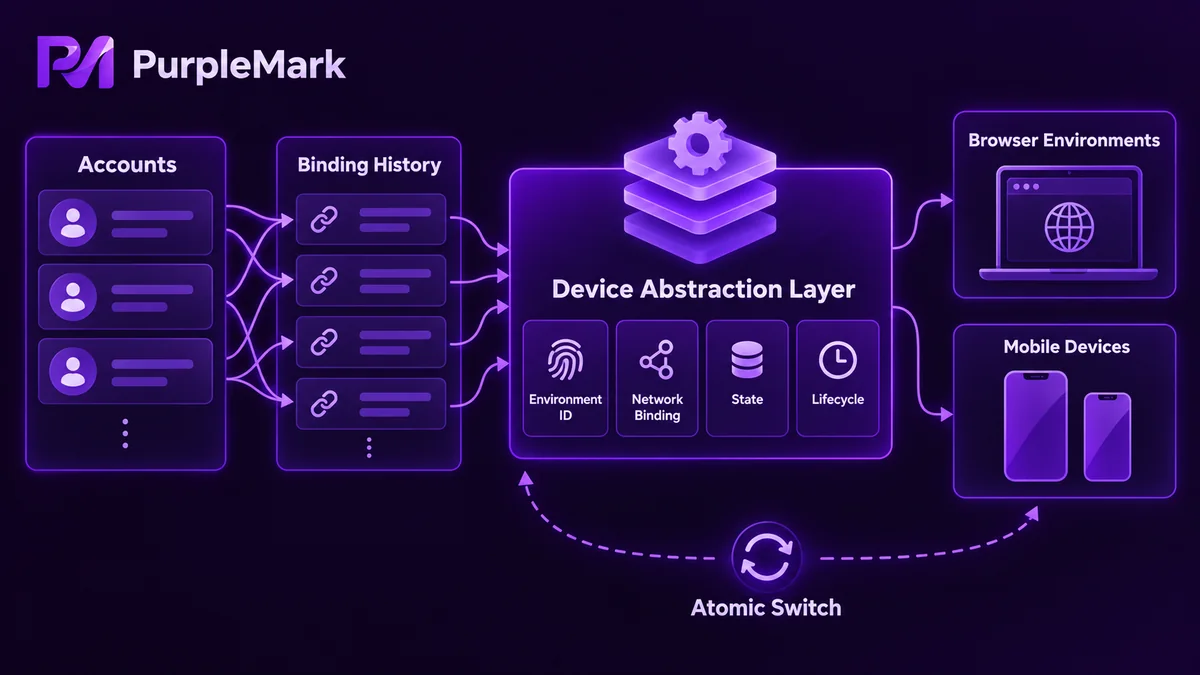
Після розділення акаунти та пристрої повинні мати зв’язок багато-до-багатьох. Акаунт не зберігає відбиток, а лише фіксує, до якого пристрою він прив’язаний зараз. Зміну пристрою слід виконувати як атомарну операцію, історію прив’язок зберігати в окремій таблиці, а кожен пристрій має мати унікальний ідентифікатор — єдине зовнішнє посилання на нього — зі статусом, доступним у реальному часі.
Це робиться не заради красивої моделі. Такий підхід скорочує відстань між зміною, яку хоче зробити операційна команда, і зміною коду, яку має внести розробка, а ця відстань зростає разом із кількістю пристроїв.
Чотири групи полів, які шар абстракції має чітко визначити
Масштабована абстракція пристроїв повинна назовні відповідати лише на чотири запитання.
- ID середовища: унікальний і стабільний. Верхні шари посилаються на середовище тільки через нього; внутрішні номери, назви контейнерів та ID процесів не повинні бути видимі зовні
- Прив’язка виходу: через який мережевий вихід працює середовище і чи утворюють пов’язані часовий пояс, мова та DNS узгоджений набір. Винесення виходу в окрему абстракцію дає змогу змінювати його без зміни самого середовища
- Статус: створюється, готове до запуску, працює, зайняте завданням, аварійне, очікує повернення. Без моделі статусів неможливо нормально керувати пулом і поверненням ресурсів
- Життєвий цикл: хто запускає створення, старт, зайняття, звільнення та повернення; що відбувається при тайм-ауті завдання; і хто завершує очищення, якщо середовище працює ненормально
Статус і життєвий цикл часто об’єднують в одне поле. Це найпростіший і водночас найдорожчий варіант. Статус відповідає, яким середовище є зараз; життєвий цикл — хто може діяти з ним наступним. У продакшені справжні проблеми майже завжди виникають у другій частині: завдання падає, а середовище ніхто не звільняє, або ще активне середовище повертають у пул, і лише під час наступного запуску з’ясовується, що вихід уже змінився.
Помилка в абстракції виставляє рахунок під час масштабування
При десяти середовищах проблеми можуть бути непомітні. При десятках або сотнях вони з’являються одночасно:
- Додавання нового типу пристрою вимагає змін у модулі акаунтів, тому область регресійного тестування розширюється із шару пристроїв на шар акаунтів
- Зміна пристрою вимагає правки бази даних, через що операційна команда боїться це робити, а систему поступово можуть підтримувати лише розробники
- Без записів про статус і зайнятість середовища, що залишилися після аварійних завершень, не повертаються, а «зомбі»-середовища накопичуються
- Завдання, контент і автоматизація верхніх шарів побудовані на припущенні про зв’язок один-до-одного між акаунтом і пристроєм, тому зміна цієї основи вимагає переробки всього ланцюга
Пристрої з різних джерел дуже відрізняються реалізацією: локальні браузерні середовища та хмарні телефони використовують зовсім різні інтерфейси. Завдання шару абстракції — сховати їх за одним набором інтерфейсів. Для додавання нового типу пристрою має бути достатньо адаптера, який реалізує запуск, зупинку та запит статусу; логіка верхніх шарів не повинна змінюватися. Є й простий практичний тест якості абстракції: чи обмежується зміна коду одним файлом, коли додається новий тип пристрою?
На першому етапі краще зробити якомога менше
Коли технічну модель визначено, інтерфейс стає значно природнішим. Меню слід організовувати за бізнес-об’єктами: окремі розділи для акаунтів, завдань і пристроїв, а не для конфігурації, параметрів і журналів. Найпомітнішими мають бути статус і винятки, тому що користувач шукає проблеми, а не кількість записів.
Функціонально на першому етапі достатньо списку пристроїв, додавання пристроїв і одного мінімального наскрізного циклу виконання завдання. Меню варто максимально скоротити, спочатку повністю запустити один сценарій і відкласти все непотрібне.
Якщо не хочеться реалізовувати ізоляцію середовищ з нуля, можна скористатися готовими можливостями. PurpleMark надає незалежні середовища та прив’язку виходу, підтримує пакетне створення за групами й запити статусу. Верхньому шару залишається реалізувати шаблони, зайнятість і планування завдань, зберігаючи інженерні ресурси для бізнес-логіки.
Складність системи з кількома акаунтами полягає не в їх кількості, а в керуванні життєвим циклом пристроїв. Якщо спочатку розглядати пристрій як ресурс з ідентичністю, виходом, статусом і життєвим циклом, функції верхніх шарів не доведеться перебудовувати при кожному розширенні.


