
तैयार MCP Server आम तौर पर केवल primitives देते हैं, इसलिए Agent को हर बार business actions को फिर से जोड़ना और बीच की विफलताओं पर फैसला करना पड़ता है। एक पतला Flask adapter layer tool declarations, routing, execution, validation और error semantics को एक जगह ला सकता है।
Browser environment को AI Agent से जोड़ते समय एक बात से बचा नहीं जा सकता: standard tools primitives देते हैं, लेकिन business actions आपको खुद जोड़ने पड़ते हैं।
एक ठोस उदाहरण लें। किसी collection run को पूरा करने का वास्तविक flow है: “region के अनुसार environment खोलें, outbound connection जोड़ें, warm-up के लिए एक बार visit करें और पुष्टि करें कि outbound connection काम कर रहा है,” और उसके बाद ही काम Agent को दें। तैयार MCP Server आम तौर पर environment खोलना, navigation, click और screenshot जैसे single-step tools देते हैं। ऊपर वाली combined logic कोई आपके लिए नहीं बनाता। Agent को हर बार शुरुआत से क्रम बनाना पड़ता है, जो धीमा है, और बीच का कोई भी step fail हो तो उसे खुद तय करना पड़ता है कि आगे क्या करना है।
Adapter layer इसी काम के लिए है: composition logic, validation और state को अपनी तरफ रखें और बाहर केवल एक business action expose करें।
न्यूनतम उपयोगी संरचना
चलने योग्य adapter layer के लिए केवल तीन हिस्से चाहिए: tool declaration, request routing, और execution with return. Flask के साथ ये सब एक ही process में रह सकते हैं।
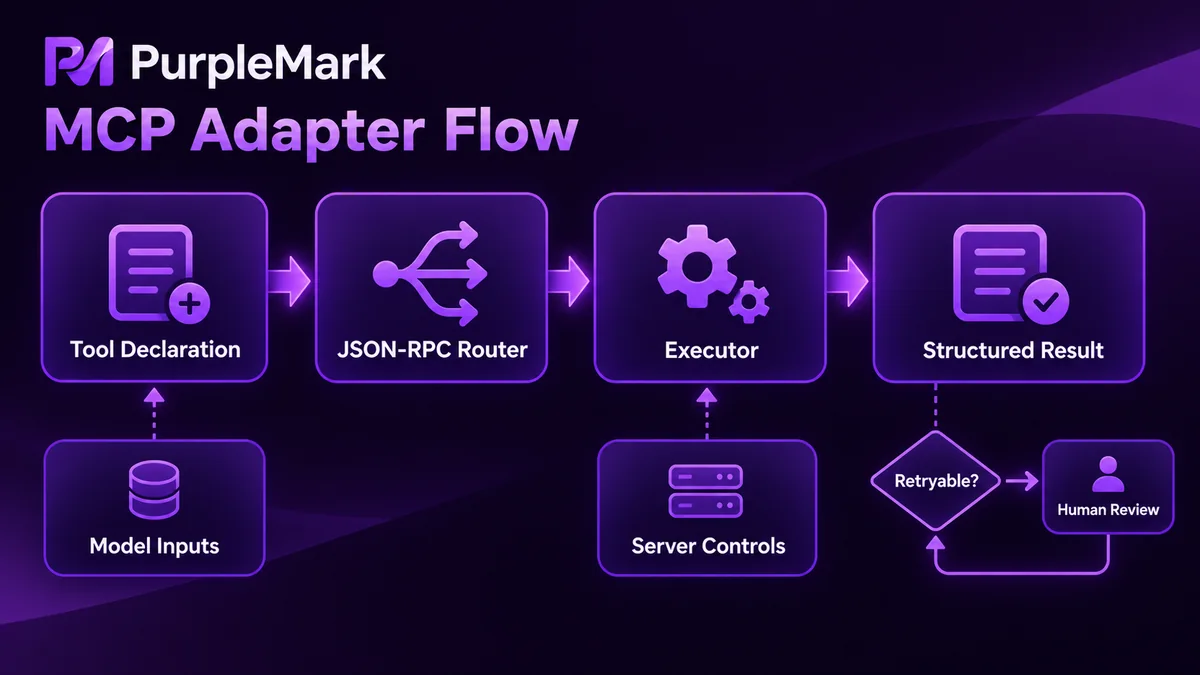
पहले tool declaration देखें; यही तय करता है कि Agent क्या देख सकता है।
# adapter/tools.py
TOOLS = [
    {
        "name": "prepare_environment",
        "description": "किसी region के लिए उपलब्ध environment तैयार करें और पूरा होने पर environment ID लौटाएँ",
        "inputSchema": {
            "type": "object",
            "properties": {
                "region": {"type": "string", "description": "Outbound region, जैसे US-CA"},
                "purpose": {"type": "string", "description": "Reuse और quota statistics के लिए purpose label"},
                "timeout": {"type": "integer", "minimum": 10, "maximum": 120, "default": 60},
            },
            "required": ["region"],
            "additionalProperties": False,
        },
    },
    {
        "name": "open_page",
        "description": "दिए गए environment में page खोलें और interactive होने तक प्रतीक्षा करें",
        "inputSchema": {
            "type": "object",
            "properties": {
                "env_id": {"type": "string"},
                "url": {"type": "string"},
            },
            "required": ["env_id", "url"],
            "additionalProperties": False,
        },
    },
]
Router JSON-RPC methods को dispatch करता है। Client पहले tools/list पूछता है, फिर नाम के आधार पर tools/call करता है।
# adapter/app.py
from flask import Flask, request, jsonify
from adapter.tools import TOOLS
from adapter.runner import run_tool

app = Flask(__name__)

@app.post("/mcp")
def mcp():
    req = request.get_json(force=True)
    method, rid = req.get("method"), req.get("id")

    if method == "tools/list":
        return jsonify({"jsonrpc": "2.0", "id": rid, "result": {"tools": TOOLS}})

    if method == "tools/call":
        name = req["params"]["name"]
        args = req["params"].get("arguments", {})
        return jsonify({"jsonrpc": "2.0", "id": rid, "result": run_tool(name, args)})

    return jsonify({"jsonrpc": "2.0", "id": rid,
                    "error": {"code": -32601, "message": "method not found"}})
Execution layer ही वह एकमात्र जगह है जो environment API और page protocol को छूती है। Multi-step sequence यहीं पूरी होती है और failures को यहीं एक समान format में बदला जाता है।
# adapter/runner.py
def run_tool(name, args):
    try:
        payload = HANDLERS[name](**args)
        return ok(payload)
    except ToolError as e:
        return fail(e.code, e.retryable, e.message)
Return format जल्दी तय कर लेना बेहतर है। Low-level exceptions को जस का तस Agent को न दें; वह उन strings को parse करने की कोशिश करेगा और अजीब फैसले ले सकता है। Result code वाली संरचना तय करें, जैसे {"ok": false, "code": "env_unavailable", "retryable": true, "attempts": 3}। तब Agent को सिर्फ दो बातें तय करनी हैं: क्या retry किया जा सकता है और क्या मामला किसी इंसान को देना चाहिए।
Parameters कैसे डिजाइन करें
Tool granularity business actions के आधार पर तय करें, APIs के आधार पर नहीं। हर low-level endpoint को अलग tool में wrap करना लगभग कोई abstraction न होने जैसा है; Agent को steps का क्रम फिर भी खुद तय करना पड़ेगा।
Parameters में साफ सीमा होनी चाहिए: क्या model तय करेगा और क्या adapter layer खुद तय करेगा। Region, purpose और target URL पहली श्रेणी में आते हैं, इसलिए model उन्हें भरे। Debug port, internal queue names और कौन-सा environment pool इस्तेमाल होगा दूसरी श्रेणी में आते हैं; इन्हें schema में न रखें, वरना देर-सबेर model इन्हें गलत भर देगा।
Selectors अक्सर समस्या बनते हैं। Page structure बदलते ही hard-coded selector वाली calls एक साथ टूट सकती हैं। Model से semantic target दिलवाना बेहतर है, जैसे “login button” जैसा अपेक्षाकृत स्थिर संकेत, और selector mapping को adapter layer में रखें। तब बदलाव होने पर एक ही जगह सुधारना होगा।
Numeric parameters की upper limit जरूर होनी चाहिए। अगर timeout, retry count या page count पर schema में maximum नहीं है, तो model बहुत बड़ा value दे सकता है और एक call को दस मिनट से भी लंबा बना सकता है। Loop semantics वाले हर tool में स्पष्ट अंत होना चाहिए। “Data खत्म होने तक paginate करो” की जगह max_pages जैसा field रखें।
Idempotency पर भी ध्यान दें। Caller से task_id दिलवाएँ; repeated request पर पिछला result सीधे लौटाया जा सकता है, ताकि Agent के retry से environment दो बार न खुले।
Return values छोटे रखें। Screenshot को base64 में न लौटाएँ; file reference दें। List results में count और truncation flag दें, पूरी table को context में न भरें।
Debugging में पहले इन तीन जगहों को देखें
अगर stdio इस्तेमाल हो रहा है तो JSON-RPC stdout का उपयोग करता है, इसलिए logs को कभी stdout पर न लिखें। एक साधारण print भी protocol parsing तुरंत बिगाड़ सकता है और लंबी debugging करा सकता है। Logs को stderr या file में भेजें।
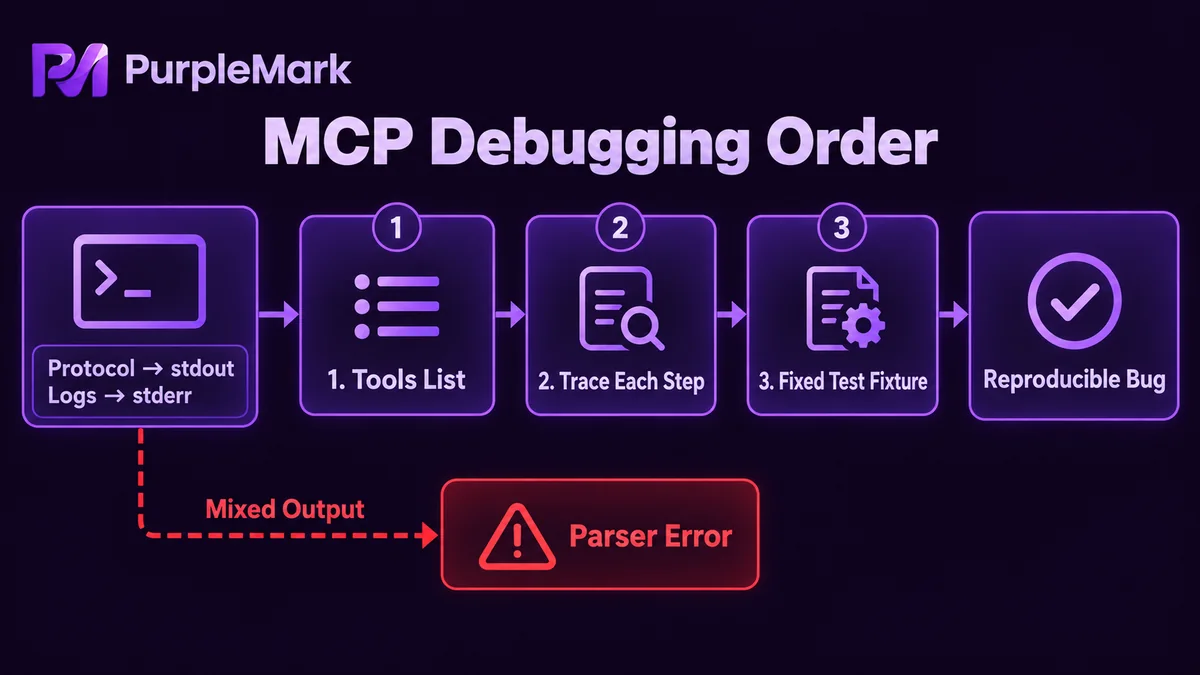
tools/list पहला checkpoint है। अगर declarations लोड नहीं हुईं तो आगे कोई call नहीं होगा। पहले tool names, schema structure और यह देखें कि additionalProperties किसी parameter को रोक तो नहीं रहा।
दूसरा checkpoint step-by-step trace है। हर call के लिए task_id, parameter summary, elapsed time और result code दर्ज करें। समस्या आने पर पता चलेगा कि रुकावट environment creation, navigation या validation में है। Failed cases के original parameters बचाकर रखें ताकि उन्हें ज्यों का त्यों replay किया जा सके — reproducible bug बहुत जल्दी ठीक होता है।
तीसरा checkpoint fixed fixtures का एक set है: stable content वाला test page और कुछ ऐसे element locators जो बदलते नहीं। Adapter layer में हर बदलाव के बाद smoke test चलाना किसी भी मौखिक verification से अधिक प्रभावी है।
Permission boundaries
पूरे system में permissions सबसे अधिक adapter layer के पास केंद्रित होती हैं: credentials, environments और page operations सब उसी के हाथ में हैं। इसलिए boundary यहीं लागू करनी चाहिए।
Credentials को server-side configuration में रखें, tool parameters या model context में नहीं। Tools को risk के अनुसार अलग करें: screenshot और text extraction जैसे read-only tools default रूप से enabled रहें; click, submit और delete जैसे write tools default रूप से disabled रहें और केवल task के लिए अस्थायी रूप से enable हों। इससे model गलत निर्णय ले तब भी नुकसान सीमित रहता है।
Environments को purpose के अनुसार isolate करें। अलग accounts और अलग tasks अलग environments का उपयोग करें; एक environment को मिलाकर न चलाएँ। Multi-account management में environment creation, network outbound binding और state maintenance को dedicated environment layer संभाल सकती है। PurpleMark जैसे tools इसी layer को अलग करते हैं, जबकि adapter layer केवल business composition और validation संभालती है।
Audit logs सुरक्षित रखें। समय के आधार पर export किया जा सके कि किस task ने कौन-सा environment इस्तेमाल किया और कौन-से write tools चलाए। जब सच में समस्या होती है, प्रक्रिया को दोबारा समझने के लिए यही record सबसे महत्वपूर्ण होता है।
अंत में स्पष्ट सीमा: adapter layer को platform rules को bypass करने का कोई रास्ता नहीं देना चाहिए। Bulk registration, verification bypass या identity forgery जैसी actions को tools के रूप में package न करें और न ही internal tools के नाम से छिपाएँ। एक बार tool model को expose हो गया तो calls अपने-आप हो सकती हैं; पहले उन्हें रोकने की भरोसेमंद जगह नहीं रहती और बाद में असर वापस नहीं लिया जा सकता।
Protocol versions और field definitions के लिए आधिकारिक MCP documentation देखें।


