
現成的 MCP Server 多半只提供原語,業務動作仍要由 Agent 每次重新組合並自行判斷失敗處理。用 Flask 做一層輕量適配層,可以集中管理工具宣告、請求路由、執行結果、驗證與錯誤語意。
把瀏覽器環境接進 AI Agent,有一件事繞不開:標準工具提供的是原語,業務動作還是得自己組合。
舉個具體例子。要跑通一次採集,實際流程是「依地區開一個環境、綁好出口、先造訪一次做預熱、確認出口可用」,然後才交給 Agent 工作。現成的 MCP Server 通常只提供開環境、導覽、點擊、截圖等單步工具,上述那串組合邏輯沒有人替你完成。Agent 每次都得從零安排一遍,不但慢,而且中間任何一步失敗都得自己判斷後續處理。
適配層就是用來處理這件事:把組合邏輯、驗證和狀態留在自己這邊,對外只暴露一個業務動作。
最小可用結構
一個能跑起來的適配層只需要三塊:工具宣告、請求路由、執行與回傳。用 Flask 的話,一個行程就能裝下。
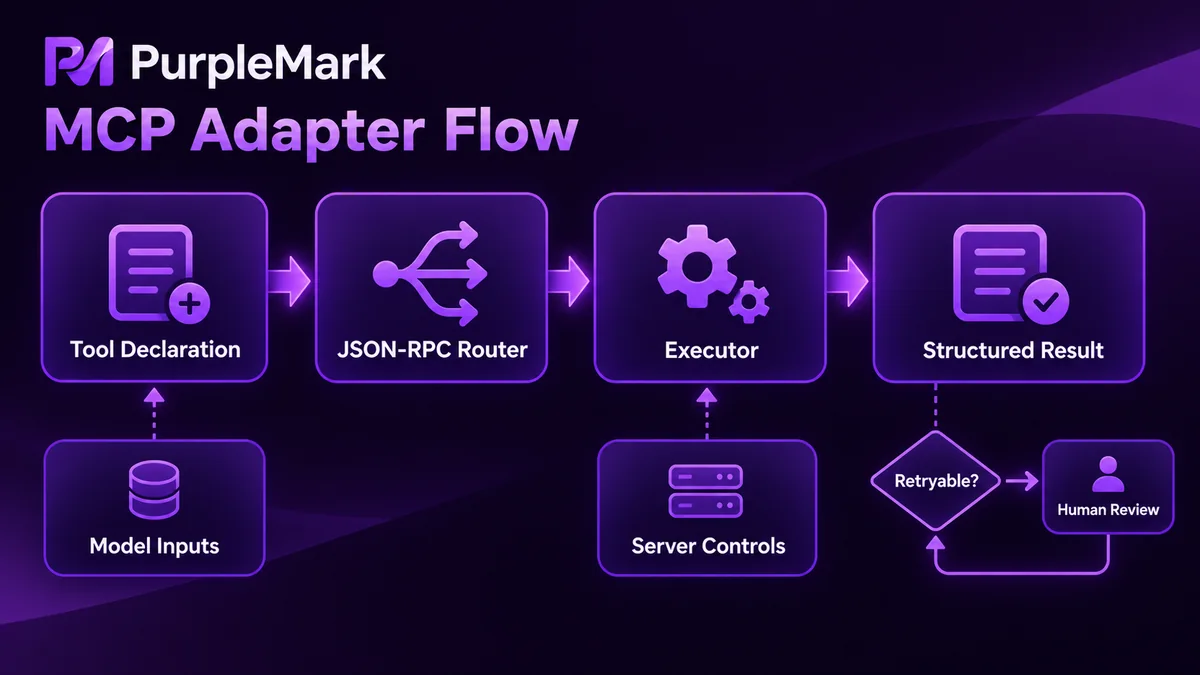
先看工具宣告,它決定 Agent 能看見什麼。
# adapter/tools.py
TOOLS = [
    {
        "name": "prepare_environment",
        "description": "依地區準備一個可用環境,完成後回傳環境 ID",
        "inputSchema": {
            "type": "object",
            "properties": {
                "region": {"type": "string", "description": "出口地區,例如 US-CA"},
                "purpose": {"type": "string", "description": "用途標籤,用於重複使用與配額統計"},
                "timeout": {"type": "integer", "minimum": 10, "maximum": 120, "default": 60},
            },
            "required": ["region"],
            "additionalProperties": False,
        },
    },
    {
        "name": "open_page",
        "description": "在指定環境裡開啟頁面並等待到可互動",
        "inputSchema": {
            "type": "object",
            "properties": {
                "env_id": {"type": "string"},
                "url": {"type": "string"},
            },
            "required": ["env_id", "url"],
            "additionalProperties": False,
        },
    },
]
路由負責分派 JSON-RPC 的方法。用戶端會先詢問 tools/list,再依名稱呼叫 tools/call。
# adapter/app.py
from flask import Flask, request, jsonify
from adapter.tools import TOOLS
from adapter.runner import run_tool

app = Flask(__name__)

@app.post("/mcp")
def mcp():
    req = request.get_json(force=True)
    method, rid = req.get("method"), req.get("id")

    if method == "tools/list":
        return jsonify({"jsonrpc": "2.0", "id": rid, "result": {"tools": TOOLS}})

    if method == "tools/call":
        name = req["params"]["name"]
        args = req["params"].get("arguments", {})
        return jsonify({"jsonrpc": "2.0", "id": rid, "result": run_tool(name, args)})

    return jsonify({"jsonrpc": "2.0", "id": rid,
                    "error": {"code": -32601, "message": "method not found"}})
執行層是唯一碰環境 API 和頁面協定的地方,多步驟串接在這裡完成,失敗也在這裡轉成統一格式。
# adapter/runner.py
def run_tool(name, args):
    try:
        payload = HANDLERS[name](**args)
        return ok(payload)
    except ToolError as e:
        return fail(e.code, e.retryable, e.message)
回傳格式值得提早定下來。不要把底層例外原文丟給 Agent,它會嘗試解析那些字串,然後可能做出莫名其妙的決定。可以約定一個帶結果碼的結構,例如 {"ok": false, "code": "env_unavailable", "retryable": true, "attempts": 3}。這樣 Agent 只需要判斷兩件事:能不能重試,以及要不要交給人處理。
參數怎麼設計
工具粒度要依業務動作切,不要依 API 切。把底層每個 endpoint 都包成一個工具,等於沒有真正封裝,Agent 還是得自己排序。
參數有一條清楚的分界線:哪些該由模型決定,哪些該由適配層自己決定。地區、用途、目標 URL 屬於前者,交給模型填;除錯連接埠、內部佇列名稱、從哪個環境池取資源屬於後者,不要放進 schema,否則早晚會被模型填錯。
Selector 很容易踩坑。頁面結構一變,把 selector 寫死的呼叫就可能成片失效。可以讓模型傳語意化目標,例如「登入按鈕」這類相對穩定的識別,把 selector 對應關係留在適配層維護,改一處就夠。
數值參數一定要有上限。如果 timeout、重試次數、翻頁數量在 schema 裡沒有 maximum,模型可能傳一個很大的值,讓一次呼叫拖成十幾分鐘。凡是帶迴圈語意的工具都要有明確終點,用 max_pages 這類欄位收口,而不是「翻到沒有資料為止」。
冪等也要考慮。讓呼叫端帶一個 task_id,重複請求可以直接回傳上一次結果,避免 Agent 重試時把環境開兩遍。
回傳值盡量小。截圖不要回 base64,回一個檔案參照;列表結果帶 count 和截斷標記,不要把整張表塞進 context。
除錯時先盯這三處
如果走 stdio,JSON-RPC 會占用 stdout,所以日誌絕對不能寫到 stdout。隨手一行 print 就可能讓協定解析當場崩掉,接著排查半天。日誌統一送到 stderr 或檔案。
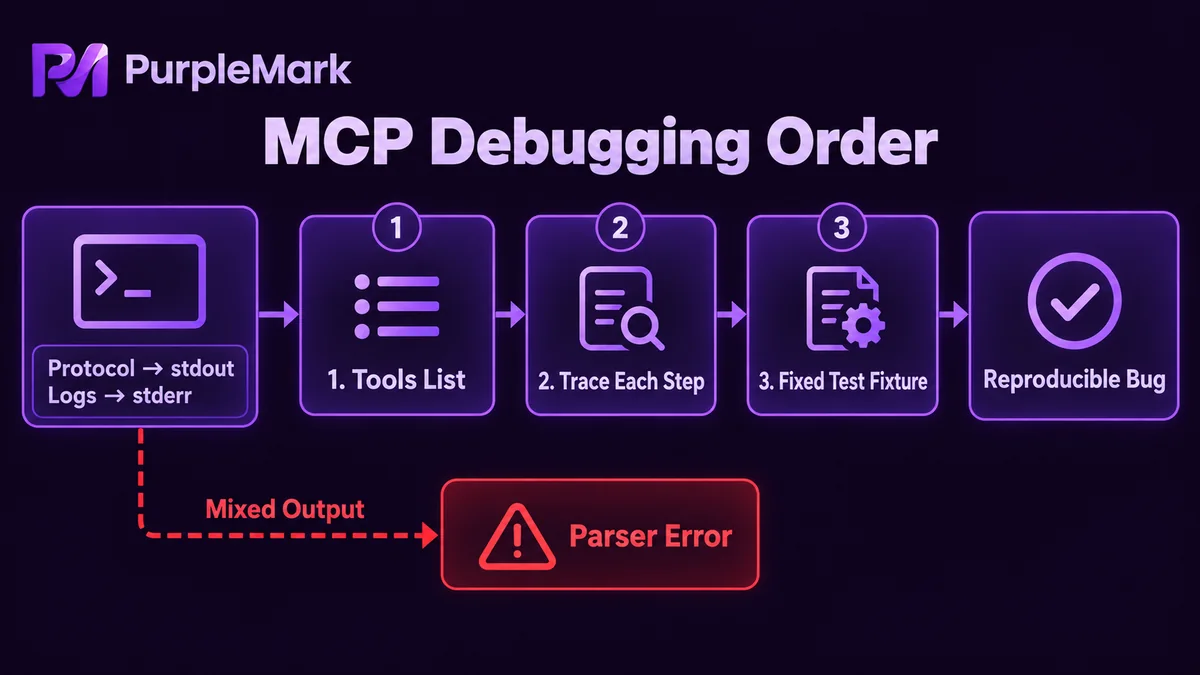
tools/list 是第一個檢查點。宣告沒有被讀到,後面的呼叫都不會發生。先確認工具名稱拼字、schema 結構,以及 additionalProperties 是否把參數擋掉。
第二個檢查點是逐步 trace。每次呼叫都記下 task_id、參數摘要、耗時和結果碼,出問題時就能看出是卡在開環境、導覽還是驗證。失敗案例要保留原始參數,才能原樣重播——能重現的 bug 才修得快。
第三個檢查點是一組固定 fixtures:一個內容穩定的測試頁,配上幾個不會變的元素定位。每次改完適配層跑一次 smoke test,比任何口頭驗證都省事。
權限邊界
適配層是整個系統裡權限最集中的地方,憑證、環境、頁面操作都在它手上,所以邊界只能在這裡劃。
憑證放在伺服器端設定裡,不進工具參數,也不進模型 context。工具依風險程度分開關:截圖、取文字這類唯讀工具預設開啟;點擊、提交、刪除這類寫入工具預設關閉,按任務暫時開啟。這樣就算模型判斷失誤,損失也有上限。
環境依用途隔離。不同帳號、不同任務使用不同環境,不要混用同一套環境。在多帳號管理情境中,環境建立、網路出口綁定和狀態維護可以交給專門的環境層能力。PurpleMark 這類工具就是把這一層隔開,適配層只負責業務組合與驗證。
稽核日誌要保留下來。哪個任務、什麼時間、用了哪個環境、呼叫了哪些寫入工具,都應該能依時間匯出。真的發生問題時,這份紀錄是唯一能還原過程的東西。
最後是底線:適配層不該提供任何繞過平台規則的入口。大量註冊、繞過驗證、偽造身分這類動作,不要包裝成工具,也不要掛在內部工具的名義下。工具一旦暴露給模型,呼叫就可能自動發生,事前沒有可靠的攔截點,事後也無法把影響補回來。
協定版本與欄位定義請以 MCP 官方文件為準。


