
Готові MCP Server зазвичай надають лише базові операції, тому Agent щоразу заново складає бізнес-дії та сам вирішує, як реагувати на збої. Тонкий адаптер на Flask об’єднує оголошення інструментів, маршрутизацію, виконання, перевірку й семантику помилок.
Під час підключення браузерного середовища до AI Agent є неминучий момент: стандартні інструменти дають базові операції, а бізнес-дії все одно доводиться складати самостійно.
Розгляньмо конкретний приклад. Щоб завершити один цикл збору даних, фактична послідовність така: «відкрити середовище для потрібного регіону, прив’язати мережевий вихід, один раз зайти для прогрівання та переконатися, що вихід працює», і лише потім передати роботу Agent. Готовий MCP Server зазвичай пропонує тільки одноетапні інструменти: відкрити середовище, перейти на сторінку, натиснути, зробити знімок екрана. Ніхто не складає наведену послідовність за вас. Agent щоразу мусить будувати її з нуля, що повільно, а при збої на будь-якому проміжному кроці сам вирішувати, що робити далі.
Саме для цього потрібен шар адаптера: логіка композиції, перевірки та стан залишаються на вашому боці, а назовні відкривається лише одна бізнес-дія.
Мінімальна робоча структура
Для робочого шару адаптера достатньо трьох частин: оголошень інструментів, маршрутизації запитів і виконання з поверненням результату. У Flask усе це може працювати в одному процесі.
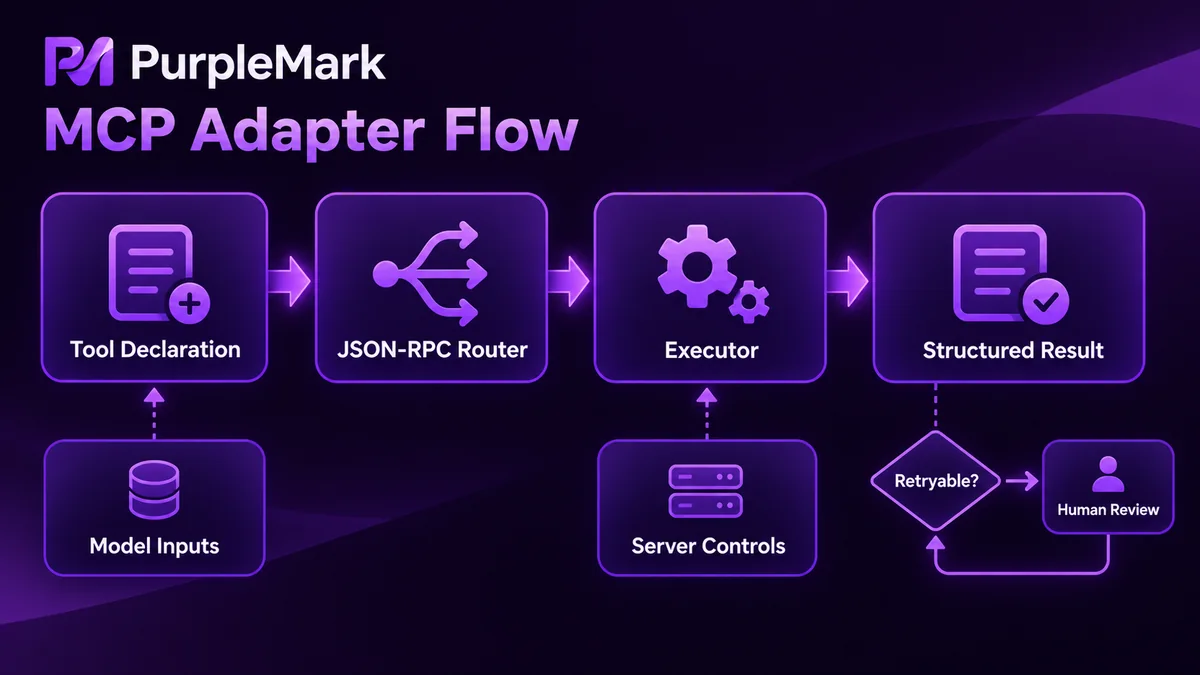
Почнімо з оголошення інструментів: воно визначає, що може бачити Agent.
# adapter/tools.py
TOOLS = [
    {
        "name": "prepare_environment",
        "description": "Підготувати доступне середовище для регіону та після завершення повернути ID середовища",
        "inputSchema": {
            "type": "object",
            "properties": {
                "region": {"type": "string", "description": "Регіон мережевого виходу, наприклад US-CA"},
                "purpose": {"type": "string", "description": "Мітка призначення для повторного використання та статистики квот"},
                "timeout": {"type": "integer", "minimum": 10, "maximum": 120, "default": 60},
            },
            "required": ["region"],
            "additionalProperties": False,
        },
    },
    {
        "name": "open_page",
        "description": "Відкрити сторінку у вказаному середовищі й дочекатися, доки вона стане інтерактивною",
        "inputSchema": {
            "type": "object",
            "properties": {
                "env_id": {"type": "string"},
                "url": {"type": "string"},
            },
            "required": ["env_id", "url"],
            "additionalProperties": False,
        },
    },
]
Маршрутизатор розподіляє методи JSON-RPC. Клієнт спершу запитує tools/list, а потім викликає tools/call за назвою.
# adapter/app.py
from flask import Flask, request, jsonify
from adapter.tools import TOOLS
from adapter.runner import run_tool

app = Flask(__name__)

@app.post("/mcp")
def mcp():
    req = request.get_json(force=True)
    method, rid = req.get("method"), req.get("id")

    if method == "tools/list":
        return jsonify({"jsonrpc": "2.0", "id": rid, "result": {"tools": TOOLS}})

    if method == "tools/call":
        name = req["params"]["name"]
        args = req["params"].get("arguments", {})
        return jsonify({"jsonrpc": "2.0", "id": rid, "result": run_tool(name, args)})

    return jsonify({"jsonrpc": "2.0", "id": rid,
                    "error": {"code": -32601, "message": "method not found"}})
Шар виконання — єдине місце, яке звертається до API середовища та протоколу сторінки. Тут виконується багатокрокова послідовність і тут помилки перетворюються на єдиний формат.
# adapter/runner.py
def run_tool(name, args):
    try:
        payload = HANDLERS[name](**args)
        return ok(payload)
    except ToolError as e:
        return fail(e.code, e.retryable, e.message)
Формат відповіді варто визначити заздалегідь. Не передавайте Agent сирі низькорівневі винятки: він намагатиметься аналізувати ці рядки й може ухвалювати дивні рішення. Краще погодити структуру з кодом результату, наприклад {"ok": false, "code": "env_unavailable", "retryable": true, "attempts": 3}. Тоді Agent має відповісти лише на два питання: чи можна повторити спробу і чи треба передати випадок людині.
Як проєктувати параметри
Розмір інструментів слід визначати за бізнес-діями, а не за API. Якщо обгорнути кожен низькорівневий endpoint в окремий інструмент, абстракції фактично немає — Agent усе одно мусить сам упорядковувати кроки.
У параметрах є чітка межа: що має визначати модель, а що — сам адаптер. Регіон, призначення та цільовий URL належать до першої групи, їх заповнює модель. Порт налагодження, назви внутрішніх черг і вибір пулу середовищ належать до другої; не додавайте їх у schema, інакше рано чи пізно модель заповнить їх неправильно.
Селектори — типова пастка. Коли структура сторінки змінюється, виклики з жорстко заданими селекторами можуть масово перестати працювати. Краще дозволити моделі передавати семантичні цілі, наприклад відносно стабільну ознаку на кшталт «кнопка входу», а відповідність селекторів підтримувати в адаптері. Тоді при зміні сторінки достатньо виправити одне місце.
Числові параметри обов’язково повинні мати верхні межі. Якщо timeout, кількість повторів або число сторінок не мають maximum у schema, модель може передати дуже велике значення й перетворити один виклик на задачу тривалістю понад десять хвилин. Кожен інструмент із циклічною логікою потребує явної точки завершення. Обмежуйте роботу полем на кшталт max_pages, а не правилом «гортати, доки дані не закінчаться».
Також треба врахувати ідемпотентність. Нехай сторона, що викликає, передає task_id; повторний запит може одразу повернути попередній результат, щоб retry Agent не створив середовище вдруге.
Повернуті значення мають бути компактними. Не повертайте знімки екрана як base64 — віддавайте посилання на файл. Для списків додавайте count і позначку обрізання замість того, щоб вкладати всю таблицю в контекст.
Під час налагодження спершу перевірте ці три місця
При роботі через stdio JSON-RPC використовує stdout, тому логи категорично не можна писати в stdout. Один випадковий print може одразу зламати розбір протоколу й змусити довго шукати проблему. Логи слід послідовно спрямовувати в stderr або файл.
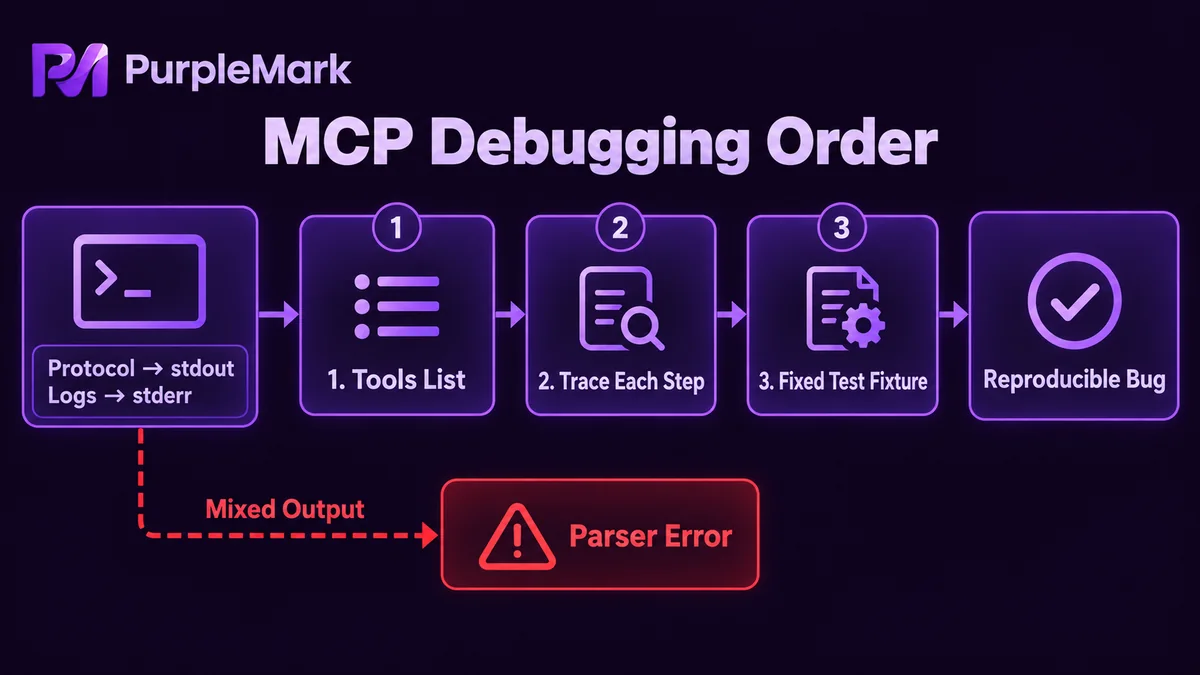
tools/list — перша контрольна точка. Якщо оголошення не завантажено, жодних подальших викликів не буде. Спершу перевірте назви інструментів, структуру schema та чи не блокує additionalProperties якісь параметри.
Друга контрольна точка — покроковий trace. Для кожного виклику записуйте task_id, короткий опис параметрів, тривалість і код результату. Якщо виникне проблема, буде видно, де саме все зупинилося: під час створення середовища, навігації чи перевірки. Зберігайте початкові параметри невдалих випадків, щоб відтворювати їх без змін — відтворювана помилка виправляється значно швидше.
Третя контрольна точка — набір фіксованих fixtures: стабільна тестова сторінка й кілька незмінних локаторів елементів. Запуск smoke test після кожної зміни адаптера економить більше часу, ніж будь-яка усна перевірка.
Межі дозволів
Шар адаптера — місце з найбільшою концентрацією повноважень у всій системі: у нього є доступ до облікових даних, середовищ і операцій зі сторінкою. Тому межі потрібно встановлювати саме тут.
Зберігайте облікові дані в конфігурації сервера, а не в параметрах інструментів і не в контексті моделі. Розділяйте інструменти за ризиком: інструменти лише для читання, як-от знімки екрана та отримання тексту, увімкнені за замовчуванням; інструменти запису, як-от натискання, надсилання та видалення, за замовчуванням вимкнені й тимчасово вмикаються для конкретної задачі. Навіть якщо модель помилиться, масштаб наслідків буде обмеженим.
Ізолюйте середовища за призначенням. Різні облікові записи та різні задачі мають використовувати різні середовища; не змішуйте їх в одному. У сценаріях із кількома обліковими записами створення середовища, прив’язку мережевого виходу й підтримку стану можна передати окремому шару керування середовищами. Інструменти на кшталт PurpleMark саме відокремлюють цей шар, а адаптер відповідає лише за бізнес-композицію та перевірки.
Зберігайте журнали аудиту. Має бути можливість експортувати за часом, яка задача використовувала яке середовище та які інструменти запису викликала. Якщо справді виникне проблема, цей запис — єдиний спосіб відновити хід подій.
І нарешті, жорстка межа: шар адаптера не повинен надавати жодного способу обходити правила платформи. Масову реєстрацію, обхід перевірок або підробку особи не можна пакувати в інструменти навіть під назвою внутрішніх. Щойно інструмент стає доступним моделі, виклики можуть відбуватися автоматично; до цього немає надійної точки блокування, а після — наслідки вже не скасувати.
Версії протоколу та визначення полів слід звіряти з офіційною документацією MCP.


