
既製のMCP Serverは多くの場合プリミティブしか提供せず、Agentは業務アクションを毎回組み直し、途中の失敗も自分で判断する必要があります。薄いFlaskアダプター層を置けば、ツール宣言、ルーティング、実行結果、検証、エラーの意味付けを一か所にまとめられます。
ブラウザー環境をAI Agentにつなぐとき、避けて通れないことがあります。標準ツールが提供するのはプリミティブであり、業務アクションは自分で組み立てなければなりません。
具体例を見てみます。1回の収集処理を通すには、実際には「地域ごとに環境を起動し、出口を紐付け、ウォームアップのために一度アクセスし、出口が利用できることを確認する」という流れを実行してから、ようやくAgentに作業を渡します。既製のMCP Serverが提供するのは通常、環境起動、ナビゲーション、クリック、スクリーンショットといった単一ステップのツールだけです。上記の組み合わせロジックまで代わりに作ってはくれません。Agentは毎回ゼロから順序を組み立てる必要があり、遅いうえに、途中のどこかで失敗すれば自分で対処を判断しなければなりません。
アダプター層はそのためにあります。組み合わせロジック、検証、状態を自分の側に持ち、外部には1つの業務アクションだけを公開します。
最小構成
動くアダプター層に必要なのは3つだけです。ツール宣言、リクエストルーティング、そして実行と返却です。Flaskなら1つのプロセスに収められます。
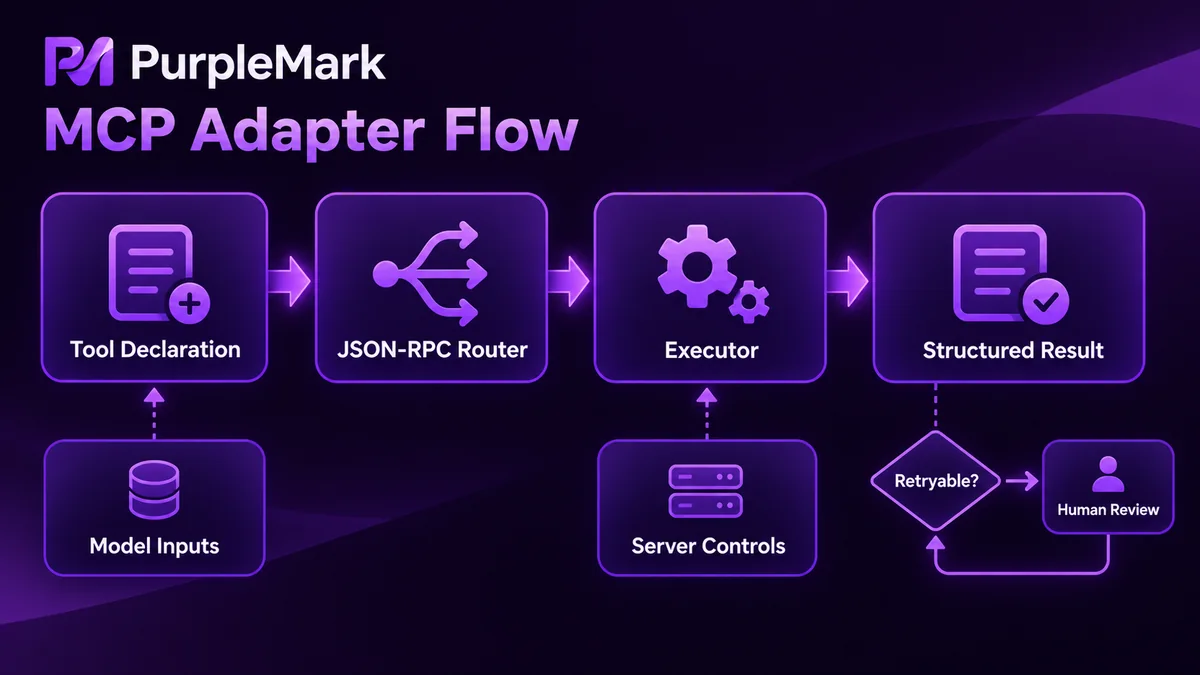
まずツール宣言を見ます。ここでAgentから何が見えるかが決まります。
# adapter/tools.py
TOOLS = [
    {
        "name": "prepare_environment",
        "description": "地域に応じて利用可能な環境を準備し、完了後に環境IDを返す",
        "inputSchema": {
            "type": "object",
            "properties": {
                "region": {"type": "string", "description": "出口地域。例: US-CA"},
                "purpose": {"type": "string", "description": "再利用とクォータ統計に使う用途ラベル"},
                "timeout": {"type": "integer", "minimum": 10, "maximum": 120, "default": 60},
            },
            "required": ["region"],
            "additionalProperties": False,
        },
    },
    {
        "name": "open_page",
        "description": "指定した環境でページを開き、操作可能になるまで待つ",
        "inputSchema": {
            "type": "object",
            "properties": {
                "env_id": {"type": "string"},
                "url": {"type": "string"},
            },
            "required": ["env_id", "url"],
            "additionalProperties": False,
        },
    },
]
ルーターはJSON-RPCのメソッドを振り分けます。クライアントは最初にtools/listを問い合わせ、その後、名前を指定してtools/callを呼び出します。
# adapter/app.py
from flask import Flask, request, jsonify
from adapter.tools import TOOLS
from adapter.runner import run_tool

app = Flask(__name__)

@app.post("/mcp")
def mcp():
    req = request.get_json(force=True)
    method, rid = req.get("method"), req.get("id")

    if method == "tools/list":
        return jsonify({"jsonrpc": "2.0", "id": rid, "result": {"tools": TOOLS}})

    if method == "tools/call":
        name = req["params"]["name"]
        args = req["params"].get("arguments", {})
        return jsonify({"jsonrpc": "2.0", "id": rid, "result": run_tool(name, args)})

    return jsonify({"jsonrpc": "2.0", "id": rid,
                    "error": {"code": -32601, "message": "method not found"}})
実行層は、環境APIとページプロトコルに触れる唯一の場所です。複数ステップの連携はここで完了させ、失敗もここで統一形式に変換します。
# adapter/runner.py
def run_tool(name, args):
    try:
        payload = HANDLERS[name](**args)
        return ok(payload)
    except ToolError as e:
        return fail(e.code, e.retryable, e.message)
返却形式は早めに決めておく価値があります。低レイヤーの例外をそのままAgentに渡してはいけません。Agentは文字列を解析しようとして、妙な判断をする可能性があります。たとえば {"ok": false, "code": "env_unavailable", "retryable": true, "attempts": 3} のように結果コード付きの構造を決めます。そうすればAgentが判断するのは2点だけです。再試行できるか、人に引き継ぐべきかです。
パラメーターをどう設計するか
ツールの粒度はAPI単位ではなく、業務アクション単位で切ります。低レイヤーの各endpointを1つずつツール化しても、実質的には抽象化になっておらず、Agentが自分で順序を決める必要が残ります。
パラメーターには明確な境界があります。モデルが決めるべきものと、アダプター層自身が決めるべきものです。地域、用途、対象URLは前者なのでモデルに入力させます。デバッグポート、内部キュー名、どの環境プールから取るかは後者なのでschemaには出しません。出せば、いずれモデルが誤って入力します。
セレクターは問題になりやすい箇所です。ページ構造が変わると、セレクターを固定した呼び出しがまとめて壊れることがあります。モデルには「ログインボタン」のような比較的安定した意味上の対象を渡させ、セレクターのマッピングはアダプター層で管理します。そうすれば変更箇所は1か所で済みます。
数値パラメーターには必ず上限を設けます。timeout、再試行回数、ページ数にschema上のmaximumがないと、モデルが非常に大きな値を渡し、1回の呼び出しが十数分かかる処理になることがあります。ループを伴うツールには明確な終了条件が必要です。「データがなくなるまでページ送りする」ではなく、max_pages のようなフィールドで上限を決めます。
冪等性も考慮します。呼び出し元に task_id を渡してもらえば、重複リクエストには前回の結果をそのまま返せます。Agentのretryで環境が二重に起動されるのを防げます。
返却値はできるだけ小さくします。スクリーンショットをbase64で返さず、ファイル参照を返します。リスト結果にはcountと切り捨てフラグを含め、表全体をcontextに詰め込まないようにします。
デバッグ時にまず見る3か所
stdioを使う場合、JSON-RPCがstdoutを使うため、ログは絶対にstdoutへ出してはいけません。何気ないprint 1行でプロトコル解析がその場で壊れ、長時間の調査につながることがあります。ログはstderrかファイルに統一して出します。
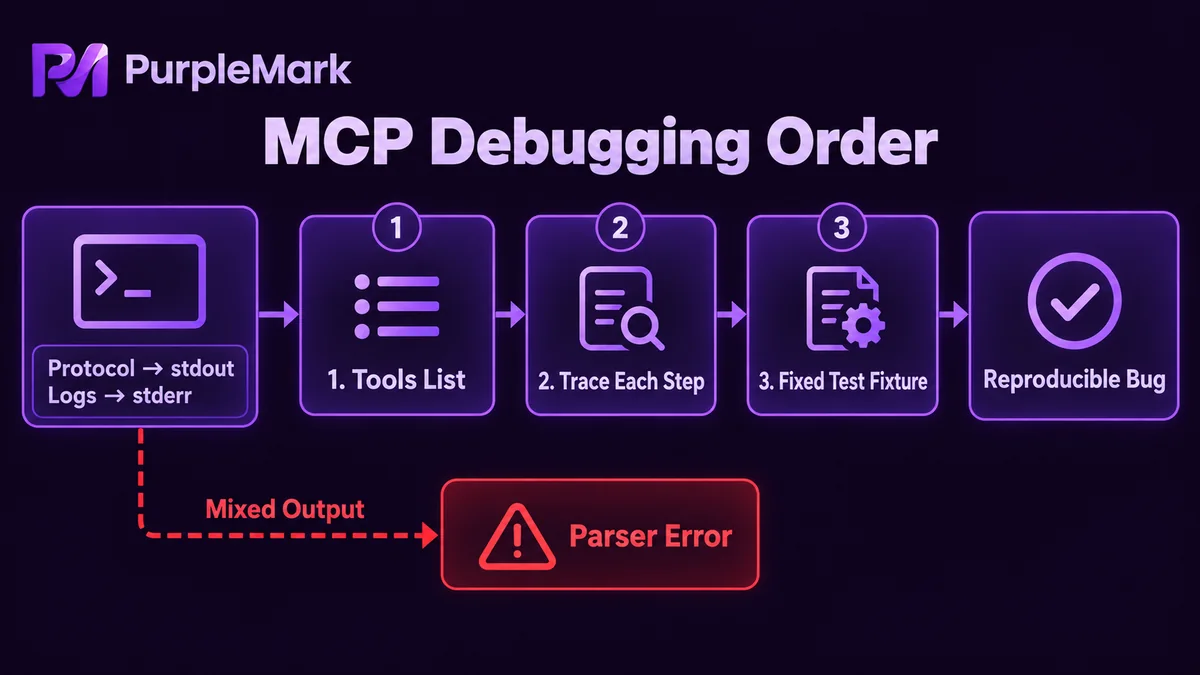
tools/listが最初のチェックポイントです。宣言が読み込まれていなければ、その後の呼び出しは一切起きません。まずツール名の綴り、schema構造、additionalProperties がパラメーターを弾いていないかを確認します。
2つ目のチェックポイントは段階的なtraceです。各呼び出しについてtask_id、パラメーター要約、所要時間、結果コードを記録します。問題が起きたとき、環境起動、ナビゲーション、検証のどこで止まったかが分かります。失敗例の元パラメーターを保存し、そのまま再現できるようにします。再現できるbugは修正が速いからです。
3つ目は固定fixturesのセットです。内容が安定したテストページと、変わらない要素ロケーターをいくつか用意します。アダプター層を変更するたびにsmoke testを走らせる方が、口頭確認よりずっと効率的です。
権限の境界
アダプター層はシステム全体で権限が最も集中する場所です。認証情報、環境、ページ操作のすべてを握るため、境界はここで引く必要があります。
認証情報はサーバー側設定に置き、ツールパラメーターにもモデルcontextにも入れません。ツールは危険度で分けます。スクリーンショットやテキスト取得などの読み取り専用ツールはデフォルトで有効にし、クリック、送信、削除などの書き込みツールはデフォルトで無効にして、タスクごとに一時的に有効化します。これならモデルが判断を誤っても、被害には上限があります。
環境は用途ごとに分離します。異なるアカウントや異なるタスクは別の環境を使い、1つの環境を混用しません。複数アカウント管理では、環境作成、ネットワーク出口の紐付け、状態維持を専用の環境レイヤーに任せられます。PurpleMarkのようなツールはこの層を切り分け、アダプター層は業務ロジックの組み合わせと検証だけを担当します。
監査ログは残しておきます。どのタスクが、いつ、どの環境を使い、どの書き込みツールを呼び出したかを時系列で出力できるようにします。実際に問題が起きたとき、過程を復元できるのはこの記録だけです。
最後に越えてはいけない線があります。アダプター層は、プラットフォームのルールを回避する入口を提供してはいけません。大量登録、認証回避、身元偽装のような操作をツール化したり、内部ツールという名目でぶら下げたりしないでください。一度ツールをモデルに公開すると、呼び出しは自動で発生し得ます。事前に確実に止められる場所はなく、事後に元へ戻すこともできません。
プロトコルのバージョンとフィールド定義は、MCP公式ドキュメントを参照してください。


