
MCP Server สำเร็จรูปมักเปิดให้ใช้เพียงคำสั่งพื้นฐาน ทำให้ Agent ต้องประกอบขั้นตอนธุรกิจใหม่ทุกครั้งและตัดสินใจเองเมื่อขั้นตอนกลางล้มเหลว ชั้น adapter บาง ๆ ด้วย Flask ช่วยรวมการประกาศเครื่องมือ การ routing การทำงาน การตรวจสอบ และความหมายของข้อผิดพลาดไว้ที่เดียว
เมื่อเชื่อมสภาพแวดล้อมเบราว์เซอร์เข้ากับ AI Agent มีเรื่องหนึ่งที่หลีกเลี่ยงไม่ได้: เครื่องมือมาตรฐานให้เพียงคำสั่งพื้นฐาน แต่ขั้นตอนธุรกิจจริงยังต้องประกอบเอง
ยกตัวอย่างที่ชัดเจน หากต้องการให้การเก็บข้อมูลหนึ่งรอบทำงานครบ ลำดับจริงคือ “เปิด environment ตามภูมิภาค ผูกเส้นทางออก เข้าใช้งานครั้งหนึ่งเพื่อ warm-up และยืนยันว่าเส้นทางออกใช้งานได้” แล้วจึงส่งต่อให้ Agent ทำงาน MCP Server สำเร็จรูปโดยทั่วไปให้เพียงเครื่องมือทีละขั้น เช่น เปิด environment, นำทาง, คลิก และจับภาพหน้าจอ ไม่มีใครประกอบตรรกะชุดนี้ให้โดยอัตโนมัติ Agent จึงต้องเรียงขั้นตอนใหม่จากศูนย์ทุกครั้ง ซึ่งช้า และหากขั้นตอนกลางใดล้มเหลวก็ต้องตัดสินใจเองว่าจะทำอย่างไรต่อ
ชั้น adapter มีไว้ทำงานนี้: เก็บตรรกะการประกอบ การตรวจสอบ และสถานะไว้ฝั่งของคุณ แล้วเปิดออกไปเพียง business action เดียว
โครงสร้างขั้นต่ำที่ใช้งานได้
ชั้น adapter ที่ใช้งานได้ต้องมีเพียงสามส่วน: การประกาศเครื่องมือ การ routing คำขอ และการทำงานพร้อมผลลัพธ์ เมื่อใช้ Flask ทุกอย่างอยู่ใน process เดียวได้
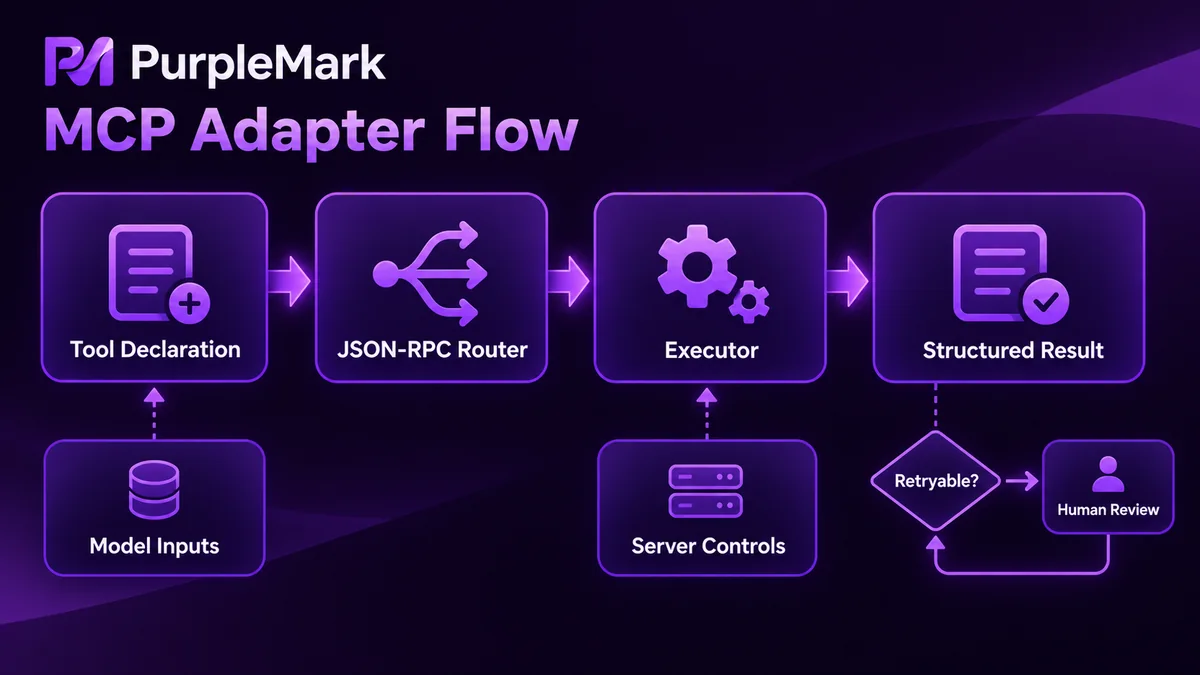
เริ่มจากการประกาศเครื่องมือ เพราะส่วนนี้กำหนดว่า Agent มองเห็นอะไรได้บ้าง
# adapter/tools.py
TOOLS = [
    {
        "name": "prepare_environment",
        "description": "เตรียม environment ที่ใช้งานได้สำหรับภูมิภาค และคืน environment ID เมื่อเสร็จ",
        "inputSchema": {
            "type": "object",
            "properties": {
                "region": {"type": "string", "description": "ภูมิภาคของเส้นทางออก เช่น US-CA"},
                "purpose": {"type": "string", "description": "ป้ายจุดประสงค์สำหรับการใช้ซ้ำและสถิติโควตา"},
                "timeout": {"type": "integer", "minimum": 10, "maximum": 120, "default": 60},
            },
            "required": ["region"],
            "additionalProperties": False,
        },
    },
    {
        "name": "open_page",
        "description": "เปิดหน้าใน environment ที่ระบุและรอจนกว่าจะโต้ตอบได้",
        "inputSchema": {
            "type": "object",
            "properties": {
                "env_id": {"type": "string"},
                "url": {"type": "string"},
            },
            "required": ["env_id", "url"],
            "additionalProperties": False,
        },
    },
]
Router ทำหน้าที่กระจาย method ของ JSON-RPC โดย client จะถาม tools/list ก่อน แล้วจึงเรียก tools/call ตามชื่อ
# adapter/app.py
from flask import Flask, request, jsonify
from adapter.tools import TOOLS
from adapter.runner import run_tool

app = Flask(__name__)

@app.post("/mcp")
def mcp():
    req = request.get_json(force=True)
    method, rid = req.get("method"), req.get("id")

    if method == "tools/list":
        return jsonify({"jsonrpc": "2.0", "id": rid, "result": {"tools": TOOLS}})

    if method == "tools/call":
        name = req["params"]["name"]
        args = req["params"].get("arguments", {})
        return jsonify({"jsonrpc": "2.0", "id": rid, "result": run_tool(name, args)})

    return jsonify({"jsonrpc": "2.0", "id": rid,
                    "error": {"code": -32601, "message": "method not found"}})
ชั้น execution เป็นจุดเดียวที่ติดต่อ environment API และ page protocol ลำดับหลายขั้นจะทำให้เสร็จที่นี่ และความล้มเหลวก็ถูกแปลงเป็นรูปแบบเดียวกันที่นี่
# adapter/runner.py
def run_tool(name, args):
    try:
        payload = HANDLERS[name](**args)
        return ok(payload)
    except ToolError as e:
        return fail(e.code, e.retryable, e.message)
ควรกำหนดรูปแบบผลลัพธ์ตั้งแต่ต้น อย่าส่ง exception ระดับล่างแบบดิบให้ Agent เพราะมันจะพยายามตีความ string เหล่านั้นและอาจตัดสินใจแปลก ๆ ควรกำหนดโครงสร้างที่มี result code เช่น {"ok": false, "code": "env_unavailable", "retryable": true, "attempts": 3} จากนั้น Agent ต้องตัดสินใจเพียงสองเรื่อง: ลองใหม่ได้หรือไม่ และควรส่งต่อให้คนจัดการหรือไม่
ออกแบบพารามิเตอร์อย่างไร
กำหนดขนาดของเครื่องมือตาม business action ไม่ใช่ตาม API การห่อ endpoint ระดับล่างทุกตัวเป็นเครื่องมือแยกเท่ากับแทบไม่ได้ทำ abstraction เพราะ Agent ยังต้องเรียงขั้นตอนเอง
พารามิเตอร์ควรมีเส้นแบ่งชัดเจนระหว่างสิ่งที่ model ควรตัดสินใจ กับสิ่งที่ชั้น adapter ควรตัดสินใจเอง ภูมิภาค จุดประสงค์ และ URL เป้าหมายอยู่ในกลุ่มแรก ให้ model กรอก ส่วน debug port, ชื่อ queue ภายใน และการเลือก environment pool อยู่ในกลุ่มหลัง ไม่ควรใส่ใน schema เพราะไม่ช้าก็เร็ว model อาจกรอกผิด
Selector เป็นจุดที่พลาดได้ง่าย เมื่อโครงสร้างหน้าเปลี่ยน การเรียกที่ hard-code selector ไว้อาจพังพร้อมกันหลายจุด ควรให้ model ส่งเป้าหมายเชิงความหมาย เช่น “ปุ่มเข้าสู่ระบบ” ที่ค่อนข้างคงที่ และเก็บ selector mapping ไว้ในชั้น adapter เมื่อหน้าเปลี่ยนก็แก้เพียงจุดเดียว
พารามิเตอร์ตัวเลขต้องมีขีดจำกัดบน หาก timeout, จำนวน retry หรือจำนวนหน้าไม่มี maximum ใน schema model อาจส่งค่าที่ใหญ่มากจน call เดียวกินเวลามากกว่าสิบนาที เครื่องมือที่มีลูปทุกตัวต้องมีจุดสิ้นสุดชัดเจน ใช้ field เช่น max_pages เพื่อจำกัดงาน แทนคำสั่งว่า “เลื่อนไปจนกว่าจะไม่มีข้อมูล”
ต้องคำนึงถึง idempotency ด้วย ให้ caller ส่ง task_id; เมื่อคำขอซ้ำสามารถคืนผลเดิมได้ทันที เพื่อไม่ให้ Agent เปิด environment ซ้ำตอน retry
พยายามให้ค่าที่คืนกลับมีขนาดเล็ก อย่าส่ง screenshot กลับเป็น base64 ให้คืน file reference แทน สำหรับผลลัพธ์แบบรายการให้มี count และสถานะตัดทอน แทนการยัดทั้งตารางเข้า context
เวลา Debug ให้ดูสามจุดนี้ก่อน
ถ้าใช้ stdio, JSON-RPC จะใช้ stdout ดังนั้นห้ามเขียน log ลง stdout เด็ดขาด แค่ print หนึ่งบรรทัดก็อาจทำให้ protocol parser พังทันทีและเสียเวลาหาสาเหตุนาน ควรส่ง log ไป stderr หรือไฟล์ให้เป็นมาตรฐาน
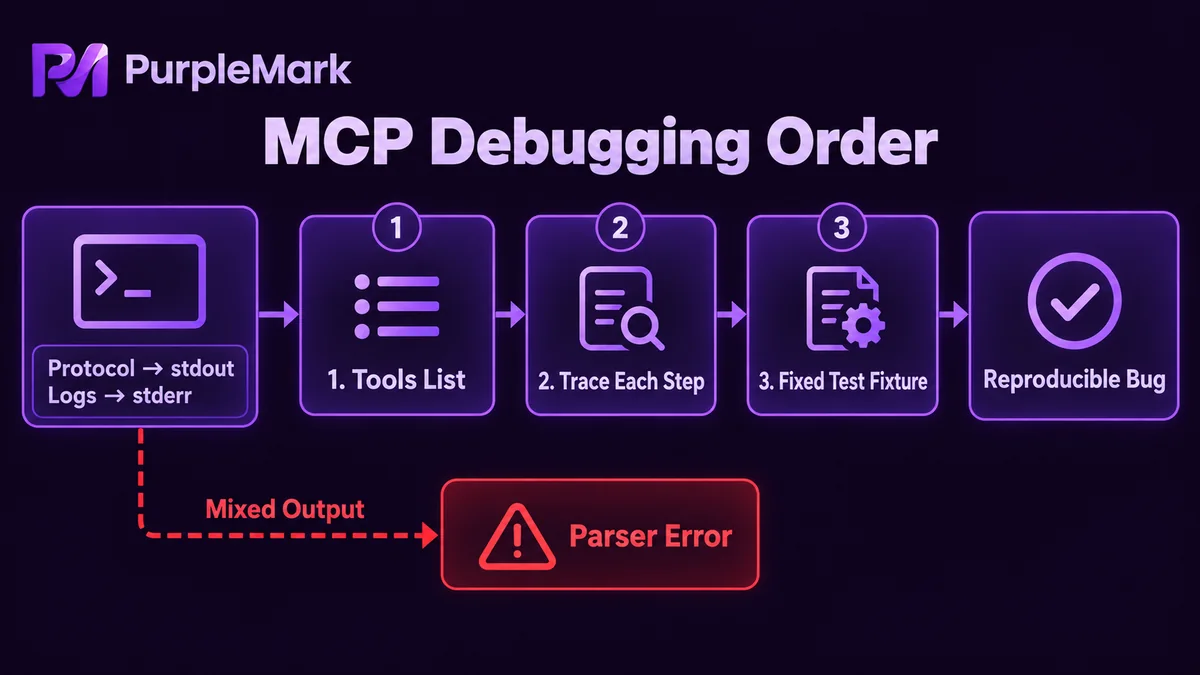
tools/list คือ checkpoint แรก ถ้า declaration ไม่ถูกโหลด การเรียกถัดไปทั้งหมดจะไม่เกิดขึ้น ให้ตรวจชื่อเครื่องมือ โครงสร้าง schema และดูว่า additionalProperties กำลังบล็อกพารามิเตอร์ใดหรือไม่
checkpoint ที่สองคือ trace แบบทีละขั้น บันทึก task_id, สรุปพารามิเตอร์, เวลาที่ใช้ และ result code สำหรับทุก call เมื่อมีปัญหาจะเห็นว่าไปติดที่การสร้าง environment, navigation หรือ validation เก็บพารามิเตอร์ต้นฉบับของกรณีล้มเหลวไว้เพื่อ replay ได้เหมือนเดิม — bug ที่ reproduce ได้จะแก้เร็วกว่า
checkpoint ที่สามคือชุด fixtures คงที่: หน้า test ที่เนื้อหาเสถียร พร้อม element locator หลายตัวที่ไม่เปลี่ยน ทุกครั้งที่แก้ชั้น adapter ให้รัน smoke test หนึ่งรอบ มีประโยชน์กว่าการยืนยันด้วยคำพูด
ขอบเขตสิทธิ์
ชั้น adapter คือจุดที่สิทธิ์รวมตัวมากที่สุดในทั้งระบบ เพราะ credentials, environments และการทำงานบนหน้าล้วนอยู่ในมือของมัน จึงต้องกำหนดขอบเขตที่นี่
เก็บ credentials ไว้ในการตั้งค่าฝั่ง server ไม่ใส่ใน tool parameters หรือ model context แบ่งเครื่องมือตามระดับความเสี่ยง: เครื่องมือ read-only เช่น screenshot และดึงข้อความ เปิดไว้เป็นค่าเริ่มต้น; เครื่องมือเขียน เช่น click, submit และ delete ปิดไว้เป็นค่าเริ่มต้นและเปิดชั่วคราวตามงาน วิธีนี้ช่วยจำกัดความเสียหายแม้ model ตัดสินใจผิด
แยก environments ตามจุดประสงค์ บัญชีต่างกันและงานต่างกันควรใช้ environment ต่างกัน ไม่ใช้ environment เดียวปะปนกัน ในกรณีจัดการหลายบัญชี การสร้าง environment, การผูก network outbound และการดูแลสถานะสามารถให้ชั้น environment โดยเฉพาะรับผิดชอบ เครื่องมืออย่าง PurpleMark แยกชั้นนี้ออก ส่วน adapter layer รับผิดชอบเฉพาะการประกอบ business logic และ validation
ต้องเก็บ audit logs ให้สามารถ export ตามเวลาได้ว่า task ใดใช้ environment ใด และเรียก write tools อะไรบ้าง เมื่อเกิดปัญหาจริง บันทึกนี้คือวิธีเดียวที่ช่วยย้อนกระบวนการได้
สุดท้ายคือเส้นที่ห้ามข้าม: ชั้น adapter ไม่ควรมีทางใด ๆ สำหรับเลี่ยงกฎของแพลตฟอร์ม การสมัครจำนวนมาก การเลี่ยง verification หรือการปลอม identity ไม่ควรถูกห่อเป็นเครื่องมือ และไม่ควรซ่อนไว้ในชื่อ internal tool เมื่อเครื่องมือถูกเปิดให้ model แล้ว การเรียกอาจเกิดอัตโนมัติ ไม่มีจุดที่เชื่อถือได้สำหรับสกัดกั้นล่วงหน้า และแก้ผลที่เกิดขึ้นภายหลังไม่ได้
เวอร์ชันของโปรโตคอลและคำจำกัดความของฟิลด์ให้ยึดตามเอกสาร MCP อย่างเป็นทางการ


