
Gotowe MCP Server zwykle udostępniają tylko podstawowe operacje, więc Agent za każdym razem musi składać działania biznesowe i oceniać błędy. Cienka warstwa adaptera w Flask centralizuje deklaracje narzędzi, routing, wykonanie, walidację i semantykę błędów.
Przy podłączaniu środowiska przeglądarki do AI Agent nie da się ominąć jednej kwestii: standardowe narzędzia dostarczają operacje podstawowe, a działania biznesowe trzeba samodzielnie złożyć.
Weźmy konkretny przykład. Aby wykonać pełny przebieg zbierania danych, rzeczywisty ciąg działań brzmi: „uruchom środowisko dla danego regionu, przypisz wyjście sieciowe, odwiedź stronę raz w celu rozgrzania i potwierdź, że wyjście działa”, a dopiero potem przekaż pracę Agentowi. Gotowy MCP Server zwykle oferuje tylko narzędzia jednoetapowe: uruchomienie środowiska, nawigację, kliknięcie czy zrzut ekranu. Nikt nie składa za Ciebie tej sekwencji. Agent musi układać ją od zera przy każdym uruchomieniu, co jest wolne, a gdy którykolwiek etap pośredni zawiedzie, sam musi zdecydować, co robić dalej.
Właśnie do tego służy warstwa adaptera: logika łączenia kroków, walidacja i stan pozostają po Twojej stronie, a na zewnątrz udostępniasz tylko jedną akcję biznesową.
Minimalna działająca struktura
Działająca warstwa adaptera potrzebuje tylko trzech elementów: deklaracji narzędzi, routingu żądań oraz wykonania z wynikiem. W Flask wszystko może działać w jednym procesie.
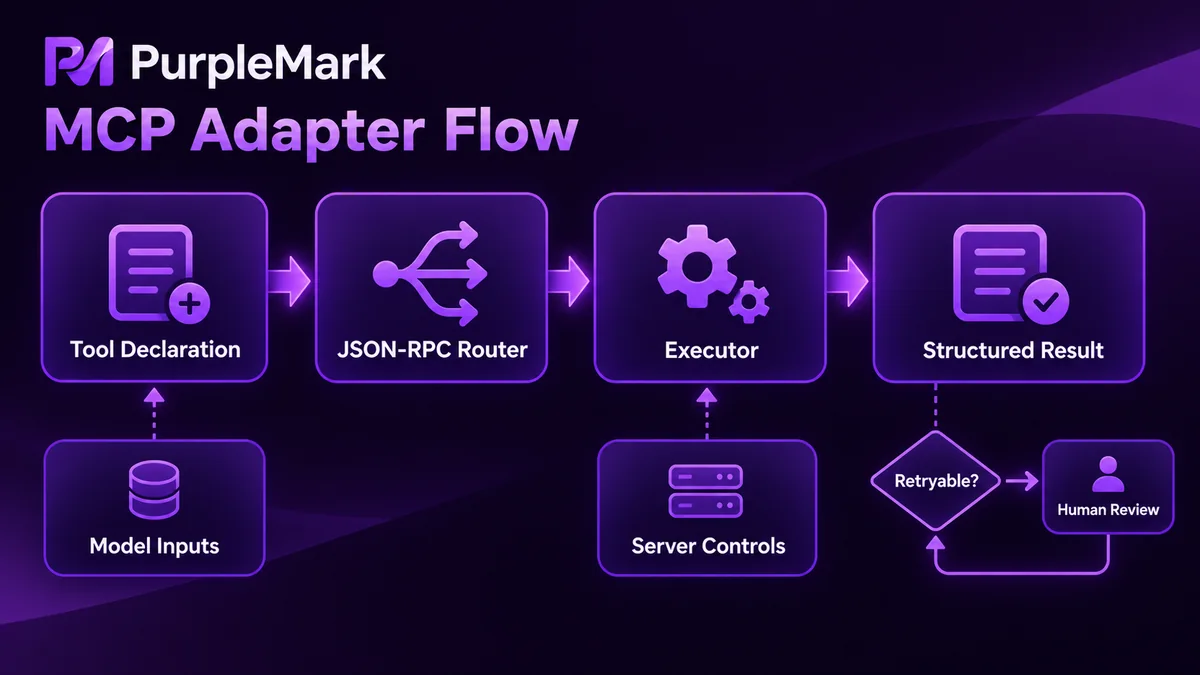
Najpierw deklaracje narzędzi — to one określają, co Agent może zobaczyć.
# adapter/tools.py
TOOLS = [
    {
        "name": "prepare_environment",
        "description": "Przygotuj dostępne środowisko dla regionu i zwróć identyfikator środowiska po zakończeniu",
        "inputSchema": {
            "type": "object",
            "properties": {
                "region": {"type": "string", "description": "Region wyjściowy, np. US-CA"},
                "purpose": {"type": "string", "description": "Etykieta przeznaczenia do ponownego użycia i statystyk limitów"},
                "timeout": {"type": "integer", "minimum": 10, "maximum": 120, "default": 60},
            },
            "required": ["region"],
            "additionalProperties": False,
        },
    },
    {
        "name": "open_page",
        "description": "Otwórz stronę w podanym środowisku i poczekaj, aż będzie interaktywna",
        "inputSchema": {
            "type": "object",
            "properties": {
                "env_id": {"type": "string"},
                "url": {"type": "string"},
            },
            "required": ["env_id", "url"],
            "additionalProperties": False,
        },
    },
]
Router rozdziela metody JSON-RPC. Klient najpierw pyta o tools/list, a potem wywołuje tools/call według nazwy.
# adapter/app.py
from flask import Flask, request, jsonify
from adapter.tools import TOOLS
from adapter.runner import run_tool

app = Flask(__name__)

@app.post("/mcp")
def mcp():
    req = request.get_json(force=True)
    method, rid = req.get("method"), req.get("id")

    if method == "tools/list":
        return jsonify({"jsonrpc": "2.0", "id": rid, "result": {"tools": TOOLS}})

    if method == "tools/call":
        name = req["params"]["name"]
        args = req["params"].get("arguments", {})
        return jsonify({"jsonrpc": "2.0", "id": rid, "result": run_tool(name, args)})

    return jsonify({"jsonrpc": "2.0", "id": rid,
                    "error": {"code": -32601, "message": "method not found"}})
Warstwa wykonawcza jest jedynym miejscem, które dotyka API środowiska i protokołu strony. Tutaj wykonywane są sekwencje wieloetapowe i tutaj błędy są zamieniane na jednolity format.
# adapter/runner.py
def run_tool(name, args):
    try:
        payload = HANDLERS[name](**args)
        return ok(payload)
    except ToolError as e:
        return fail(e.code, e.retryable, e.message)
Format odpowiedzi warto ustalić wcześnie. Nie przekazuj Agentowi surowych wyjątków z niskiego poziomu; będzie próbował analizować te ciągi i może podejmować dziwne decyzje. Ustal strukturę z kodem wyniku, na przykład {"ok": false, "code": "env_unavailable", "retryable": true, "attempts": 3}. Agent musi wtedy rozstrzygnąć tylko dwie rzeczy: czy można ponowić próbę i czy sprawę trzeba przekazać człowiekowi.
Jak projektować parametry
Ziarnistość narzędzi powinna odpowiadać działaniom biznesowym, a nie API. Opakowanie każdego niskopoziomowego endpointu jako osobnego narzędzia praktycznie nie daje abstrakcji — Agent nadal musi sam układać kolejność kroków.
W parametrach istnieje wyraźna granica: co powinien ustalać model, a co sama warstwa adaptera. Region, przeznaczenie i docelowy URL należą do pierwszej grupy i wypełnia je model. Port debugowania, nazwy wewnętrznych kolejek i wybór puli środowisk należą do drugiej; nie umieszczaj ich w schema, bo prędzej czy później model poda je błędnie.
Selektory łatwo stają się źródłem problemów. Gdy struktura strony się zmienia, wywołania z selektorami zapisanymi na sztywno mogą masowo przestać działać. Lepiej, by model przekazywał cele semantyczne, na przykład względnie stabilne oznaczenie typu „przycisk logowania”, a mapowanie selektorów było utrzymywane w warstwie adaptera. Wtedy przy zmianie strony wystarczy poprawić jedno miejsce.
Parametry liczbowe muszą mieć górne limity. Jeśli timeout, liczba ponowień lub liczba stron nie mają w schema wartości maximum, model może przekazać ogromną liczbę i zamienić jedno wywołanie w zadanie trwające ponad dziesięć minut. Każde narzędzie z logiką pętli potrzebuje jednoznacznego końca. Pole takie jak max_pages powinno ograniczać zakres zamiast polecenia „przewijaj strony, aż skończą się dane”.
Trzeba też uwzględnić idempotencję. Niech wywołujący przekazuje task_id; powtórzone żądanie może od razu zwrócić poprzedni wynik, dzięki czemu retry Agenta nie uruchomi środowiska drugi raz.
Wyniki powinny być małe. Nie zwracaj zrzutów ekranu jako base64 — zwracaj odwołanie do pliku. W wynikach list dodaj count i znacznik obcięcia zamiast wkładać całą tabelę do kontekstu.
Podczas debugowania najpierw sprawdź te trzy miejsca
Przy stdio JSON-RPC zajmuje stdout, więc logów absolutnie nie wolno pisać do stdout. Jeden przypadkowy print może natychmiast zepsuć analizę protokołu i kosztować wiele czasu na diagnozę. Logi kieruj konsekwentnie do stderr albo do pliku.
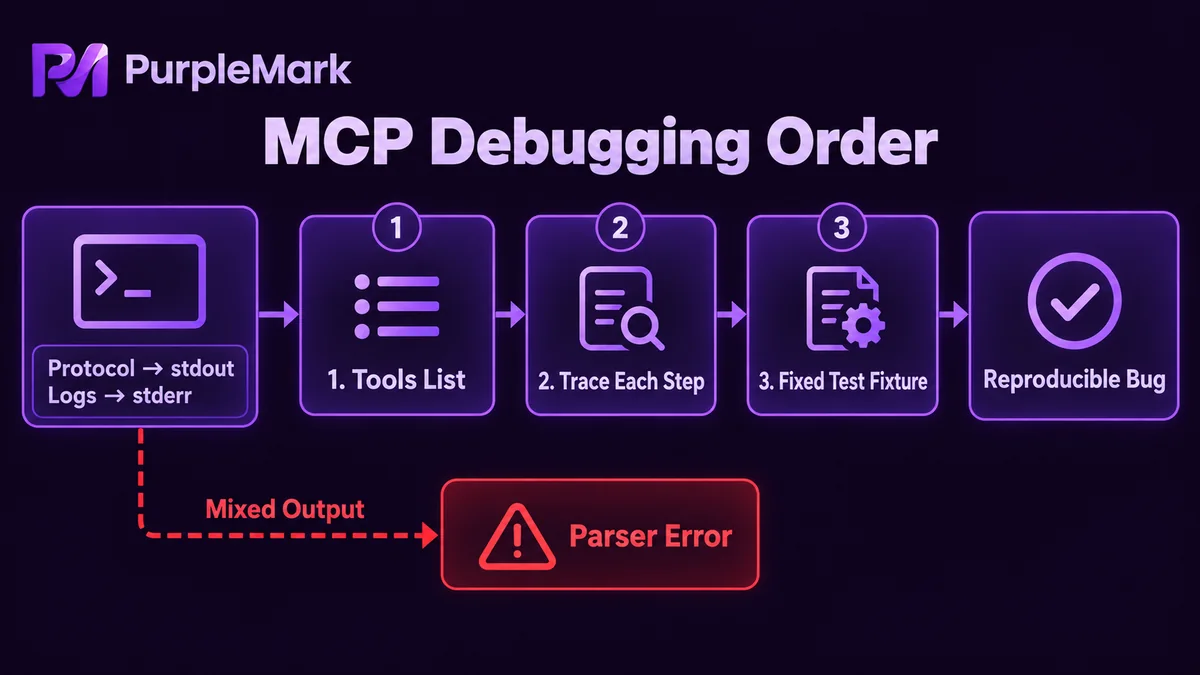
tools/list to pierwszy punkt kontrolny. Jeśli deklaracje nie zostały wczytane, żadne późniejsze wywołanie się nie wydarzy. Najpierw sprawdź nazwy narzędzi, strukturę schema i to, czy additionalProperties nie blokuje parametrów.
Drugi punkt kontrolny to trace krok po kroku. Dla każdego wywołania zapisuj task_id, skrót parametrów, czas wykonania i kod wyniku. Gdy pojawi się problem, od razu widać, czy zatrzymał się na tworzeniu środowiska, nawigacji czy walidacji. Zachowuj oryginalne parametry nieudanych przypadków, aby odtworzyć je identycznie — błąd, który da się reprodukować, naprawia się znacznie szybciej.
Trzeci punkt kontrolny to zestaw stałych fixtures: stabilna strona testowa i kilka niezmiennych lokalizatorów elementów. Uruchamianie smoke testu po każdej zmianie warstwy adaptera oszczędza więcej czasu niż jakakolwiek ustna weryfikacja.
Granice uprawnień
Warstwa adaptera jest miejscem, w którym skupia się najwięcej uprawnień w całym systemie: ma dostęp do poświadczeń, środowisk i operacji na stronie. Dlatego granice trzeba egzekwować właśnie tutaj.
Poświadczenia trzymaj w konfiguracji serwera, nie w parametrach narzędzi ani w kontekście modelu. Narzędzia rozdziel według ryzyka: narzędzia tylko do odczytu, takie jak zrzuty ekranu czy pobieranie tekstu, mogą być domyślnie włączone; narzędzia zapisujące, takie jak kliknięcie, wysłanie lub usunięcie, powinny być domyślnie wyłączone i włączane tymczasowo dla konkretnego zadania. Nawet jeśli model popełni błąd, zakres szkód pozostaje ograniczony.
Izoluj środowiska według przeznaczenia. Różne konta i różne zadania powinny korzystać z różnych środowisk; nie mieszaj ich w jednym. W scenariuszach wielokontowych tworzenie środowiska, przypisywanie wyjścia sieciowego i utrzymywanie stanu można powierzyć dedykowanej warstwie środowiskowej. Narzędzia takie jak PurpleMark właśnie oddzielają tę warstwę, a adapter zajmuje się wyłącznie kompozycją biznesową i walidacją.
Zachowuj logi audytowe. Powinna istnieć możliwość wyeksportowania według czasu informacji, które zadanie używało którego środowiska i jakie narzędzia zapisujące wywołało. Gdy naprawdę coś pójdzie nie tak, ten zapis jest jedynym sposobem odtworzenia przebiegu.
Na koniec twarda granica: warstwa adaptera nie powinna udostępniać żadnej drogi do obchodzenia zasad platformy. Działań takich jak masowa rejestracja, omijanie weryfikacji czy fałszowanie tożsamości nie należy pakować jako narzędzi ani ukrywać pod nazwą narzędzi wewnętrznych. Gdy narzędzie zostanie udostępnione modelowi, wywołania mogą następować automatycznie; wcześniej nie ma pewnego miejsca do ich zablokowania, a później nie da się cofnąć skutków.
Wersje protokołu i definicje pól należy sprawdzać w oficjalnej dokumentacji MCP.


