
MCP Servers prontos normalmente expõem apenas primitivas; o Agent precisa remontar as ações de negócio e decidir como reagir a falhas em cada execução. Uma camada fina em Flask centraliza ferramentas, roteamento, execução, validação e semântica de erros.
Ao conectar um ambiente de navegador a um AI Agent, há um ponto inevitável: as ferramentas padrão fornecem primitivas, mas as ações de negócio ainda precisam ser compostas por você.
Veja um exemplo concreto. Para concluir uma coleta, o fluxo real é “abrir um ambiente para uma região, vincular a saída, fazer um primeiro acesso para aquecimento e confirmar que a saída está funcionando”; só depois o Agent assume. Um MCP Server pronto geralmente oferece apenas ferramentas de uma etapa, como abrir o ambiente, navegar, clicar e capturar a tela. Ninguém monta para você a sequência acima. O Agent precisa organizá-la do zero toda vez, o que é lento, e ainda precisa decidir o que fazer se qualquer etapa intermediária falhar.
É para isso que serve a camada adaptadora: manter do seu lado a lógica de composição, a validação e o estado, expondo externamente apenas uma ação de negócio.
Estrutura mínima viável
Uma camada adaptadora funcional precisa de apenas três partes: declaração de ferramentas, roteamento de requisições e execução com retorno. Com Flask, um único processo comporta tudo.
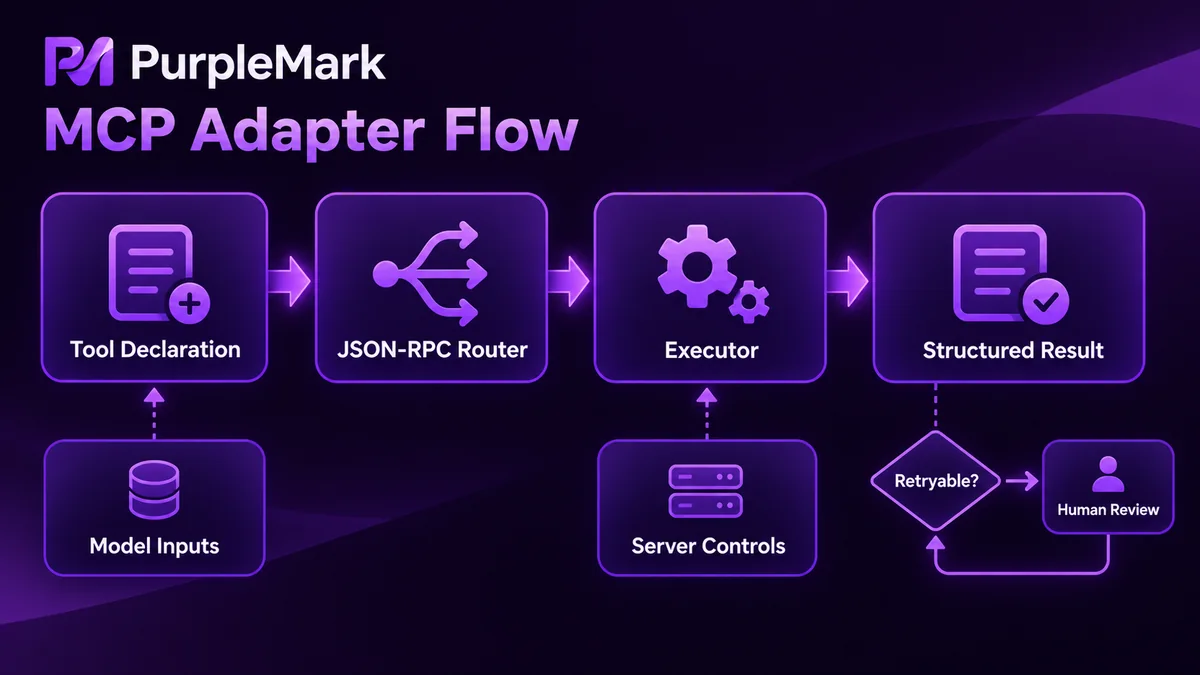
Comece pela declaração das ferramentas, pois ela define o que o Agent consegue enxergar.
# adapter/tools.py
TOOLS = [
    {
        "name": "prepare_environment",
        "description": "Preparar um ambiente disponível para uma região e retornar o ID do ambiente ao concluir",
        "inputSchema": {
            "type": "object",
            "properties": {
                "region": {"type": "string", "description": "Região de saída, como US-CA"},
                "purpose": {"type": "string", "description": "Rótulo de finalidade para reutilização e estatísticas de cota"},
                "timeout": {"type": "integer", "minimum": 10, "maximum": 120, "default": 60},
            },
            "required": ["region"],
            "additionalProperties": False,
        },
    },
    {
        "name": "open_page",
        "description": "Abrir uma página no ambiente especificado e aguardar até que esteja interativa",
        "inputSchema": {
            "type": "object",
            "properties": {
                "env_id": {"type": "string"},
                "url": {"type": "string"},
            },
            "required": ["env_id", "url"],
            "additionalProperties": False,
        },
    },
]
O roteador distribui os métodos JSON-RPC. O cliente consulta primeiro tools/list e depois chama tools/call pelo nome.
# adapter/app.py
from flask import Flask, request, jsonify
from adapter.tools import TOOLS
from adapter.runner import run_tool

app = Flask(__name__)

@app.post("/mcp")
def mcp():
    req = request.get_json(force=True)
    method, rid = req.get("method"), req.get("id")

    if method == "tools/list":
        return jsonify({"jsonrpc": "2.0", "id": rid, "result": {"tools": TOOLS}})

    if method == "tools/call":
        name = req["params"]["name"]
        args = req["params"].get("arguments", {})
        return jsonify({"jsonrpc": "2.0", "id": rid, "result": run_tool(name, args)})

    return jsonify({"jsonrpc": "2.0", "id": rid,
                    "error": {"code": -32601, "message": "method not found"}})
A camada de execução é o único lugar que toca a API do ambiente e o protocolo da página. O encadeamento de várias etapas acontece aqui, e as falhas também são convertidas aqui para um formato uniforme.
# adapter/runner.py
def run_tool(name, args):
    try:
        payload = HANDLERS[name](**args)
        return ok(payload)
    except ToolError as e:
        return fail(e.code, e.retryable, e.message)
Vale a pena definir cedo o formato de retorno. Não envie exceções brutas de baixo nível para o Agent; ele tentará interpretar essas strings e poderá tomar decisões estranhas. Defina uma estrutura com código de resultado, como {"ok": false, "code": "env_unavailable", "retryable": true, "attempts": 3}. Assim o Agent só precisa responder a duas perguntas: pode tentar novamente e deve passar o caso para uma pessoa?
Como projetar os parâmetros
A granularidade das ferramentas deve seguir as ações de negócio, não as APIs. Encapsular cada endpoint de baixo nível como uma ferramenta separada equivale a não abstrair nada; o Agent ainda terá de ordenar as etapas por conta própria.
Nos parâmetros existe uma divisão clara: o que o modelo deve decidir e o que a camada adaptadora deve decidir internamente. Região, finalidade e URL de destino pertencem ao primeiro grupo e ficam para o modelo preencher. Porta de depuração, nomes de filas internas e qual pool de ambientes usar pertencem ao segundo; não coloque isso no schema, porque cedo ou tarde o modelo preencherá de forma errada.
Seletores são uma armadilha comum. Quando a estrutura da página muda, chamadas com seletores codificados rigidamente podem quebrar em massa. É melhor permitir que o modelo envie alvos semânticos, como um identificador relativamente estável do tipo “botão de login”, e manter o mapeamento de seletores na camada adaptadora. Assim uma única alteração resolve a mudança.
Parâmetros numéricos precisam de limites superiores. Se timeout, número de tentativas ou quantidade de páginas não tiverem maximum no schema, o modelo pode enviar um valor enorme e transformar uma chamada em uma tarefa de mais de dez minutos. Toda ferramenta com lógica de loop precisa de um ponto de parada claro. Use um campo como max_pages para limitar o trabalho, em vez de “continuar até não haver mais dados”.
Também é preciso considerar idempotência. Faça o chamador enviar um task_id; requisições repetidas podem devolver diretamente o resultado anterior, evitando que um retry do Agent crie o ambiente duas vezes.
Mantenha os retornos pequenos. Não devolva capturas em base64; devolva uma referência de arquivo. Em resultados de listas, inclua count e um indicador de truncamento em vez de colocar a tabela inteira no contexto.
Três pontos para observar primeiro na depuração
Com stdio, o JSON-RPC ocupa stdout, portanto os logs nunca podem ir para stdout. Um print casual pode quebrar o parsing do protocolo imediatamente e gerar horas de investigação. Direcione os logs sempre para stderr ou para um arquivo.
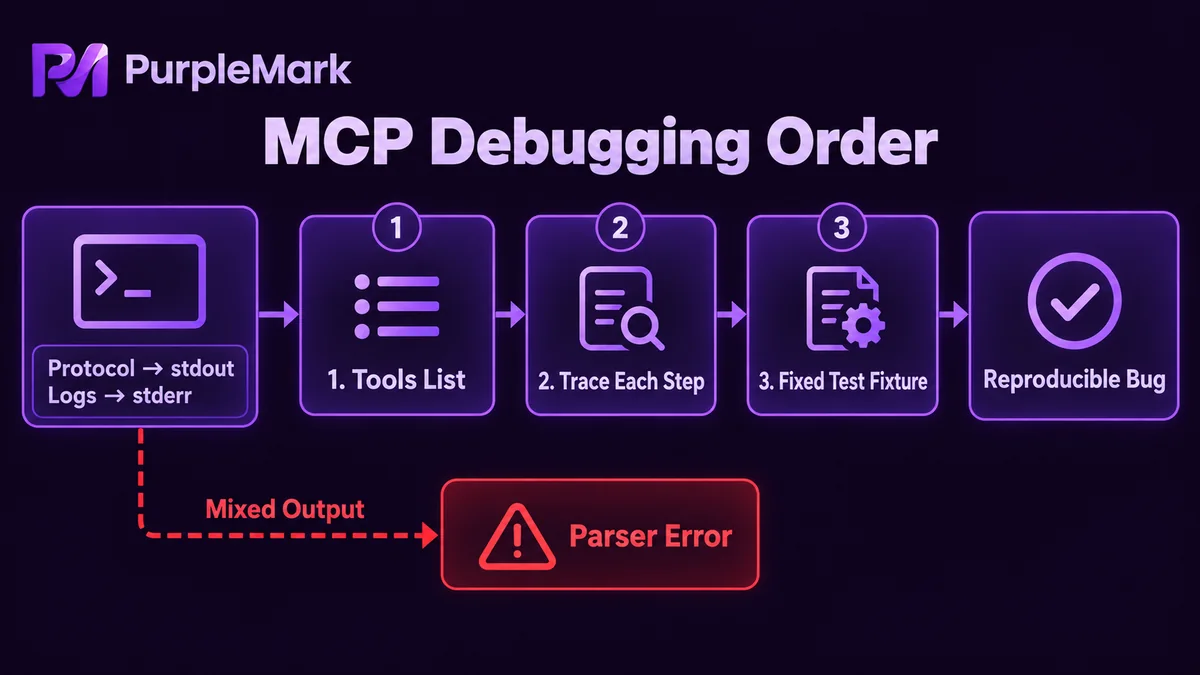
tools/list é o primeiro ponto de verificação. Se as declarações não forem carregadas, nenhuma chamada posterior ocorrerá. Confira primeiro os nomes das ferramentas, a estrutura do schema e se additionalProperties está bloqueando algum parâmetro.
O segundo ponto é um trace passo a passo. Registre em cada chamada o task_id, um resumo dos parâmetros, o tempo gasto e o código de resultado. Quando algo der errado, será possível ver se o bloqueio ocorreu na criação do ambiente, na navegação ou na validação. Guarde os parâmetros originais dos casos de falha para reproduzi-los exatamente — um bug reproduzível é muito mais rápido de corrigir.
O terceiro ponto é um conjunto de fixtures fixos: uma página de teste com conteúdo estável e alguns localizadores de elementos que não mudam. Rodar um smoke test depois de cada alteração na camada adaptadora economiza mais tempo do que qualquer validação verbal.
Limites de permissão
A camada adaptadora concentra mais permissões do que qualquer outra parte do sistema: credenciais, ambientes e operações de página passam por ela. Por isso, os limites precisam ser aplicados nesse ponto.
Mantenha as credenciais na configuração do servidor, não nos parâmetros das ferramentas nem no contexto do modelo. Separe as ferramentas por nível de risco: ferramentas somente leitura, como captura de tela e extração de texto, ficam habilitadas por padrão; ferramentas de escrita, como clicar, enviar e excluir, ficam desabilitadas por padrão e são ativadas temporariamente para cada tarefa. Assim, mesmo que o modelo erre, o impacto fica limitado.
Isole os ambientes por finalidade. Contas diferentes e tarefas diferentes devem usar ambientes diferentes; não misture usos no mesmo ambiente. Em cenários de várias contas, a criação do ambiente, a vinculação da saída de rede e a manutenção de estado podem ficar a cargo de uma camada específica de ambientes. Ferramentas como PurpleMark separam essa camada, enquanto a camada adaptadora cuida apenas da composição de negócio e da validação.
Mantenha logs de auditoria. Deve ser possível exportar por período qual tarefa usou qual ambiente e quais ferramentas de escrita foram chamadas. Quando ocorre um problema real, esse registro é a única forma de reconstruir o processo.
Por fim, o limite absoluto: a camada adaptadora não deve oferecer nenhum caminho para contornar regras de plataforma. Ações como cadastro em massa, contorno de verificações ou falsificação de identidade não devem ser empacotadas como ferramentas, nem mesmo sob o nome de ferramentas internas. Depois que uma ferramenta é exposta ao modelo, chamadas podem acontecer automaticamente; não existe um ponto confiável para bloqueá-las antes, e depois não há como desfazer o dano.
Para versões do protocolo e definições de campos, consulte a documentação oficial do MCP.


