
Les MCP Server prêts à l’emploi exposent surtout des primitives, si bien que l’Agent doit recomposer les actions métier et gérer les échecs à chaque fois. Une fine couche Flask centralise la déclaration des outils, le routage, l’exécution, la validation et la sémantique des erreurs.
Quand on connecte un environnement de navigateur à un AI Agent, un point est incontournable : les outils standard fournissent des primitives, mais les actions métier doivent encore être assemblées soi-même.
Prenons un exemple concret. Pour mener à bien une collecte, le déroulement réel consiste à « ouvrir un environnement pour une région, y associer la sortie réseau, effectuer une première visite de préchauffage et vérifier que la sortie fonctionne », puis seulement à confier le travail à l’Agent. Un MCP Server existant ne fournit généralement que des outils unitaires : ouvrir l’environnement, naviguer, cliquer, prendre une capture. Personne n’assemble la séquence précédente à votre place. L’Agent doit la reconstruire à partir de zéro à chaque fois, ce qui est lent, et il doit décider lui-même quoi faire si une étape intermédiaire échoue.
C’est précisément le rôle de la couche d’adaptation : garder de votre côté la logique composée, les validations et l’état, et n’exposer à l’extérieur qu’une seule action métier.
Structure minimale viable
Une couche d’adaptation opérationnelle n’a besoin que de trois blocs : déclaration des outils, routage des requêtes, puis exécution et retour. Avec Flask, un seul processus suffit.
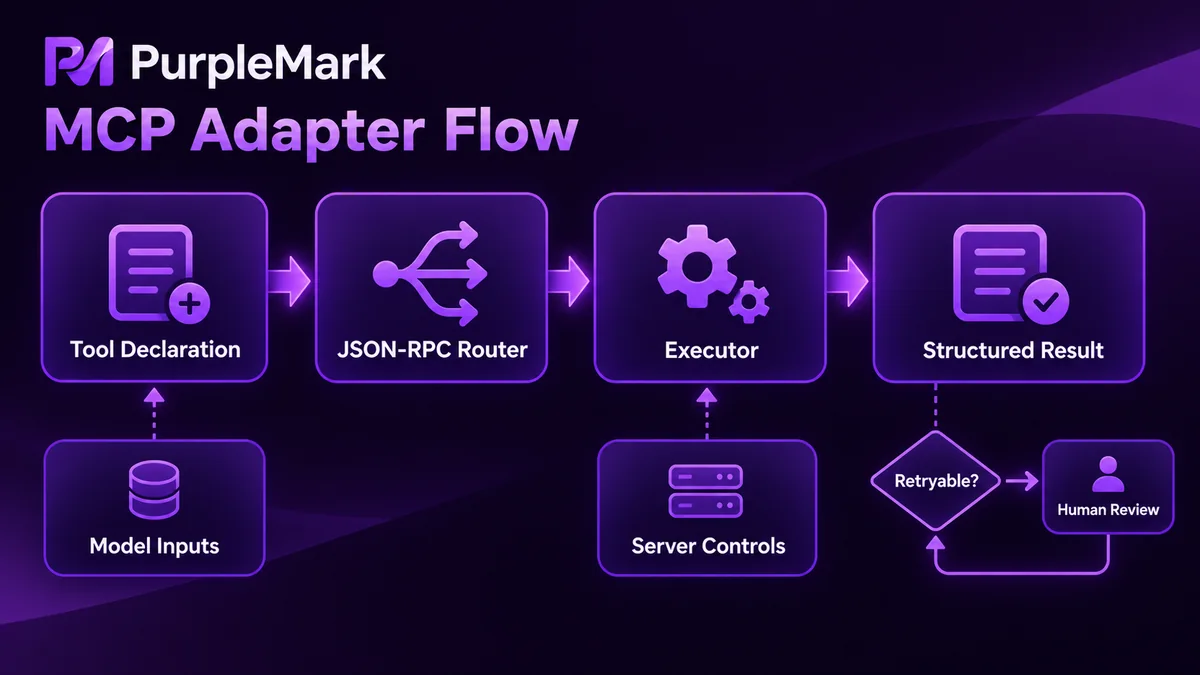
Commençons par la déclaration des outils : elle détermine ce que l’Agent peut voir.
# adapter/tools.py
TOOLS = [
    {
        "name": "prepare_environment",
        "description": "Préparer un environnement disponible pour une région puis renvoyer son ID",
        "inputSchema": {
            "type": "object",
            "properties": {
                "region": {"type": "string", "description": "Région de sortie, par exemple US-CA"},
                "purpose": {"type": "string", "description": "Étiquette d’usage pour la réutilisation et les statistiques de quota"},
                "timeout": {"type": "integer", "minimum": 10, "maximum": 120, "default": 60},
            },
            "required": ["region"],
            "additionalProperties": False,
        },
    },
    {
        "name": "open_page",
        "description": "Ouvrir une page dans l’environnement indiqué et attendre qu’elle soit interactive",
        "inputSchema": {
            "type": "object",
            "properties": {
                "env_id": {"type": "string"},
                "url": {"type": "string"},
            },
            "required": ["env_id", "url"],
            "additionalProperties": False,
        },
    },
]
Le routeur distribue les méthodes JSON-RPC. Le client demande d’abord tools/list, puis appelle tools/call par nom.
# adapter/app.py
from flask import Flask, request, jsonify
from adapter.tools import TOOLS
from adapter.runner import run_tool

app = Flask(__name__)

@app.post("/mcp")
def mcp():
    req = request.get_json(force=True)
    method, rid = req.get("method"), req.get("id")

    if method == "tools/list":
        return jsonify({"jsonrpc": "2.0", "id": rid, "result": {"tools": TOOLS}})

    if method == "tools/call":
        name = req["params"]["name"]
        args = req["params"].get("arguments", {})
        return jsonify({"jsonrpc": "2.0", "id": rid, "result": run_tool(name, args)})

    return jsonify({"jsonrpc": "2.0", "id": rid,
                    "error": {"code": -32601, "message": "method not found"}})
La couche d’exécution est le seul endroit qui touche l’API d’environnement et le protocole de page. Les enchaînements multiétapes y sont exécutés et les échecs y sont convertis vers un format uniforme.
# adapter/runner.py
def run_tool(name, args):
    try:
        payload = HANDLERS[name](**args)
        return ok(payload)
    except ToolError as e:
        return fail(e.code, e.retryable, e.message)
Il vaut mieux fixer tôt le format de retour. Ne transmettez pas à l’Agent les exceptions brutes des couches basses : il essaiera d’interpréter ces chaînes et pourra prendre des décisions incohérentes. Définissez une structure avec un code de résultat, par exemple {"ok": false, "code": "env_unavailable", "retryable": true, "attempts": 3}. L’Agent n’a alors que deux questions à trancher : peut-il réessayer, et faut-il confier le cas à une personne ?
Comment concevoir les paramètres
La granularité des outils doit suivre les actions métier, pas les API. Encapsuler chaque endpoint bas niveau dans un outil séparé revient à ne rien abstraire : l’Agent doit encore ordonner les étapes lui-même.
Pour les paramètres, la frontière est claire : ce que le modèle doit décider, et ce que la couche d’adaptation doit décider elle-même. La région, l’usage et l’URL cible appartiennent au premier groupe et sont fournis par le modèle. Le port de débogage, le nom d’une file interne ou le pool d’environnements appartiennent au second ; ils ne doivent pas apparaître dans le schema, sinon le modèle finira tôt ou tard par les remplir de travers.
Les sélecteurs sont un piège classique. Dès que la structure d’une page change, des appels avec des sélecteurs codés en dur peuvent casser en série. On peut laisser le modèle fournir des cibles sémantiques, par exemple un identifiant relativement stable comme « bouton de connexion », et maintenir la correspondance des sélecteurs dans la couche d’adaptation. Une seule modification suffit alors lorsque la page évolue.
Les paramètres numériques doivent toujours avoir une limite supérieure. Si le timeout, le nombre de tentatives ou la pagination n’ont pas de maximum dans le schema, le modèle peut fournir une valeur énorme et transformer un appel en tâche de plus de dix minutes. Tout outil qui contient une boucle doit avoir une fin explicite. Utilisez un champ comme max_pages pour borner le travail plutôt que « continuer jusqu’à ce qu’il n’y ait plus de données ».
Il faut aussi penser à l’idempotence. Faites passer un task_id par l’appelant ; une requête répétée peut alors renvoyer directement le résultat précédent et éviter qu’un retry de l’Agent ne crée deux environnements.
Gardez les retours compacts. Ne renvoyez pas les captures en base64 ; renvoyez une référence de fichier. Pour les listes, fournissez count et un indicateur de troncature au lieu d’injecter toute la table dans le contexte.
Trois points à vérifier en priorité lors du débogage
Avec stdio, JSON-RPC occupe stdout, donc les logs ne doivent jamais y être écrits. Un simple print peut casser immédiatement l’analyse du protocole et vous faire perdre beaucoup de temps. Envoyez les logs vers stderr ou vers un fichier.
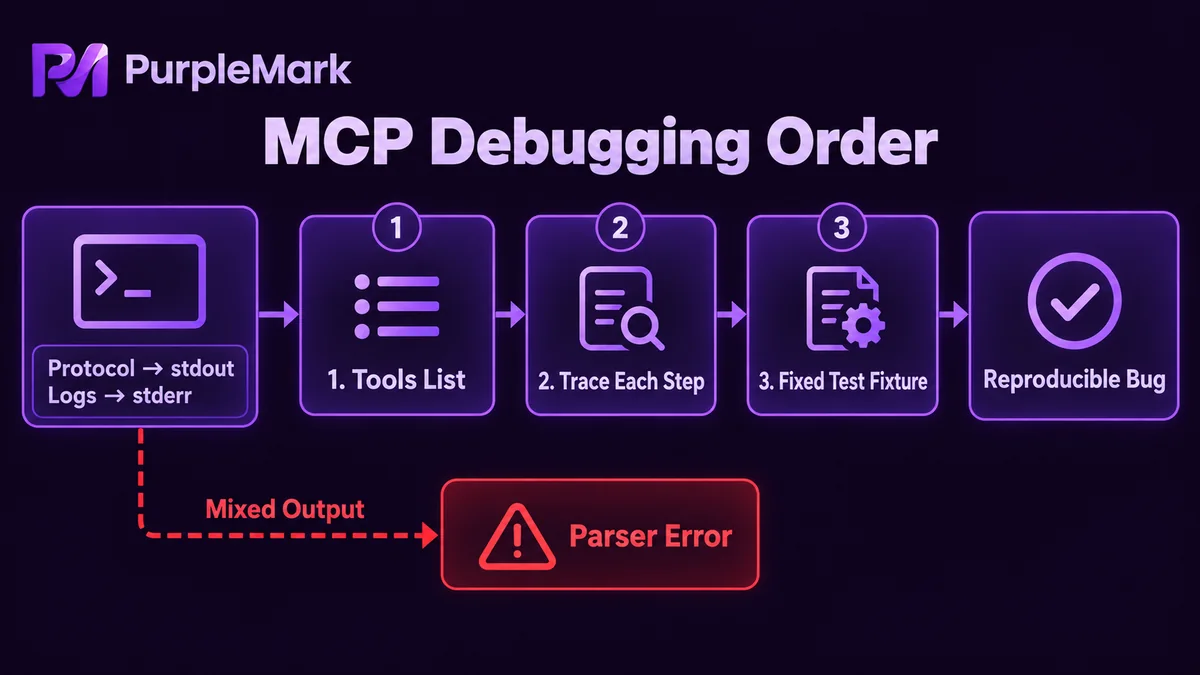
tools/list est le premier point de contrôle. Si les déclarations ne sont pas chargées, aucun appel ultérieur n’aura lieu. Vérifiez d’abord les noms d’outils, la structure du schema et si additionalProperties bloque des paramètres.
Le deuxième point de contrôle est un trace étape par étape. Pour chaque appel, enregistrez le task_id, un résumé des paramètres, la durée et le code de résultat. En cas de problème, vous voyez s’il se situe lors de la création de l’environnement, de la navigation ou de la validation. Conservez les paramètres d’origine des échecs afin de pouvoir les rejouer à l’identique : un bug reproductible se corrige bien plus vite.
Le troisième point est un jeu de fixtures fixes : une page de test au contenu stable et quelques localisateurs d’éléments qui ne changent pas. Lancer un smoke test après chaque modification de la couche d’adaptation est plus efficace que n’importe quelle vérification orale.
Limites de permissions
La couche d’adaptation est l’endroit où les permissions sont les plus concentrées de tout le système : identifiants, environnements et opérations de page passent tous par elle. Les limites doivent donc être imposées ici.
Conservez les identifiants dans la configuration serveur, jamais dans les paramètres d’outils ni dans le contexte du modèle. Séparez les outils selon leur niveau de risque : les outils en lecture seule, comme les captures et l’extraction de texte, sont activés par défaut ; les outils d’écriture, comme cliquer, soumettre ou supprimer, sont désactivés par défaut et activés temporairement pour une tâche. Même si le modèle se trompe, les dégâts restent ainsi limités.
Isolez les environnements selon leur usage. Des comptes différents et des tâches différentes doivent utiliser des environnements différents ; ne mélangez pas plusieurs usages dans le même environnement. Dans un contexte multicomptes, la création des environnements, l’association de la sortie réseau et la maintenance de l’état peuvent être confiées à une couche dédiée. Des outils comme PurpleMark isolent cette couche, tandis que la couche d’adaptation ne gère que la composition métier et la validation.
Conservez les journaux d’audit. Il faut pouvoir exporter par période quelle tâche a utilisé quel environnement et quels outils d’écriture ont été appelés. En cas de problème réel, cet historique est le seul moyen de reconstruire le déroulement.
Enfin, la limite absolue : la couche d’adaptation ne doit fournir aucun moyen de contourner les règles d’une plateforme. Les actions telles que l’inscription en masse, le contournement de vérifications ou la falsification d’identité ne doivent pas être exposées comme outils, même sous l’étiquette d’outils internes. Dès qu’un outil est exposé au modèle, les appels peuvent partir automatiquement ; il n’existe pas de point fiable pour les bloquer avant, ni de moyen d’annuler les conséquences après.
Pour les versions du protocole et la définition des champs, référez-vous à la documentation officielle de MCP.


