
Los MCP Server existentes suelen exponer solo primitivas; el Agent debe recomponer cada acción de negocio y decidir qué hacer ante fallos. Una capa adaptadora ligera con Flask centraliza herramientas, rutas, ejecución, validación y semántica de errores.
Al conectar un entorno de navegador con un AI Agent hay algo inevitable: las herramientas estándar ofrecen primitivas, pero las acciones de negocio hay que componerlas por cuenta propia.
Un ejemplo concreto. Para completar una ejecución de recopilación, el flujo real es «abrir un entorno para una región, asociar la salida, hacer una primera visita para calentarlo y confirmar que la salida funciona»; solo después se entrega al Agent. Un MCP Server ya preparado suele ofrecer únicamente herramientas de un paso, como abrir el entorno, navegar, hacer clic o tomar una captura. Nadie compone por ti la secuencia anterior. El Agent tiene que ordenarla desde cero cada vez, lo cual es lento, y además debe decidir qué hacer si falla cualquier paso intermedio.
Para eso sirve la capa adaptadora: mantener de tu lado la lógica compuesta, la validación y el estado, y exponer hacia fuera una sola acción de negocio.
Estructura mínima viable
Una capa adaptadora funcional solo necesita tres piezas: declaración de herramientas, enrutamiento de solicitudes y ejecución con respuesta. Con Flask, todo puede vivir en un único proceso.
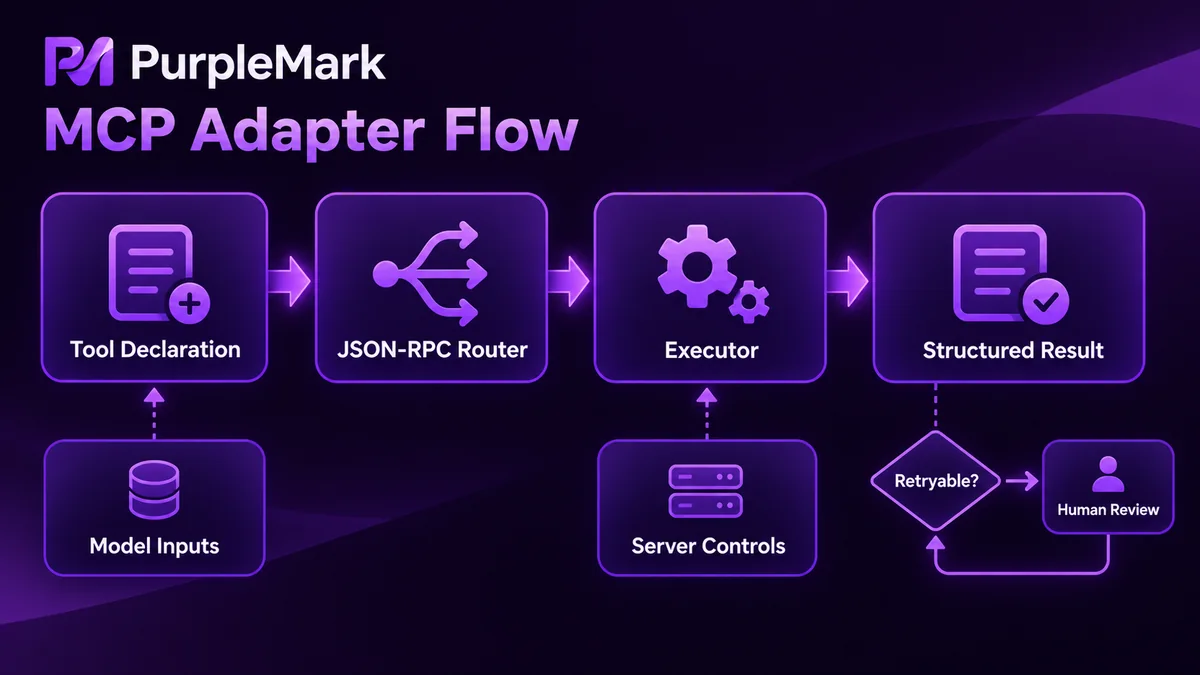
Empecemos por la declaración de herramientas, que determina qué puede ver el Agent.
# adapter/tools.py
TOOLS = [
    {
        "name": "prepare_environment",
        "description": "Preparar un entorno disponible para una región y devolver su ID al terminar",
        "inputSchema": {
            "type": "object",
            "properties": {
                "region": {"type": "string", "description": "Región de salida, por ejemplo US-CA"},
                "purpose": {"type": "string", "description": "Etiqueta de finalidad para reutilización y estadísticas de cuota"},
                "timeout": {"type": "integer", "minimum": 10, "maximum": 120, "default": 60},
            },
            "required": ["region"],
            "additionalProperties": False,
        },
    },
    {
        "name": "open_page",
        "description": "Abrir una página en el entorno indicado y esperar hasta que sea interactiva",
        "inputSchema": {
            "type": "object",
            "properties": {
                "env_id": {"type": "string"},
                "url": {"type": "string"},
            },
            "required": ["env_id", "url"],
            "additionalProperties": False,
        },
    },
]
El enrutador distribuye los métodos JSON-RPC. El cliente pregunta primero por tools/list y después invoca tools/call por nombre.
# adapter/app.py
from flask import Flask, request, jsonify
from adapter.tools import TOOLS
from adapter.runner import run_tool

app = Flask(__name__)

@app.post("/mcp")
def mcp():
    req = request.get_json(force=True)
    method, rid = req.get("method"), req.get("id")

    if method == "tools/list":
        return jsonify({"jsonrpc": "2.0", "id": rid, "result": {"tools": TOOLS}})

    if method == "tools/call":
        name = req["params"]["name"]
        args = req["params"].get("arguments", {})
        return jsonify({"jsonrpc": "2.0", "id": rid, "result": run_tool(name, args)})

    return jsonify({"jsonrpc": "2.0", "id": rid,
                    "error": {"code": -32601, "message": "method not found"}})
La capa de ejecución es el único lugar que toca la API del entorno y el protocolo de la página. Aquí se encadenan los pasos y aquí también se convierten los fallos a un formato uniforme.
# adapter/runner.py
def run_tool(name, args):
    try:
        payload = HANDLERS[name](**args)
        return ok(payload)
    except ToolError as e:
        return fail(e.code, e.retryable, e.message)
Conviene fijar pronto el formato de respuesta. No pases al Agent las excepciones de bajo nivel sin procesar; intentará interpretar esas cadenas y puede tomar decisiones extrañas. Define una estructura con código de resultado, por ejemplo {"ok": false, "code": "env_unavailable", "retryable": true, "attempts": 3}. Así el Agent solo debe decidir dos cosas: si puede reintentar y si debe escalar el caso a una persona.
Cómo diseñar los parámetros
La granularidad de las herramientas debe seguir las acciones de negocio, no las APIs. Envolver cada endpoint de bajo nivel como una herramienta independiente equivale a no abstraer nada: el Agent todavía debe ordenar los pasos por sí mismo.
En los parámetros hay una línea clara: lo que debe decidir el modelo y lo que debe decidir la propia capa adaptadora. Región, finalidad y URL de destino pertenecen al primer grupo y los completa el modelo. El puerto de depuración, los nombres de colas internas o el pool de entornos pertenecen al segundo; no deben aparecer en el schema, porque tarde o temprano el modelo los rellenará mal.
Los selectores son una fuente frecuente de problemas. Cuando cambia la estructura de una página, las llamadas con selectores codificados de forma rígida pueden fallar en bloque. Es mejor que el modelo pase objetivos semánticos, por ejemplo un identificador relativamente estable como «botón de inicio de sesión», y mantener el mapeo de selectores dentro de la capa adaptadora. Así basta cambiar una sola cosa cuando cambia la página.
Los parámetros numéricos necesitan límites superiores. Si timeout, número de reintentos o cantidad de páginas no tienen maximum en el schema, el modelo puede enviar un valor enorme y convertir una llamada en una tarea de más de diez minutos. Toda herramienta con lógica de bucle necesita un final explícito. Un campo como max_pages debe cerrar el alcance en lugar de indicar «seguir pasando páginas hasta que no haya datos».
También hay que pensar en la idempotencia. Haz que quien llama incluya un task_id; las solicitudes repetidas pueden devolver directamente el resultado anterior y evitar que un reintento del Agent cree el entorno dos veces.
Mantén pequeñas las respuestas. No devuelvas capturas en base64; devuelve una referencia de archivo. Para listas, incluye count y una marca de truncado en vez de meter la tabla completa en el contexto.
Tres puntos que conviene revisar primero al depurar
Con stdio, JSON-RPC ocupa stdout, así que los logs nunca deben escribirse en stdout. Un simple print puede romper el análisis del protocolo de inmediato y hacerte perder mucho tiempo investigando. Envía los logs a stderr o a un archivo.
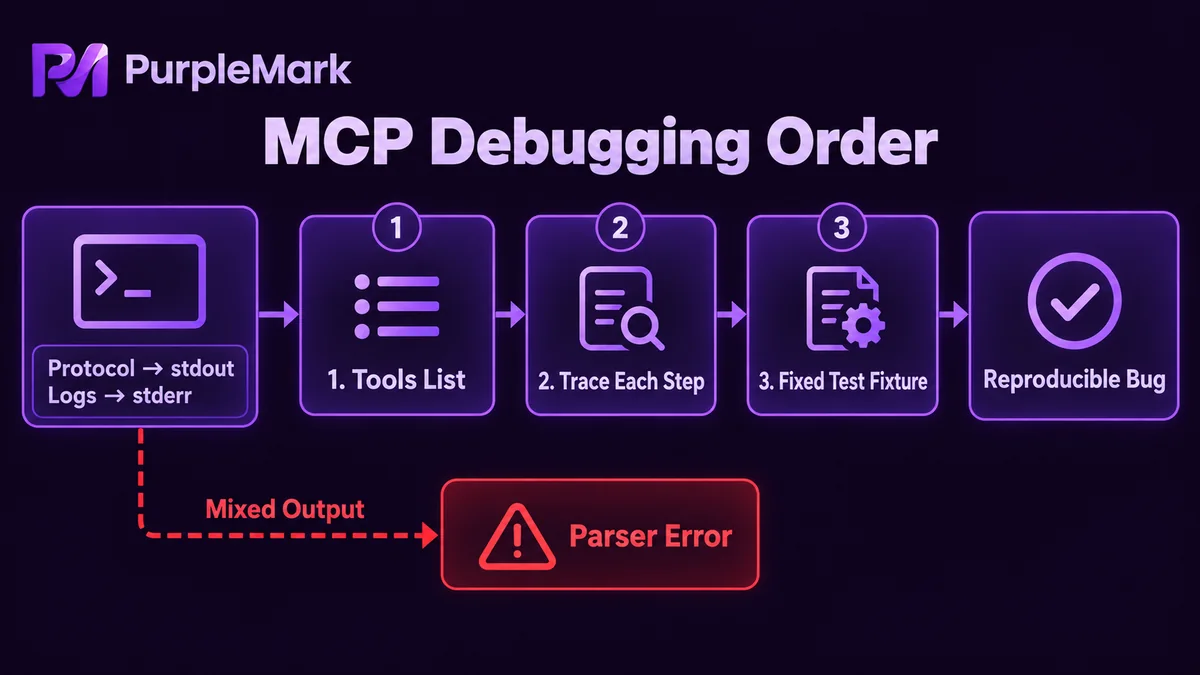
tools/list es el primer punto de control. Si las declaraciones no se cargan, ninguna llamada posterior ocurrirá. Comprueba primero los nombres de herramientas, la estructura del schema y si additionalProperties está bloqueando algún parámetro.
El segundo punto es un trace paso a paso. Registra en cada llamada el task_id, un resumen de parámetros, el tiempo empleado y el código de resultado. Cuando algo falle podrás ver si se atasca al crear el entorno, navegar o validar. Guarda los parámetros originales de los casos fallidos para reproducirlos exactamente: un bug reproducible se corrige mucho más rápido.
El tercer punto es un conjunto de fixtures fijos: una página de prueba estable y varios localizadores de elementos que no cambien. Ejecutar una prueba de humo después de cada cambio de la capa adaptadora ahorra más tiempo que cualquier comprobación verbal.
Límites de permisos
La capa adaptadora es el punto donde se concentran más permisos de todo el sistema: credenciales, entornos y operaciones de página están bajo su control. Por eso los límites deben aplicarse aquí.
Guarda las credenciales en la configuración del servidor, no en los parámetros de herramientas ni en el contexto del modelo. Separa las herramientas por nivel de riesgo: las de solo lectura, como capturas o extracción de texto, se activan por defecto; las de escritura, como hacer clic, enviar o borrar, se desactivan por defecto y se habilitan temporalmente según la tarea. Así el daño queda acotado incluso si el modelo se equivoca.
Aísla los entornos por finalidad. Cuentas distintas y tareas distintas deben usar entornos distintos; no mezcles usos en un mismo entorno. En escenarios de gestión multicuenta, la creación del entorno, la asociación de la salida de red y el mantenimiento del estado pueden delegarse a una capa específica de entornos. Herramientas como PurpleMark separan esa capa, mientras la capa adaptadora se ocupa solo de la composición de negocio y la validación.
Conserva los logs de auditoría. Debe poder exportarse por tiempo qué tarea usó qué entorno y qué herramientas de escritura invocó. Cuando ocurre un problema real, ese registro es la única forma de reconstruir el proceso.
Por último, el límite fundamental: la capa adaptadora no debe ofrecer ninguna vía para eludir las reglas de una plataforma. Acciones como registro masivo, evasión de verificaciones o falsificación de identidades no deben empaquetarse como herramientas ni ocultarse bajo la etiqueta de herramientas internas. Una vez expuesta una herramienta al modelo, las llamadas pueden ocurrir automáticamente; no hay un punto fiable para frenarlas antes ni forma de deshacer el daño después.
Para las versiones del protocolo y las definiciones de campos, consulta la documentación oficial de MCP.


