
现成的 MCP Server 只暴露原语,业务动作要自己串,Agent 每次都得重新拼一遍步骤。用 Flask 搭一层薄适配层,把工具声明、请求路由、执行返回和错误语义收在一处。
把浏览器环境接进 AI Agent,绕不开一件事:标准工具给的是原语,业务动作得自己拼。
举个具体的例子。你要跑通一次采集,实际动作是「按地区开一个环境,绑好出口,先访问一次做预热,确认出口可用」,然后才交给 Agent 干活。现成的 MCP Server 一般只提供开环境、导航、点击、截图这些单步工具,上面那串组合逻辑没人替你做。Agent 每次都得从零排一遍,慢,而且中间任何一步失败都得自己判断。
适配层就是干这个的:把组合逻辑、校验和状态收在自己这边,对外只暴露一个业务动作。
最小可用结构
一个能跑起来的适配层只需要三块:工具声明、请求路由、执行与返回。用 Flask 的话,一个进程就能装下。
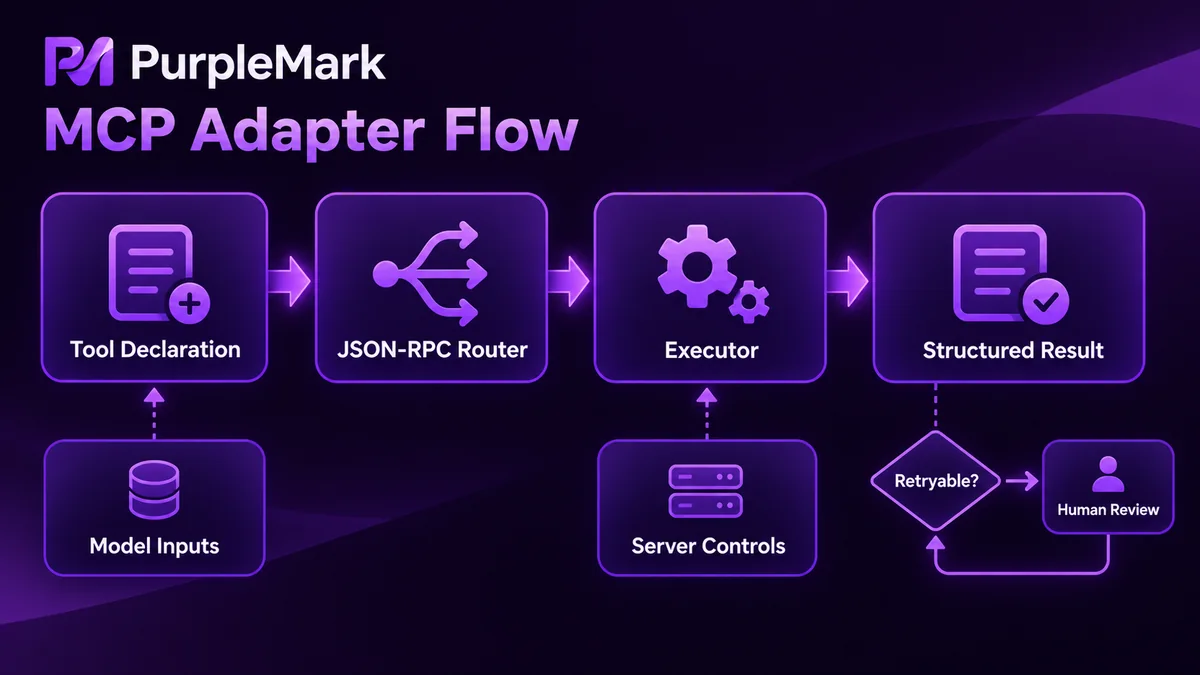
先看工具声明,它决定 Agent 能看见什么。
# adapter/tools.py
TOOLS = [
    {
        "name": "prepare_environment",
        "description": "按地区准备一个可用环境,完成后返回环境 ID",
        "inputSchema": {
            "type": "object",
            "properties": {
                "region": {"type": "string", "description": "出口地区,如 US-CA"},
                "purpose": {"type": "string", "description": "用途标签,用于复用与配额统计"},
                "timeout": {"type": "integer", "minimum": 10, "maximum": 120, "default": 60},
            },
            "required": ["region"],
            "additionalProperties": False,
        },
    },
    {
        "name": "open_page",
        "description": "在指定环境里打开页面并等待可交互",
        "inputSchema": {
            "type": "object",
            "properties": {
                "env_id": {"type": "string"},
                "url": {"type": "string"},
            },
            "required": ["env_id", "url"],
            "additionalProperties": False,
        },
    },
]
路由负责把 JSON-RPC 的方法分派出去。客户端会先问 tools/list,再按名字调 tools/call。
# adapter/app.py
from flask import Flask, request, jsonify
from adapter.tools import TOOLS
from adapter.runner import run_tool

app = Flask(__name__)

@app.post("/mcp")
def mcp():
    req = request.get_json(force=True)
    method, rid = req.get("method"), req.get("id")

    if method == "tools/list":
        return jsonify({"jsonrpc": "2.0", "id": rid, "result": {"tools": TOOLS}})

    if method == "tools/call":
        name = req["params"]["name"]
        args = req["params"].get("arguments", {})
        return jsonify({"jsonrpc": "2.0", "id": rid, "result": run_tool(name, args)})

    return jsonify({"jsonrpc": "2.0", "id": rid,
                    "error": {"code": -32601, "message": "method not found"}})
执行层是唯一碰环境接口和页面协议的地方,多步串联在这里完成,失败也在这里转成统一格式。
# adapter/runner.py
def run_tool(name, args):
    try:
        payload = HANDLERS[name](**args)
        return ok(payload)
    except ToolError as e:
        return fail(e.code, e.retryable, e.message)
返回格式值得早点定下来。别把底层异常原文丢给 Agent,它会试着解析那些字符串,然后做出莫名其妙的决定。约定一个带结果码的结构,比如 {"ok": false, "code": "env_unavailable", "retryable": true, "attempts": 3},Agent 只需要判断两件事:能不能重试,要不要交给人。
参数怎么设计
工具粒度按业务动作切,别按接口切。把底层每个接口都包一个工具,等于没封装,Agent 还得自己排序。
参数上有一条分界线:模型该决定的,和适配层自己决定的。地区、用途、目标 URL 属于前者,交给模型填;调试端口、内部队列名、从哪个环境池取,属于后者,不要出现在 schema 里,出现了迟早会被乱填。
选择器是个容易踩的地方。页面结构一变,写死在选择器上的调用会成片断掉。可以让模型传语义化的目标,比如登录按钮这类相对稳定的标识,把选择器映射留在适配层维护,改一处就够了。
数值参数一定要有上限。超时、重试次数、翻页数量如果在 schema 里不标 maximum,模型可能传一个很大的值,一次调用拖成十几分钟。凡是带循环语义的工具都要有明确终点,用 max_pages 这样的字段收口,而不是「翻到没有数据为止」。
幂等也要考虑。让调用方带一个 task_id,重复请求直接返回上次结果,避免 Agent 重试时把环境开两遍。
返回值尽量小。截图不要回 base64,回一个文件引用;列表结果带 count 和截断标记,别把整张表塞进上下文。
调试时先盯三处
走 stdio 的话,JSON-RPC 占着 stdout,日志绝对不能打到 stdout。随手写一行 print 就可能让协议解析当场崩掉,然后你排查半天。日志统一走 stderr 或文件。
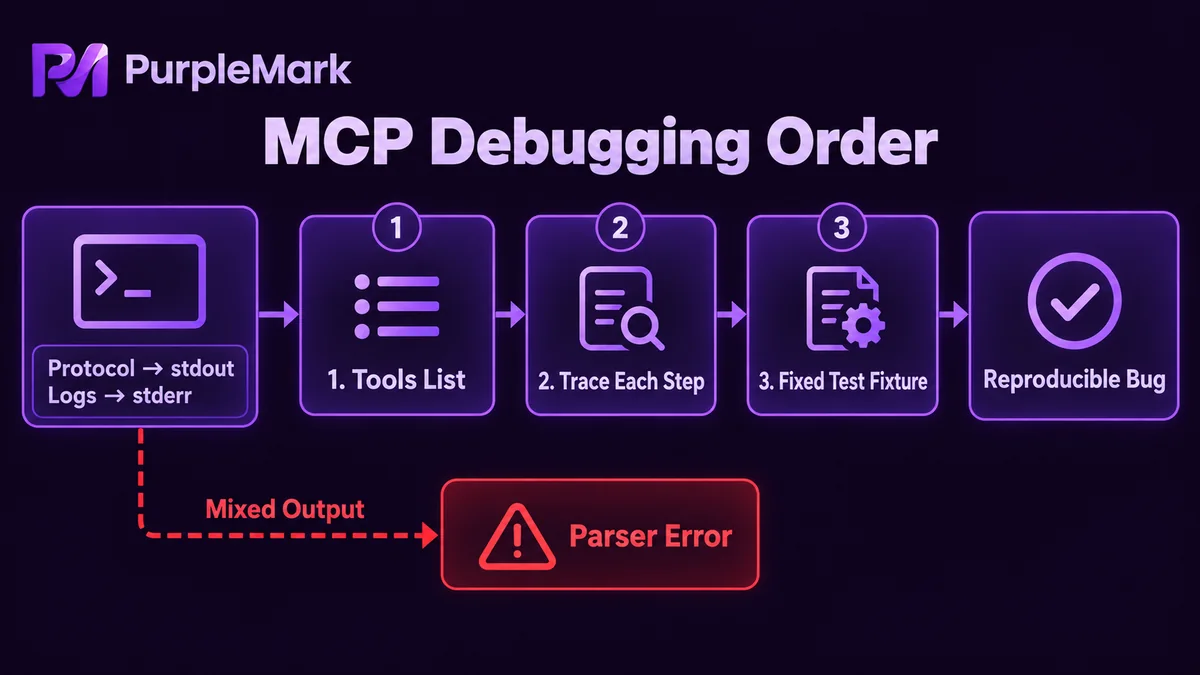
tools/list 是第一个检查点。声明没被读到,后面所有调用都不会发生。先确认工具名拼写、schema 结构和 additionalProperties 有没有把参数挡掉。
第二个检查点是逐步 trace。给每次调用记下 task_id、参数摘要、耗时和结果码,出问题时能看出是卡在开环境、导航还是校验环节。失败用例把原始参数存下来,能原样重放——能重放的 bug 才修得快。
第三个检查点是一组固定夹具:一个内容稳定的测试页,配上几个不会变的元素定位。每次改完适配层跑一遍冒烟,比任何口头验证都省事。
权限边界
适配层是全系统权限最集中的地方,凭证、环境、页面操作都在它手里,边界只能在这里划。
凭证放在服务端配置里,不进工具参数,也不进模型上下文。工具按危险程度分开关:截图、取文本这类只读工具默认开;点击、提交、删除这类写入工具默认关,按任务临时打开。这样即使模型判断失误,损失也是有上限的。
环境按用途隔离。不同账号、不同任务走不同环境,一套环境不混用。多账号管理的场景里,环境创建、网络出口绑定和状态维护可以交给专门的环境层能力,PurpleMark 这一类工具做的就是把这层隔开,适配层只负责业务组合与校验。
审计日志要留得下来。哪个任务、什么时间、用了哪个环境、调了哪些写入工具,能按时间导出。真出问题时,这份记录是唯一能还原过程的东西。
最后是底线:适配层不该提供任何绕过平台规则的入口。批量注册、绕过验证、伪造身份这类动作,不要包装成工具,也不要挂在内部工具的名义下。工具一旦暴露给模型,调用就是自动发生的,事前没有拦的地方,事后也补不回来。
协议版本与字段定义请以 MCP 官方文档为准。


