
Kant-en-klare MCP Servers bieden meestal alleen primitieve acties; de Agent moet bedrijfsstappen telkens opnieuw samenstellen en fouten zelf beoordelen. Een dunne Flask-adapterlaag bundelt tooldeclaraties, routing, uitvoering, validatie en foutsemantiek.
Wie een browseromgeving aan een AI Agent koppelt, loopt tegen één onvermijdelijk punt aan: standaardtools leveren primitieve bewerkingen, terwijl bedrijfsacties nog zelf moeten worden samengesteld.
Een concreet voorbeeld. Voor één volledige verzamelrun is de echte workflow: “open een omgeving voor een regio, koppel de uitgaande verbinding, bezoek één keer om op te warmen en controleer of de uitgaande verbinding werkt”, en pas daarna krijgt de Agent de taak. Een kant-en-klare MCP Server biedt meestal alleen losse tools voor een omgeving openen, navigeren, klikken en screenshots maken. Niemand zet die combinatie voor je in elkaar. De Agent moet de volgorde elke keer vanaf nul bepalen, wat traag is, en bij een fout in een tussenstap moet hij zelf beslissen wat er moet gebeuren.
Daar is de adapterlaag voor: houd combinatielogica, validatie en status aan je eigen kant en stel naar buiten toe slechts één bedrijfsactie beschikbaar.
Minimaal werkbare structuur
Een werkende adapterlaag heeft maar drie onderdelen nodig: tooldeclaraties, request-routing en uitvoering met resultaat. Met Flask kan dat allemaal in één proces.
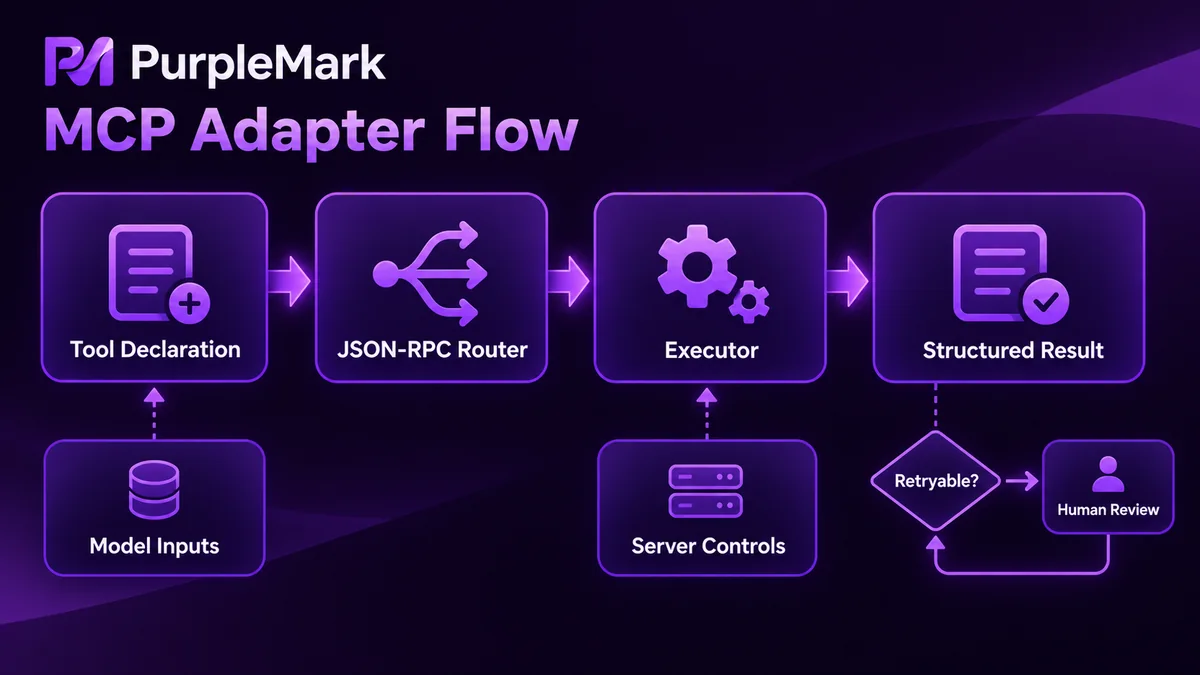
Begin met de tooldeclaraties; die bepalen wat de Agent kan zien.
# adapter/tools.py
TOOLS = [
    {
        "name": "prepare_environment",
        "description": "Een beschikbare omgeving voor een regio voorbereiden en daarna de omgevings-ID teruggeven",
        "inputSchema": {
            "type": "object",
            "properties": {
                "region": {"type": "string", "description": "Uitgaande regio, bijvoorbeeld US-CA"},
                "purpose": {"type": "string", "description": "Doellabel voor hergebruik en quotastatistieken"},
                "timeout": {"type": "integer", "minimum": 10, "maximum": 120, "default": 60},
            },
            "required": ["region"],
            "additionalProperties": False,
        },
    },
    {
        "name": "open_page",
        "description": "Een pagina openen in de opgegeven omgeving en wachten tot deze interactief is",
        "inputSchema": {
            "type": "object",
            "properties": {
                "env_id": {"type": "string"},
                "url": {"type": "string"},
            },
            "required": ["env_id", "url"],
            "additionalProperties": False,
        },
    },
]
De router verdeelt de JSON-RPC-methoden. De client vraagt eerst tools/list op en roept daarna tools/call aan op basis van de naam.
# adapter/app.py
from flask import Flask, request, jsonify
from adapter.tools import TOOLS
from adapter.runner import run_tool

app = Flask(__name__)

@app.post("/mcp")
def mcp():
    req = request.get_json(force=True)
    method, rid = req.get("method"), req.get("id")

    if method == "tools/list":
        return jsonify({"jsonrpc": "2.0", "id": rid, "result": {"tools": TOOLS}})

    if method == "tools/call":
        name = req["params"]["name"]
        args = req["params"].get("arguments", {})
        return jsonify({"jsonrpc": "2.0", "id": rid, "result": run_tool(name, args)})

    return jsonify({"jsonrpc": "2.0", "id": rid,
                    "error": {"code": -32601, "message": "method not found"}})
De uitvoeringslaag is de enige plek die de omgevings-API en het paginaprotocol raakt. Meerstapsreeksen worden hier afgehandeld en fouten worden hier naar één vast formaat omgezet.
# adapter/runner.py
def run_tool(name, args):
    try:
        payload = HANDLERS[name](**args)
        return ok(payload)
    except ToolError as e:
        return fail(e.code, e.retryable, e.message)
Het loont om het resultaatformaat vroeg vast te leggen. Geef ruwe fouten uit de onderlaag niet rechtstreeks aan de Agent; die zal de strings proberen te interpreteren en kan daardoor vreemde beslissingen nemen. Spreek een structuur met resultaatcode af, bijvoorbeeld {"ok": false, "code": "env_unavailable", "retryable": true, "attempts": 3}. Dan hoeft de Agent maar twee dingen te beoordelen: kan er opnieuw worden geprobeerd en moet een mens het overnemen?
Parameters ontwerpen
Kies de granulariteit van tools op basis van bedrijfsacties, niet op basis van API’s. Elk laag-niveau-endpoint afzonderlijk inpakken als tool is feitelijk geen abstractie; de Agent moet de stappen nog steeds zelf ordenen.
Voor parameters is er een duidelijke grens: wat het model moet beslissen en wat de adapterlaag zelf moet beslissen. Regio, doel en doel-URL horen bij de eerste groep en laat je door het model invullen. Debugpoort, interne wachtrijnamen en de keuze van een omgevingspool horen bij de tweede groep; zet ze niet in het schema, want vroeg of laat vult het model ze verkeerd in.
Selectors zijn een bekende valkuil. Als de paginastructuur verandert, kunnen hard gecodeerde selector-aanroepen in één keer massaal stukgaan. Laat het model liever semantische doelen doorgeven, zoals een relatief stabiele aanduiding als “inlogknop”, en beheer de selector-mapping in de adapterlaag. Dan hoef je bij een wijziging maar één plek aan te passen.
Numerieke parameters moeten altijd een bovengrens hebben. Als timeout, aantal retries of aantal pagina’s geen maximum in het schema hebben, kan het model een zeer grote waarde sturen en één aanroep laten uitlopen tot meer dan tien minuten. Elke tool met luslogica heeft een expliciet eindpunt nodig. Gebruik een veld als max_pages om het werk te begrenzen in plaats van “doorgaan tot er geen gegevens meer zijn”.
Denk ook aan idempotentie. Laat de aanroeper een task_id meesturen; herhaalde verzoeken kunnen dan direct het vorige resultaat teruggeven, zodat een retry van de Agent niet twee omgevingen opent.
Houd resultaten klein. Stuur screenshots niet terug als base64 maar als bestandsreferentie. Voeg bij lijsten count en een truncatievlag toe in plaats van de hele tabel in de context te stoppen.
Let bij debugging eerst op deze drie punten
Bij stdio gebruikt JSON-RPC stdout, dus logs mogen absoluut niet naar stdout. Eén losse print kan de protocolparser direct breken en je lang laten zoeken. Stuur logs consequent naar stderr of naar een bestand.
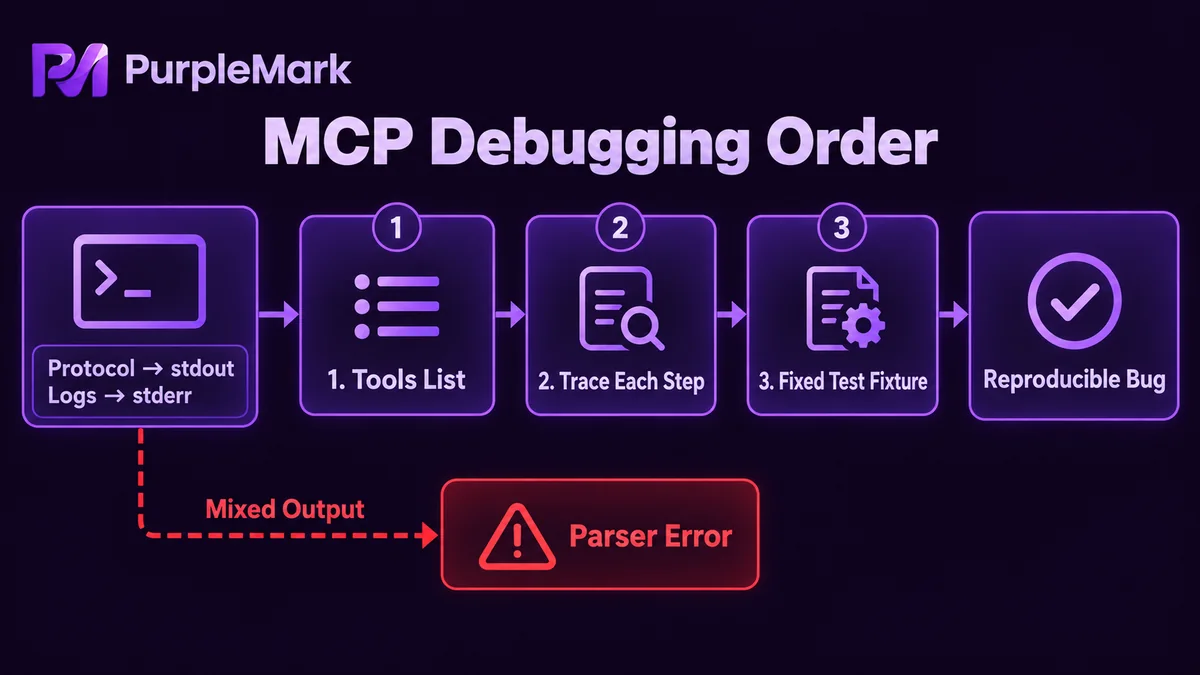
tools/list is het eerste controlepunt. Als de declaraties niet zijn geladen, zullen latere aanroepen helemaal niet plaatsvinden. Controleer eerst de toolnamen, de schema-structuur en of additionalProperties parameters blokkeert.
Het tweede controlepunt is een trace per stap. Leg voor elke aanroep task_id, een parametersamenvatting, doorlooptijd en resultaatcode vast. Bij een probleem zie je dan of het vastloopt bij het openen van de omgeving, navigatie of validatie. Bewaar de oorspronkelijke parameters van fouten zodat je ze exact kunt reproduceren — een reproduceerbare bug is veel sneller te repareren.
Het derde controlepunt is een vaste set fixtures: één stabiele testpagina met enkele elementlocators die niet veranderen. Na elke wijziging aan de adapterlaag een smoke-test uitvoeren bespaart meer tijd dan welke mondelinge controle ook.
Bevoegdheidsgrenzen
De adapterlaag is de plek waar de meeste bevoegdheden in het hele systeem samenkomen: credentials, omgevingen en paginabewerkingen liggen allemaal in haar handen. Daarom moeten de grenzen hier worden afgedwongen.
Bewaar credentials in serverconfiguratie, niet in toolparameters en niet in de modelcontext. Deel tools in op risico: alleen-lezen-tools zoals screenshots en tekstextractie zijn standaard ingeschakeld; schrijftools zoals klikken, verzenden en verwijderen zijn standaard uitgeschakeld en worden alleen tijdelijk voor een taak aangezet. Zo blijft de schade beperkt, zelfs als het model een verkeerde beslissing neemt.
Isoleer omgevingen per doel. Verschillende accounts en verschillende taken gebruiken verschillende omgevingen; meng ze niet in één omgeving. Bij beheer van meerdere accounts kunnen het aanmaken van omgevingen, het koppelen van de netwerkuitgang en statusbeheer worden overgelaten aan een gespecialiseerde omgevingslaag. Tools zoals PurpleMark scheiden die laag af, terwijl de adapterlaag alleen bedrijfscompositie en validatie afhandelt.
Bewaar auditlogs. Het moet mogelijk zijn om per tijdsperiode te exporteren welke taak welke omgeving gebruikte en welke schrijftools werden aangeroepen. Als er echt iets misgaat, is dat log de enige manier om het proces te reconstrueren.
Tot slot de harde grens: de adapterlaag mag geen mogelijkheid bieden om platformregels te omzeilen. Acties zoals massaregistratie, verificatie omzeilen of identiteiten vervalsen horen niet als tools te worden verpakt, ook niet onder het label “interne tool”. Zodra een tool aan het model is blootgesteld, kunnen aanroepen automatisch plaatsvinden; vooraf is er geen betrouwbare plek om ze tegen te houden en achteraf kun je de schade niet ongedaan maken.
Raadpleeg voor protocolversies en velddefinities de officiële MCP-documentatie.


