
При подключении ИИ к трансграничным операциям часто просто накапливают инструменты, а переходы между этапами остаются ручными. Разделение исследования товаров, контента, поддержки и анализа данных, а также аккаунтов и сред, делает весь процесс заметно стабильнее.
Самая частая проблема в трансграничных операциях — не ошибочный выбор инструмента, а запуск всех инструментов в одной среде, на одном компьютере и в одном браузере. Для исследования товаров, создания контента, поддержки клиентов и анализа данных нужны разные инструменты и часто разные идентичности аккаунтов. Если всё смешать, проблемы начинают накладываться друг на друга.
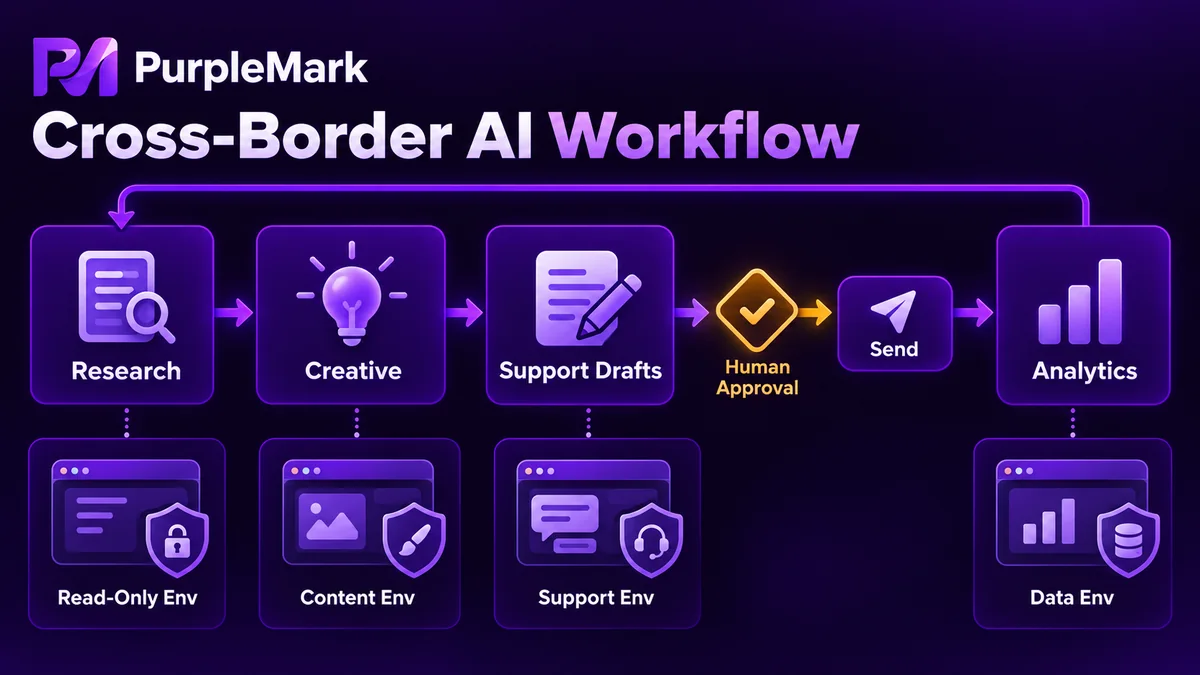
Исследование товаров: инструменты, которые читают страницы и выдают структурированные результаты
На этом этапе нужны поиск в интернете, чтение страниц и обобщение информации. Подходят инструменты, которые могут читать карточки товаров, отзывы и рейтинги на целевых сайтах и собирать публичные данные в таблицы: распределение ценовых диапазонов, часто упоминаемые жалобы в отзывах и плотность конкуренции в одной категории.
Сначала нужно задать границы. Следует соблюдать правила robots и условия использования целевых сайтов, не собирать персональные данные, контролировать частоту запросов и не мешать нормальной работе сервиса. Исследование выполняется только на чтение, поэтому требования к среде здесь относительно мягкие. Но регион выхода должен соответствовать целевому рынку, иначе страницы, цены и остатки могут отличаться, а выводы будут неверными.
Производство контента: один источник, версии для разных платформ
Тексты, изображения и сценарии коротких видео хорошо подходят для генеративных инструментов вместе с шаблонным процессом. В работе с несколькими платформами больше всего времени обычно уходит не на первую версию, а на адаптацию одних и тех же данных о товаре под Instagram, X и LinkedIn, где отличаются тон и длина. Переписывание можно поручить модели, а человеку оставить проверку финальной версии.
Самим материалам тоже нужно единое место хранения. Изображения и видео лучше держать в одном рабочем пространстве, чтобы при публикации ссылаться на них напрямую, а не пересылать файлы между несколькими инструментами и снова искать нужную версию.
Поддержка и электронная почта: только черновики, отправляет человек
Ответы и шаблоны поддержки подходят для моделей, умеющих читать контекст, но процесс должен останавливаться на стадии черновика. Всё, что касается обязательств, возвратов, обменов или цен, перед отправкой должен проверить человек. После отправки сообщение выступает от имени аккаунта, поэтому этот контрольный этап нельзя убирать.
Здесь используется идентичность аккаунтов, поэтому среду нужно отделить от других этапов. В среде с аккаунтами поддержки не следует запускать сбор данных или массовые публикации. Если идентичности смешиваются, одна аномалия на стороне поддержки может затронуть и операционную часть.
Анализ данных: сначала структура, затем тенденции
Результаты публикаций, охваты, взаимодействия и конверсии стоит архивировать в таблицах по дням, платформам и аккаунтам, а не хранить только большие объёмы текстовых логов. Логи полезны для поиска проблем, но плохо отвечают на вопросы, какой тип контента работает или какой аккаунт деградирует. Результаты этого слоя должны возвращаться в исследование товаров и производство контента как входные данные следующего цикла.
Подготовку, публикацию и разбор результатов можно непрерывно выполнять в одном рабочем пространстве. Внешне это выглядит как один непрерывный диалог, хотя за кулисами разные инструменты по-прежнему делают разные задачи и передают друг другу состояния и результаты.
Как разделить аккаунты и среды
Именно этот слой нужно проектировать осознанно. Правило одно: не размещайте все инструменты в одной среде.
- Для каждой бизнес-линии нужна относительно постоянная среда со своим выходом, согласованными часовым поясом и языком и отдельными локальными данными. Контентные, рекламные и сервисные аккаунты следует помещать в разные контейнеры
- Для операций разного характера используйте разные среды. Если смешать сбор данных только на чтение, работу с аккаунтами и массовую публикацию, состояния входа и сессии могут мешать друг другу, а одна аномалия затронет всё
- Среды должны быть стабильно привязаны к аккаунтам, а эти связи — записаны. Нужно понимать, кто и как долго использует среду, чтобы передача работы и диагностика опирались на факты
Когда сред становится много, вручную открывать окна и записывать связи с аккаунтами уже нереалистично. PurpleMark предоставляет независимые среды и функции пакетного управления. Каждый аккаунт можно закрепить за одной средой, запускать среды по группам и проверять их состояние, используя среды и выходы как планируемые ресурсы.
Есть ещё одна важная граница: по умолчанию инструмент должен доходить только до черновика, а кнопка публикации остаётся у человека. Это не автономное матричное управление аккаунтами. Что публиковать, когда публиковать и как использовать аккаунты — ответственность пользователя; он также должен соблюдать правила платформ и границы автоматизации.
Не подключайте все четыре этапа сразу
Начните с одной понятной задачи, которая повторяется каждый день, и доведите её до стабильной работы. Сначала проверьте устойчивость среды; полнота всего процесса на этом этапе не является целью. Затем передайте управление модели, умеющей планировать шаги, и наблюдайте, насколько надёжно она обрабатывает исключения. После этого добавьте слой структурированных данных и только затем расширяйтесь на остальные этапы поверх той же среды и данных. Так новый этап не требует заново строить управление средами и хранение данных, а преимущества слоистой архитектуры становятся заметны.
Различия между самими инструментами обычно влияют меньше, чем то, как организованы среды.


