
Al incorporar IA a las operaciones transfronterizas, es habitual acumular herramientas y seguir dependiendo de conexiones manuales. Separar la selección de productos, los contenidos, la atención al cliente y el análisis de datos, junto con las cuentas y los entornos, hace el flujo mucho más estable.
El fallo más común en las operaciones transfronterizas no es elegir la herramienta equivocada, sino concentrar todas las herramientas en el mismo entorno, el mismo ordenador y el mismo navegador. La selección de productos, la creación de contenidos, la atención al cliente y el análisis de datos requieren herramientas distintas y, a menudo, identidades de cuenta distintas. Mezclarlo todo hace que los problemas se acumulen.
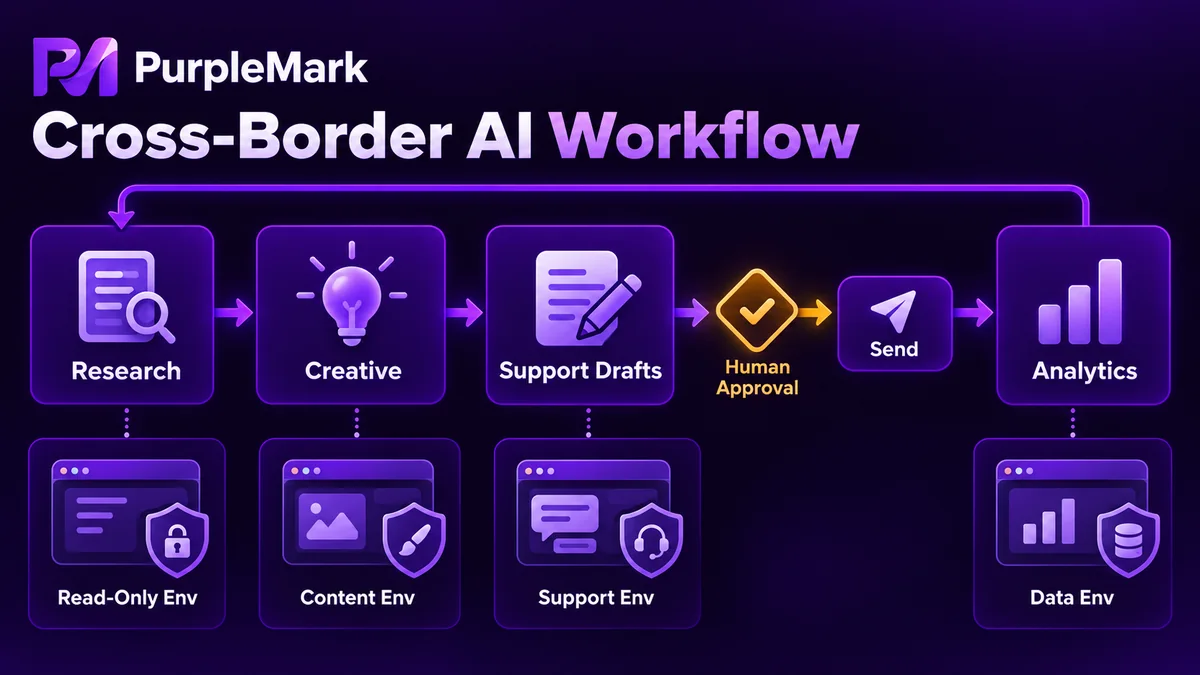
Investigación de productos: herramientas que leen páginas y generan resultados estructurados
Esta fase necesita búsqueda en línea, lectura de páginas y capacidad de resumen. Son adecuadas las herramientas que pueden leer páginas de productos, reseñas y clasificaciones en los sitios objetivo y organizar la información pública en tablas, por ejemplo, distribución por rangos de precios, quejas frecuentes en las reseñas y densidad competitiva dentro de una categoría.
Primero hay que definir los límites. Se deben respetar las reglas de robots y los términos de servicio de los sitios objetivo, no recopilar información personal, controlar la frecuencia de las solicitudes y no afectar al funcionamiento normal del servicio. Como la investigación solo lee y no escribe, sus requisitos de entorno son relativamente flexibles. Aun así, la región de salida debe coincidir con el mercado objetivo; de lo contrario, las páginas, los precios y el inventario pueden ser distintos y las conclusiones resultar incorrectas.
Producción de contenidos: una fuente, versiones para varias plataformas
Los textos, las imágenes y los guiones de vídeo corto encajan bien con herramientas generativas combinadas con un proceso basado en plantillas. En una operación multiplataforma, lo que más tiempo consume no suele ser redactar la primera versión, sino adaptar la misma información de producto para Instagram, X y LinkedIn, cada uno con un tono y una longitud diferentes. El modelo puede hacer las adaptaciones y una persona revisar únicamente la versión final.
Los propios materiales también necesitan un lugar unificado. Conviene guardar imágenes y vídeos en el mismo espacio de trabajo para citarlos directamente al publicar, en lugar de mover archivos entre varias herramientas o buscar una y otra vez la versión correcta.
Atención al cliente y correo: solo borradores, el envío lo hace una persona
Las respuestas y los textos de atención al cliente son adecuados para modelos que pueden leer el contexto, pero el flujo debe detenerse en el borrador. Todo lo relacionado con compromisos, devoluciones, cambios o precios debe revisarlo una persona antes del envío. Una vez enviado, el mensaje representa a la cuenta, por lo que este control no puede eliminarse.
Esta fase utiliza identidades de cuenta, así que su entorno debe estar separado del resto. El entorno donde están las cuentas de atención al cliente no debe ejecutar tareas de recopilación ni publicaciones masivas. Si las identidades se mezclan, una anomalía en atención al cliente puede afectar también a las operaciones.
Análisis de datos: primero estructurar, después observar tendencias
Los resultados de publicación, el alcance, las interacciones y las conversiones deben archivarse en tablas por día, plataforma y cuenta, en vez de conservar únicamente grandes cantidades de texto de registro. Los logs sirven para investigar problemas, pero no para responder qué tipo de contenido funciona o qué cuenta está deteriorándose. Los resultados de esta capa deben volver a la investigación de productos y a la producción de contenidos como entrada de la siguiente ronda.
Es posible ejecutar de forma continua la preparación, la publicación y la revisión en un mismo espacio de trabajo. Puede parecer una sola conversación ininterrumpida, aunque por detrás distintas herramientas sigan realizando tareas diferentes y conectándose mediante estados y resultados.
Cómo repartir cuentas y entornos
Esta es la capa que realmente necesita un diseño deliberado. La regla es una sola: no concentrar todas las herramientas en el mismo entorno.
- Cada línea de negocio debe tener un entorno relativamente fijo, con su propia salida, una configuración coherente de zona horaria e idioma y datos locales independientes. Las cuentas de contenido, publicidad y atención al cliente deben estar en contenedores distintos
- Las operaciones de naturaleza diferente deben usar entornos diferentes. Mezclar recopilación de solo lectura, operación de cuentas y publicación masiva puede provocar conflictos de sesión y de estado de inicio de sesión, de modo que una anomalía termine afectando a todo
- Los entornos deben vincularse de forma fija a las cuentas y quedar registrados. Saber quién los usa y durante cuánto tiempo da una base para los traspasos y la resolución de problemas
Cuando aumenta el número de entornos, abrir ventanas manualmente y anotar las relaciones entre cuentas deja de ser viable. PurpleMark ofrece entornos independientes y gestión por lotes. Cada cuenta puede quedar fija en un entorno, los entornos pueden iniciarse por grupos y su estado puede consultarse, de forma que los entornos y las salidas se utilicen como recursos programables.
También hay que dejar claro otro límite: las herramientas deben llegar por defecto solo hasta el borrador y el botón de publicar debe permanecer en manos humanas. No se trata de un control matricial desatendido. Qué se publica, cuándo se publica y cómo se usa cada cuenta sigue siendo responsabilidad del usuario, que también debe respetar las reglas de la plataforma y los límites de la automatización.
No conectes las cuatro fases de una sola vez
Empieza con una tarea clara y repetitiva que se haga a diario y consigue que funcione de principio a fin. Primero valida la estabilidad del entorno; en esta fase el objetivo no es completar todo el proceso. Después deja que un modelo capaz de planificar pasos dirija el flujo y observa si gestiona las excepciones de forma fiable. A continuación añade la capa de datos estructurados y solo al final amplía a las demás fases sobre la misma base de entorno y datos. Así, cada nueva fase no exige rehacer la gestión de entornos ni el almacenamiento de datos y se hace visible la ventaja de trabajar por capas.
Las diferencias entre herramientas suelen influir menos que la forma en que se organizan los entornos.


