
Dans les opérations transfrontalières, ajouter des outils d’IA conduit souvent à multiplier les raccords manuels. Répartir le travail entre recherche produit, contenu, service client et analyse de données, puis séparer comptes et environnements, rend l’ensemble beaucoup plus stable.
Dans les opérations transfrontalières, l’échec le plus fréquent ne vient pas du choix d’un mauvais outil, mais du fait de faire fonctionner tous les outils dans le même environnement, sur le même ordinateur et dans le même navigateur. La recherche produit, la création de contenu, le service client et l’analyse de données n’ont pas besoin des mêmes outils ni toujours des mêmes identités de compte. Les mélanger cumule les problèmes.
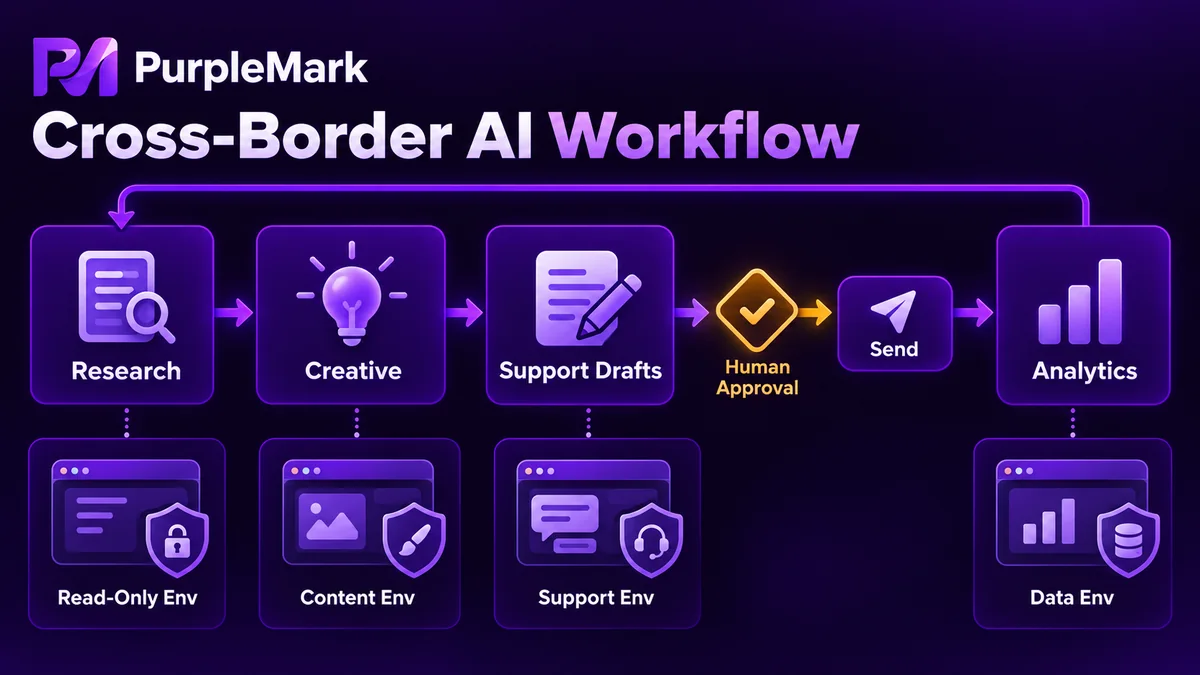
Recherche produit : des outils capables de lire les pages et de produire des résultats structurés
Cette étape demande des capacités de recherche en ligne, de lecture de pages et de synthèse. Les outils adaptés peuvent lire les fiches produit, les avis et les classements sur les sites cibles, puis organiser les informations publiques dans des tableaux : répartition des prix, plaintes fréquemment citées dans les avis et densité de concurrence dans une même catégorie.
Il faut d’abord fixer les limites. Respectez les règles robots et les conditions d’utilisation des sites cibles, ne collectez pas de données personnelles, maîtrisez la fréquence des requêtes et n’affectez pas le fonctionnement normal du service. La recherche est en lecture seule, donc ses contraintes d’environnement sont relativement souples. En revanche, la région de sortie doit correspondre au marché cible ; sinon, les pages, les prix et les stocks visibles peuvent différer et fausser les conclusions.
Production de contenu : une source, plusieurs adaptations par plateforme
Les textes, les images et les scripts de vidéos courtes se prêtent bien aux outils génératifs, associés à un processus basé sur des modèles. Dans une activité multiplateforme, le plus long n’est généralement pas de rédiger la première version, mais d’adapter les mêmes informations produit pour Instagram, X et LinkedIn, avec un ton et une longueur propres à chaque plateforme. Le modèle peut faire ces réécritures, tandis qu’une personne vérifie la version finale.
Les ressources elles-mêmes doivent aussi avoir un emplacement unique. Conservez images et vidéos dans le même espace de travail afin de les référencer directement lors de la publication, au lieu de transférer les fichiers entre plusieurs outils ou de rechercher sans cesse la bonne version.
Service client et e-mail : seulement des brouillons, l’envoi reste humain
Les réponses et formulations de service client conviennent aux modèles capables de lire le contexte, mais le processus doit s’arrêter au brouillon. Tout contenu concernant un engagement, un retour, un échange ou un prix doit être relu par une personne avant l’envoi. Une fois envoyé, le message engage le compte ; cette étape de contrôle ne peut donc pas disparaître.
Cette phase utilise l’identité des comptes et doit donc être séparée des autres environnements. L’environnement contenant les comptes de service client ne doit exécuter ni collecte de données ni publication en masse. Si les identités sont mélangées, une anomalie côté support peut se répercuter sur les opérations.
Analyse de données : structurer d’abord, observer les tendances ensuite
Archivez dans des tableaux les résultats de publication, la portée, les interactions et les conversions par jour, plateforme et compte, au lieu de conserver uniquement de grandes quantités de logs. Les journaux sont utiles pour diagnostiquer un problème, mais pas pour déterminer quel type de contenu fonctionne ou quel compte se dégrade. Les résultats de cette couche doivent revenir vers la recherche produit et la production de contenu comme entrées du cycle suivant.
Il est possible d’enchaîner préparation, publication et bilan dans un même espace de travail. Cela peut ressembler à une conversation continue, alors qu’en arrière-plan différents outils continuent d’exécuter leurs propres tâches et de se transmettre des états et des résultats.
Comment répartir les comptes et les environnements
C’est cette couche qui doit être conçue volontairement. Le principe tient en une règle : ne placez pas tous les outils dans le même environnement.
- Une ligne d’activité correspond à un environnement relativement stable, avec sa propre sortie, un ensemble cohérent de fuseau horaire et de langue, ainsi que des données locales séparées. Les comptes de contenu, de publicité et de service client sont placés dans des conteneurs différents
- Des opérations de nature différente utilisent des environnements différents. Mélanger collecte en lecture seule, gestion de comptes et publication en masse peut provoquer des conflits de session ou d’état de connexion, et une seule anomalie peut alors affecter l’ensemble
- Les environnements sont liés de manière stable aux comptes et cette relation est enregistrée. Il faut pouvoir savoir qui les utilise et depuis combien de temps pour faciliter les transmissions et le diagnostic
Quand le nombre d’environnements augmente, ouvrir manuellement des fenêtres et noter les associations de comptes n’est plus réaliste. PurpleMark fournit des environnements indépendants et des fonctions de gestion par lots. Chaque compte peut rester associé à un environnement, les environnements peuvent être lancés par groupe et leur état consulté, ce qui permet de traiter environnements et sorties comme des ressources planifiables.
Une autre limite doit être explicite : par défaut, les outils s’arrêtent au brouillon et le bouton de publication reste entre les mains d’une personne. Il ne s’agit pas d’un pilotage matriciel sans surveillance. Le contenu publié, le moment de publication et l’usage des comptes restent sous la responsabilité de l’utilisateur, qui doit aussi respecter les règles des plateformes et les limites de l’automatisation.
Ne connectez pas les quatre étapes d’un seul coup
Commencez par une tâche claire, répétée chaque jour, et faites fonctionner ce flux de bout en bout. Vérifiez d’abord la stabilité de l’environnement ; à ce stade, l’objectif n’est pas de couvrir tout le processus. Confiez ensuite le pilotage à un modèle capable de planifier les étapes et observez la fiabilité de son traitement des anomalies. Ajoutez ensuite la couche de données structurées, puis étendez seulement après aux autres étapes sur la même base d’environnement et de données. Ainsi, l’ajout d’une nouvelle étape n’oblige pas à reconstruire la gestion des environnements ni le stockage, et les avantages de l’architecture en couches deviennent visibles.
Les différences entre les outils ont généralement moins d’impact que la manière dont les environnements sont organisés.


