
요소 찾기, 상호작용 가능 상태까지 기다리기, 동작 실행, 결과 검증. 자동화의 한 동작은 이 네 단계로 구성됩니다. 선택자, 동적 로딩, iframe, Shadow DOM의 특성을 이해하면 더 오래 안정적으로 동작하는 스크립트를 만들 수 있습니다.
웹 자동화는 흔히 프로그램이 대신 버튼을 눌러 주는 것이라고 생각합니다. 하지만 실제로 구현해 보면 하나의 동작은 네 단계로 이루어지고, 어느 한 단계라도 잘못되면 아무 일도 일어나지 않은 것처럼 보일 수 있다는 점을 알게 됩니다.
먼저 자주 혼동되는 두 개념을 구분해 보겠습니다. 웹 자동화는 더 넓은 범위의 개념으로, 원래 사람이 웹 페이지에서 해야 할 일을 프로그램으로 수행하는 모든 것을 포함하며 요청을 통해 데이터를 직접 가져오는 것도 여기에 들어갑니다. 브라우저 자동화는 그중 더 구체적인 분야로, 프로그램이 실제 브라우저를 제어해 페이지를 열고 JavaScript를 실행하며 클릭과 입력을 모방합니다. 동적 콘텐츠가 많거나 상호작용이 복잡한 경우에는 대체로 후자의 방식이 필요합니다.
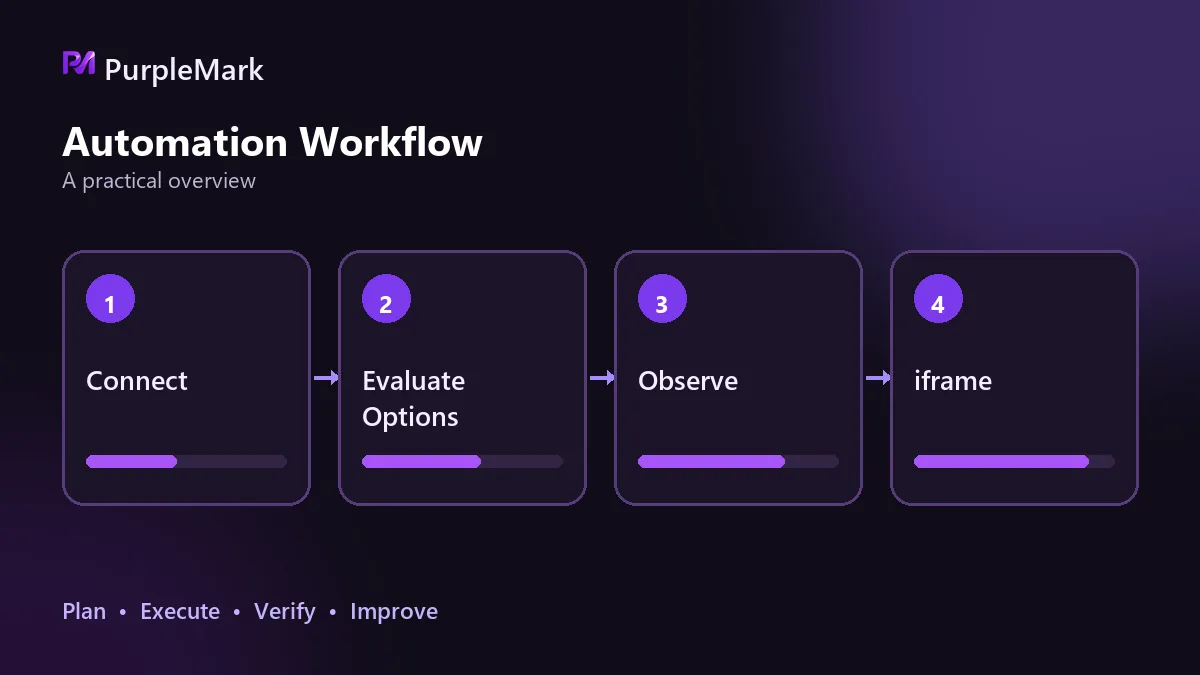
한 동작의 네 단계
- 요소 찾기: id, name, class, CSS 선택자 또는 XPath로 대상 요소를 특정합니다. 의미가 분명한 속성을 우선 사용하고, 어쩔 수 없을 때만 구조나 인덱스에 의존합니다.
- 상호작용 가능 상태까지 기다리기: 요소가 DOM에 존재한다고 해서 바로 클릭할 수 있는 것은 아닙니다. 보이거나 클릭 가능해질 때까지, 또는 특정 요청이 돌아올 때까지 기다립니다. 기다리는 대상은 시간이 아니라 조건입니다.
- 동작 실행: 클릭, 입력, 스크롤을 수행합니다. 사용자 정의 컴포넌트는 실제 사람이 하는 순서를 재현해야 하는 경우가 많습니다. 먼저 펼치고, 목록이 렌더링되기를 기다린 뒤, 텍스트를 기준으로 선택합니다.
- 결과 검증: 동작 후 결과가 올바른지 확인합니다. 링크가 바뀌었는지, 페이지 문구가 달라졌는지, API가 무엇을 반환했는지 살펴봅니다. 이 단계가 없으면 실패를 성공으로 처리할 수 있고, 이후 재시도와 알림도 신뢰할 기준을 잃습니다.
네 단계 가운데 두 번째와 네 번째가 보통 디버깅 시간을 가장 많이 사용합니다. 어려워서가 아니라 오류를 내지 않은 채 조용히 잘못된 결과를 만들 수 있기 때문입니다.
선택자의 안정성이 스크립트 수명을 결정한다
페이지가 바뀌면 하드코딩한 locator는 쉽게 깨집니다. 문구, 위치, 인덱스로 요소를 찾는 방식은 변화에 가장 약합니다. 버튼 하나가 추가되거나 안내 문구 하나가 바뀌는 것만으로도 전체가 틀어질 수 있습니다.
id, name, data 속성을 사용할 수 있다면 우선 사용합니다. 구조 기반 locator가 필요하다면 한곳에 모아 두어 수정할 때 수십 줄을 고치지 않도록 합니다. 한 번 작성하면 더 이상 관리할 필요가 없다고 기대해서도 안 됩니다. 웹사이트 업데이트는 흔하고, 스크립트 유지보수 비용의 큰 부분이 이 지점에서 발생합니다.
동적 로딩: 얼마나 오래 기다리느냐보다 무엇을 기다리느냐가 중요하다
요즘은 초기 로딩이 끝났다고 모든 것이 준비되는 페이지가 드뭅니다. 데이터가 비동기 요청으로 렌더링되기 때문에 요소가 예상보다 늦게 나타납니다.
고정 대기는 가장 흔한 방법이지만 실패하기도 쉽습니다. 3초 대기는 느린 머신에서는 부족할 수 있고, 빠른 머신에서는 그저 시간 낭비입니다. 올바른 방법은 특정 조건이 성립할 때까지 기다리고 요소가 실제로 클릭 가능해진 뒤 동작하는 것입니다.
요소를 찾지 못한다면 먼저 iframe과 Shadow DOM을 확인한다
요소가 화면에 분명히 보이는데 스크립트가 찾지 못한다면 선택자보다 범위가 문제인 경우가 많습니다.
iframe은 독립된 문서입니다. 요소를 찾기 전에 해당 frame으로 전환하고, 작업이 끝난 뒤 다시 빠져나와야 합니다. 그렇지 않으면 이후 탐색이 잘못된 컨텍스트에서 이루어집니다. Shadow DOM 안의 노드는 바깥쪽 CSS 선택자로 직접 찾을 수 없습니다. 먼저 shadow root를 얻고 그 내부에서 찾아야 합니다. 이 두 상황은 페이지 개편으로 오해되기 쉬워 불필요한 디버깅 시간을 만들곤 합니다.
놓치기 쉬운 두 가지가 더 있다
첫째는 세션입니다. 로그인이 필요한 작업은 로그인 상태를 어떻게 저장하고 재사용할지 고려해야 합니다. 그렇지 않으면 실행할 때마다 다시 로그인해야 하고, 중간의 인증 단계에서 막힐 수도 있습니다.
둘째는 환경입니다. 모든 작업이 하나의 브라우저 환경을 공유하면 세션과 캐시가 서로 오염될 수 있습니다. 따로 실행할 때는 문제없던 작업이 함께 돌면 간섭하기 시작할 수 있습니다. 작업이 하나에서 여러 개로 늘어날 때 환경 격리를 별도 계층으로 두면 많은 문제를 줄일 수 있습니다. PurpleMark 같은 도구는 각 환경에 독립적인 fingerprint와 독립적인 proxy를 제공하고, 자동화 프레임워크는 동작 실행에 집중합니다.
시작 전에 한 가지 경계를 확인해야 한다
자동화가 대체할 수 있는 것은 반복 작업이지, 실제 사람의 참여가 필요한 단계는 아닙니다. 대상 흐름에 실시간 얼굴 인증이나 사람의 수동 검토가 포함된다면 그 흐름을 100% 자동화할 수는 없습니다.
따라서 가장 단순한 방식으로 먼저 검증해 보세요. 전체 흐름을 직접 수동으로 끝까지 진행하고, 각 단계를 기록하며 통과할 수 없는 구간이 있는지 확인합니다. 그다음에 얼마나 개발에 투자할지 결정합니다. 기술적으로 가능하다는 것과 규칙상 허용된다는 것도 서로 다른 문제이므로, 대상 플랫폼의 서비스 약관을 미리 확인해야 합니다.


