
एलिमेंट ढूँढना, उसके इंटरैक्टिव होने का इंतज़ार करना, एक्शन चलाना और नतीजे की जाँच करना—हर ऑटोमेशन एक्शन के ये चार चरण हैं। सेलेक्टर, डायनेमिक लोडिंग, iframe और shadow DOM को समझने से स्क्रिप्ट अधिक समय तक भरोसेमंद रहती है।
वेब ऑटोमेशन को अक्सर ऐसे समझा जाता है कि कोई प्रोग्राम आपकी जगह बटन क्लिक कर दे। लेकिन जब इसे वास्तव में बनाया जाता है, तो पता चलता है कि हर एक्शन के चार चरण होते हैं, और किसी एक में भी गलती हो तो ऐसा लग सकता है कि कुछ हुआ ही नहीं।
पहले दो ऐसे कॉन्सेप्ट अलग कर लें जिन्हें आसानी से मिला दिया जाता है। वेब ऑटोमेशन का दायरा बड़ा है: किसी प्रोग्राम से वह काम करवाना जो सामान्यतः कोई व्यक्ति वेब पेज पर करता, इसमें सीधे requests से डेटा लेना भी शामिल है। ब्राउज़र ऑटोमेशन इसका अधिक विशिष्ट हिस्सा है: प्रोग्राम एक वास्तविक ब्राउज़र को नियंत्रित करके पेज खोलता है, JavaScript चलाता है और क्लिक व टाइपिंग की नकल करता है। जहाँ बहुत अधिक डायनेमिक कंटेंट या जटिल इंटरैक्शन हों, वहाँ आम तौर पर यही दूसरा तरीका चाहिए।
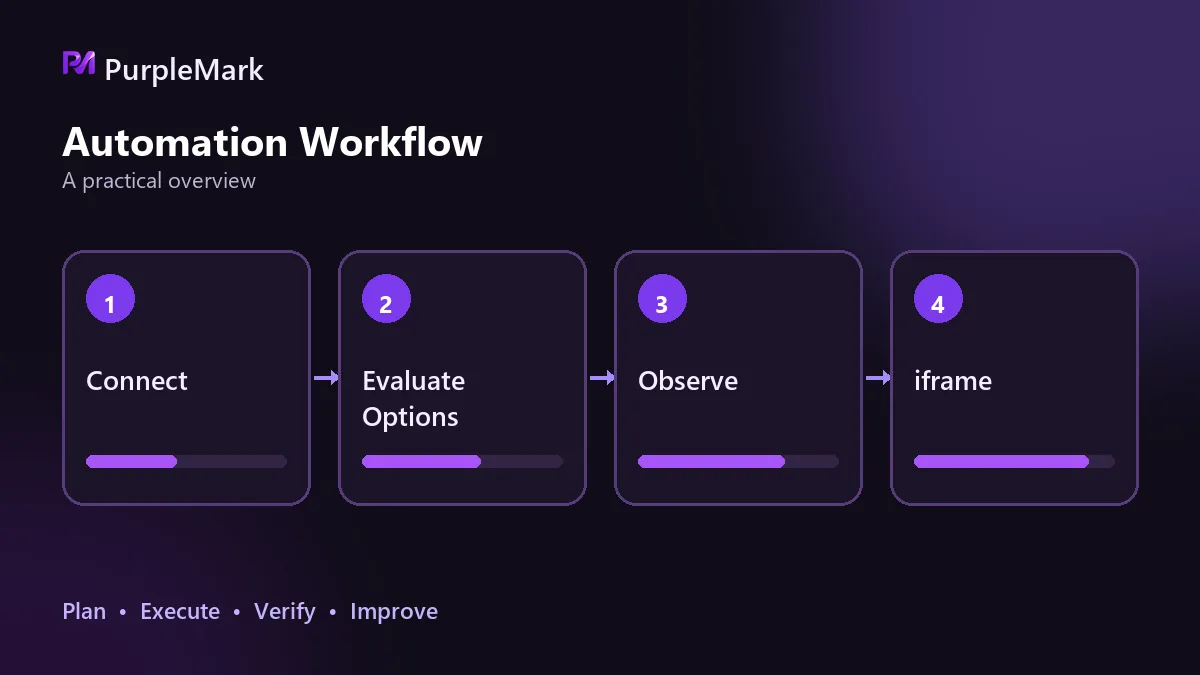
एक एक्शन के चार चरण
- एलिमेंट ढूँढना: target को id, name, class, CSS selector या XPath से पहचानें। semantic attributes को प्राथमिकता दें; मजबूरी में ही structure या index पर जाएँ।
- इंटरैक्टिव होने का इंतज़ार: किसी एलिमेंट का DOM में होना यह नहीं बताता कि उसे क्लिक भी किया जा सकता है। उसके visible या clickable होने, या किसी खास request के लौटने का इंतज़ार करें। इंतज़ार condition का होना चाहिए, seconds का नहीं।
- एक्शन चलाना: क्लिक, टाइप या स्क्रॉल करें। custom components में अक्सर इंसान के क्रम को दोहराना पड़ता है: पहले खोलें, सूची के render होने का इंतज़ार करें, फिर text के आधार पर चुनें।
- नतीजे की जाँच: एक्शन के बाद सत्यापित करें कि परिणाम सही है। देखें कि link बदला या नहीं, पेज का text बदला या नहीं, या API ने क्या लौटाया। यह चरण न हो तो failure को success माना जा सकता है और आगे के retry तथा alerts के पास भरोसेमंद आधार नहीं रहेगा।
इन चार चरणों में दूसरा और चौथा आम तौर पर debugging में सबसे अधिक समय लेते हैं। वजह यह नहीं कि वे कठिन हैं, बल्कि यह है कि वे अक्सर error नहीं देते और चुपचाप गलत परिणाम बना देते हैं।
सेलेक्टर की स्थिरता तय करती है कि स्क्रिप्ट कितने समय चलेगी
पेज बदलते ही hard-coded locator टूट सकते हैं। text, position या index से locator बनाना बदलाव के सामने सबसे कम टिकाऊ है: एक नया button जुड़ने या prompt बदलने भर से सब गड़बड़ा सकता है।
जहाँ संभव हो id, name या data attributes का उपयोग करें। अगर structural locator लेना ही पड़े तो उन्हें एक ही जगह केंद्रित रखें, ताकि बदलाव में दर्जनों lines नहीं बदलनी पड़ें। यह भी न मानें कि स्क्रिप्ट लिखने के बाद रखरखाव की जरूरत नहीं होगी; वेबसाइट अपडेट होना सामान्य है और maintenance cost का बड़ा हिस्सा यहीं आता है।
डायनेमिक लोडिंग: कितना इंतज़ार करना है से ज़्यादा महत्वपूर्ण है किस चीज़ का इंतज़ार करना है
आज बहुत कम पेज ऐसे हैं जिनमें initial load पूरा होते ही सब कुछ तैयार हो जाए। डेटा asynchronous requests से render होता है, इसलिए एलिमेंट अपेक्षा से देर से दिखाई देते हैं।
Fixed wait बहुत सामान्य है और उतना ही आसानी से विफल भी होता है: 3 सेकंड का sleep धीमी machine पर कम पड़ सकता है और तेज machine पर सिर्फ समय बर्बाद करेगा। सही तरीका है किसी condition के सच होने का इंतज़ार करना और एलिमेंट वास्तव में clickable होने पर ही आगे बढ़ना।
एलिमेंट न मिले तो पहले iframe और shadow DOM देखें
अगर एलिमेंट पेज पर साफ़ दिख रहा है लेकिन स्क्रिप्ट उसे नहीं ढूँढ पा रही, तो अक्सर समस्या selector में नहीं बल्कि scope में होती है।
iframe एक अलग document होता है। एलिमेंट खोजने से पहले संबंधित frame में switch करना और काम पूरा होने के बाद वापस बाहर आना जरूरी है, वरना आगे की lookups गलत context में होंगी। shadow DOM के nodes को बाहर से CSS selectors सीधे match नहीं करते; पहले shadow root लें, फिर उसके भीतर खोजें। इन दोनों स्थितियों को अक्सर पेज redesign समझ लिया जाता है और काफी debugging समय बेकार जाता है।
दो और बातें जिन्हें आसानी से छोड़ा जा सकता है
पहली है session। जिन tasks में login चाहिए, उनमें यह तय करें कि authenticated state को कैसे save और reuse किया जाएगा। वरना हर run में फिर से login करना पड़ेगा और verification चरण में अटकने का जोखिम रहेगा।
दूसरी है environment। अगर सभी tasks एक ही browser environment साझा करें तो sessions और cache एक-दूसरे को प्रभावित कर सकते हैं। जो tasks अलग-अलग सही चलते हैं, वे साथ चलने पर बाधा डालने लग सकते हैं। एक task से कई tasks पर जाते समय environment isolation को अलग layer बनाना बहुत परेशानी बचाता है। PurpleMark जैसे tools हर environment के लिए स्वतंत्र fingerprint और स्वतंत्र proxy देते हैं, जबकि automation framework केवल actions चलाने पर केंद्रित रहता है।
शुरू करने से पहले एक सीमा तय कर लें
ऑटोमेशन दोहराए जाने वाले काम को बदल सकता है, लेकिन उन चरणों को नहीं जिनमें वास्तविक व्यक्ति की भागीदारी चाहिए। अगर target workflow में real-time face verification या manual review हो, तो उस workflow को 100% automated नहीं बनाया जा सकता।
इसलिए सबसे सरल तरीके से पहले जाँच लें: पूरा workflow खुद manual तरीके से करें, हर चरण लिखें और देखें कि कहीं ऐसा कदम तो नहीं जिसे पार ही न किया जा सके। उसके बाद ही तय करें कि कितना development effort लगाना है। तकनीकी रूप से संभव होना और नियमों से अनुमत होना भी अलग बातें हैं, इसलिए target platform की terms of service पहले ही देख लें।


