
定位元素、等待可交互、触发动作、校验结果,一个自动化动作就是这四步。把选择器、动态加载、iframe 与影子 DOM 这几个坑认清,脚本才能跑得久。
网页自动化常被理解成让程序替你点按钮。真写起来会发现,一个动作其实是四步,任何一步没做对,表现出来都像没生效。
先说清楚两个容易混的概念。网页自动化范围更宽,用程序完成原本要人在网页上做的事都算,包括直接用请求拿数据。浏览器自动化是其中更具体的一支:程序控制真实浏览器打开页面、执行 JavaScript、模拟点击和输入。动态内容多、交互复杂的场景,基本都得走后一条路。
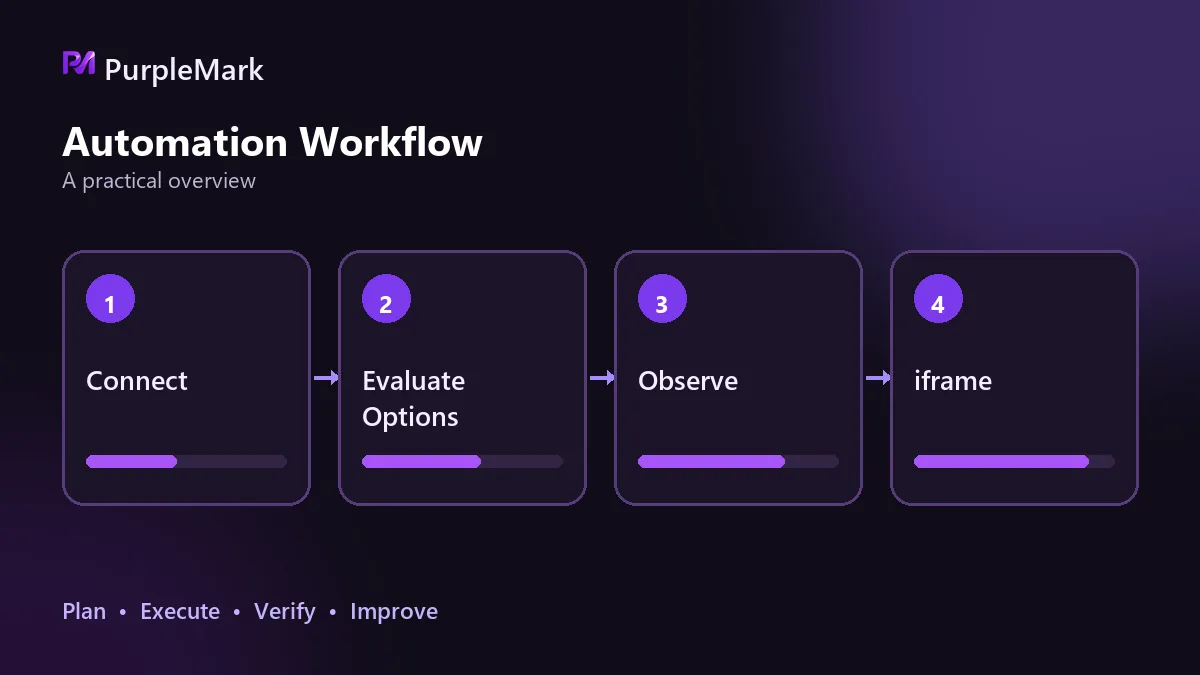
一个动作的四步
- 定位元素:用 id、name、class、CSS 选择器或者 XPath 把目标锁定。优先语义化属性,实在没有才退回结构或索引。
- 等待可交互:元素出现在 DOM 里不等于能点。要等它可见、可点击,或者等某个请求返回。等的是条件,不是秒数。
- 触发动作:点击、输入、滚动。自定义组件往往要复现真人的顺序,先触发展开,等列表渲染,再按文本选中。
- 校验结果:点完要看结果对不对,链接变没变、页面文案变没变、接口返回了什么。少了这一步,失败会被当成成功,后面的重试和告警也就无从下手。
四步里调试时间最长的通常是第二步和第四步,不是因为难,而是因为它们不会报错,只会静默地做出错误的结果。
选择器稳不稳,决定脚本能跑多久
页面一改,写死的定位就失效。用文案、位置、索引去定位,抗变化能力最差,页面加一个按钮、换一句提示词就可能全错。
能用 id、name、data 属性的优先用。拿不到的,把结构定位集中写在一个地方,改的时候只改一处,别散落在几十行代码里。也别指望写完就不用管,网站更新是常态,脚本的维护成本主要就花在这一处。
动态加载:等什么比等多久重要
现在很少有页面是加载完就全部就位的,数据靠异步请求渲染,元素出现得比你以为的晚。
固定等待是最常见的写法,也是最容易翻车的地方:睡 3 秒在慢机器上会失败,在快机器上纯属浪费。正确做法是等某个条件成立,元素真的可点了再动手。
定位不到,先怀疑 iframe 和影子 DOM
元素明明在页面上,脚本就是找不到,这种情况多数不是选择器写错了,而是作用域不对。
iframe 是一份独立文档,得先切进对应的框架里再找元素,操作完还要切出来,否则后续定位会落在错误的上下文里。影子 DOM 里的节点不会被外层的 CSS 选择器直接命中,得先拿到 shadow root,再从它里面查。这两种情况经常被误判成页面改版,白折腾半天。
还有两件容易漏的事
一是会话。需要登录的任务,要考虑登录态怎么保存和复用,否则每跑一次都要重新登一遍,中间还容易卡在验证环节。
二是环境。所有任务共用一个浏览器环境时,会话和缓存会互相污染,本来分开跑都没问题的任务,凑在一起就开始互相干扰。任务从单个变成多个的时候,把环境隔离单独做一层会省很多事,像 PurpleMark 这类工具提供的就是每个环境独立指纹和独立代理这部分能力,自动化框架只管执行动作。
有个边界最好动手前就确认
自动化能替代的是重复操作,不能替代需要真人参与的环节。实时人脸验证、人工审核这类步骤,一旦出现在目标流程里,这条流程就做不到百分之百自动化。
所以先用最笨的办法验证一遍:自己手动走完整个流程,把每一步记下来,确认有没有过不去的环节,再决定投入多少开发。技术可行和规则允许也是两件事,目标平台的服务条款要提前看清楚。


