
Найти элемент, дождаться возможности взаимодействия, выполнить действие и проверить результат — любое действие автоматизации состоит из этих четырёх шагов. Понимание селекторов, динамической загрузки, iframe и shadow DOM помогает скриптам дольше работать стабильно.
Веб-автоматизацию часто понимают как программу, которая нажимает кнопки вместо пользователя. Но при реальной разработке выясняется, что одно действие состоит из четырёх шагов, и ошибка на любом из них может выглядеть так, будто вообще ничего не произошло.
Сначала разделим два понятия, которые легко перепутать. Веб-автоматизация — более широкая область: это выполнение программой действий, которые человек обычно делает на веб-странице, включая прямое получение данных через запросы. Автоматизация браузера — более конкретное направление: программа управляет настоящим браузером, открывает страницы, выполняет JavaScript и имитирует клики и ввод. В сценариях с большим количеством динамического контента или сложными взаимодействиями обычно нужен именно второй путь.
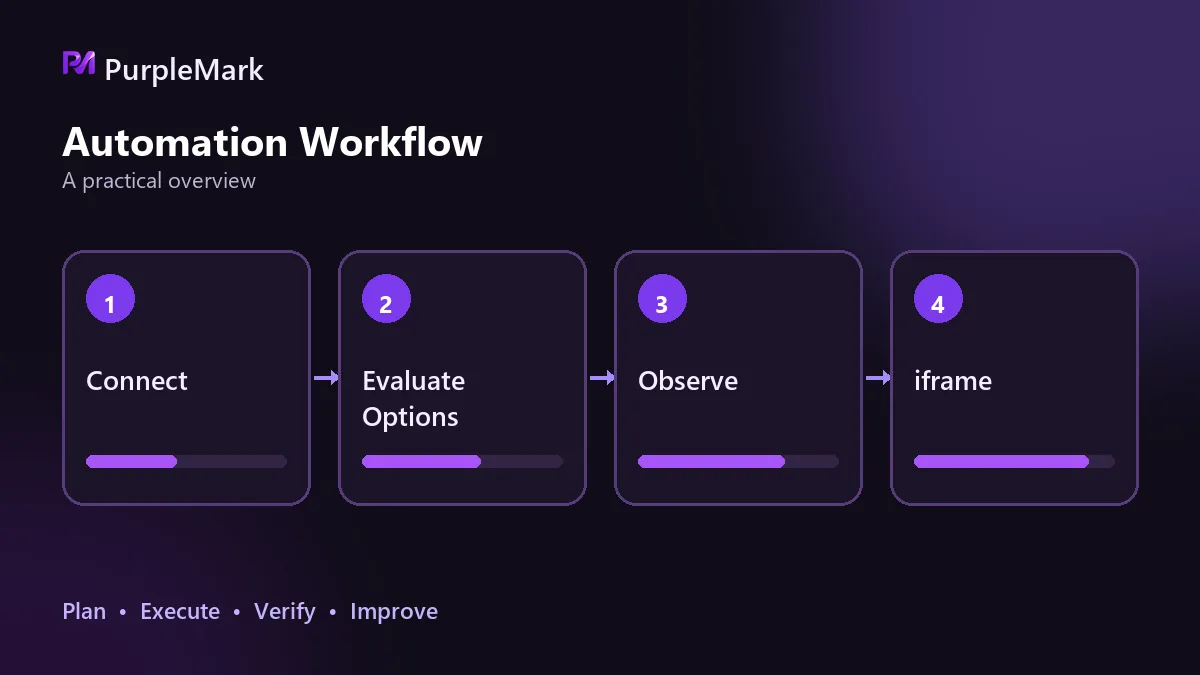
Четыре шага одного действия
- Найти элемент: Определите цель с помощью id, name, class, CSS-селектора или XPath. Предпочитайте семантические атрибуты, а к структуре или индексу переходите только при необходимости.
- Дождаться возможности взаимодействия: Наличие элемента в DOM ещё не означает, что по нему можно нажать. Ждите, пока он станет видимым или кликабельным, либо пока вернётся конкретный запрос. Ждать нужно условие, а не количество секунд.
- Выполнить действие: Клик, ввод или прокрутка. Пользовательские компоненты часто требуют повторить последовательность действий человека: сначала раскрыть элемент, дождаться отрисовки списка, затем выбрать по тексту.
- Проверить результат: После действия убедитесь, что результат верный. Проверьте, изменился ли URL, изменился ли текст страницы и что вернул API. Без этого шага сбой может быть принят за успех, а повторные попытки и оповещения останутся без надёжной основы.
Из четырёх шагов больше всего времени на отладку обычно занимают второй и четвёртый. Не потому, что они сложные, а потому, что часто не вызывают ошибку и просто молча дают неверный результат.
Стабильность селектора определяет срок жизни скрипта
Когда страница меняется, жёстко заданный locator может перестать работать. Поиск по тексту, позиции или индексу хуже всего переносит изменения: добавление одной кнопки или изменение одной подсказки может сломать всё.
Если возможно, используйте id, name или data-атрибуты. Если без структурных locator не обойтись, держите их в одном месте, чтобы при изменении исправлять один участок, а не десятки строк. Не стоит ожидать и того, что после написания скрипт больше не потребует обслуживания: сайты регулярно обновляются, и значительная часть затрат на поддержку приходится именно сюда.
Динамическая загрузка: важнее, чего ждать, а не сколько
Сегодня мало страниц, где всё готово сразу после завершения первоначальной загрузки. Данные отрисовываются через асинхронные запросы, поэтому элементы появляются позже, чем ожидается.
Фиксированное ожидание — распространённый, но ненадёжный подход: sleep на 3 секунды может оказаться слишком коротким на медленной машине и просто потратить время на быстрой. Правильнее ждать выполнения конкретного условия и действовать только тогда, когда элемент действительно стал кликабельным.
Если элемент не находится, сначала проверьте iframe и shadow DOM
Когда элемент явно виден на странице, но скрипт его не находит, проблема часто не в селекторе, а в области поиска.
iframe — это отдельный документ. Сначала нужно переключиться в нужный frame и уже там искать элемент, а после операции выйти обратно, иначе последующие поиски будут выполняться в неправильном контексте. Узлы внутри shadow DOM не находятся напрямую CSS-селекторами снаружи. Сначала нужно получить shadow root, а затем искать внутри него. Эти две ситуации часто ошибочно принимают за изменение страницы и зря тратят время на отладку.
Ещё две вещи, которые легко упустить
Первая — сессия. Для задач, требующих входа, нужно продумать, как сохранять и повторно использовать авторизованное состояние. Иначе при каждом запуске придётся входить заново, а процесс может застрять на этапе проверки.
Вторая — окружение. Если все задачи используют одно и то же браузерное окружение, сессии и кеши могут влиять друг на друга. Задачи, которые по отдельности работают нормально, при совместном запуске могут начать конфликтовать. Когда задач становится несколько, отдельный слой изоляции окружений помогает избежать многих проблем. Инструменты вроде PurpleMark предоставляют независимый fingerprint и независимый proxy для каждого окружения, а фреймворк автоматизации сосредоточен только на выполнении действий.
Одну границу лучше проверить до начала
Автоматизация может заменить повторяющиеся операции, но не этапы, где требуется участие реального человека. Если в целевом процессе есть проверка лица в реальном времени или ручная проверка, такой процесс нельзя автоматизировать на 100%.
Поэтому сначала проверьте всё самым простым способом: вручную пройдите процесс от начала до конца, запишите каждый шаг и убедитесь, нет ли этапа, который невозможно пройти. Только после этого решайте, сколько усилий разработки стоит вкладывать. Техническая возможность и разрешение по правилам — тоже разные вопросы, поэтому заранее изучите условия использования целевой платформы.


