
Localizarea elementului, așteptarea până devine interactiv, declanșarea acțiunii și verificarea rezultatului: orice acțiune de automatizare urmează acești patru pași. Înțelegerea selectorilor, încărcării dinamice, iframe-urilor și shadow DOM ajută scripturile să rămână fiabile mai mult timp.
Automatizarea web este adesea înțeleasă ca un program care apasă butoane în locul tău. În practică însă, descoperi că o acțiune are patru pași, iar dacă unul singur este greșit, poate părea că nu s-a întâmplat nimic.
Mai întâi, să separăm două concepte care se confundă ușor. Automatizarea web este categoria mai largă: include folosirea unui program pentru a face ceea ce în mod normal ar face o persoană pe o pagină web, inclusiv obținerea directă a datelor prin request-uri. Automatizarea browserului este o ramură mai specifică: programul controlează un browser real pentru a deschide pagini, a executa JavaScript și a simula clicuri și introducerea de text. În scenarii cu mult conținut dinamic sau interacțiuni complexe, de regulă este necesară această a doua abordare.
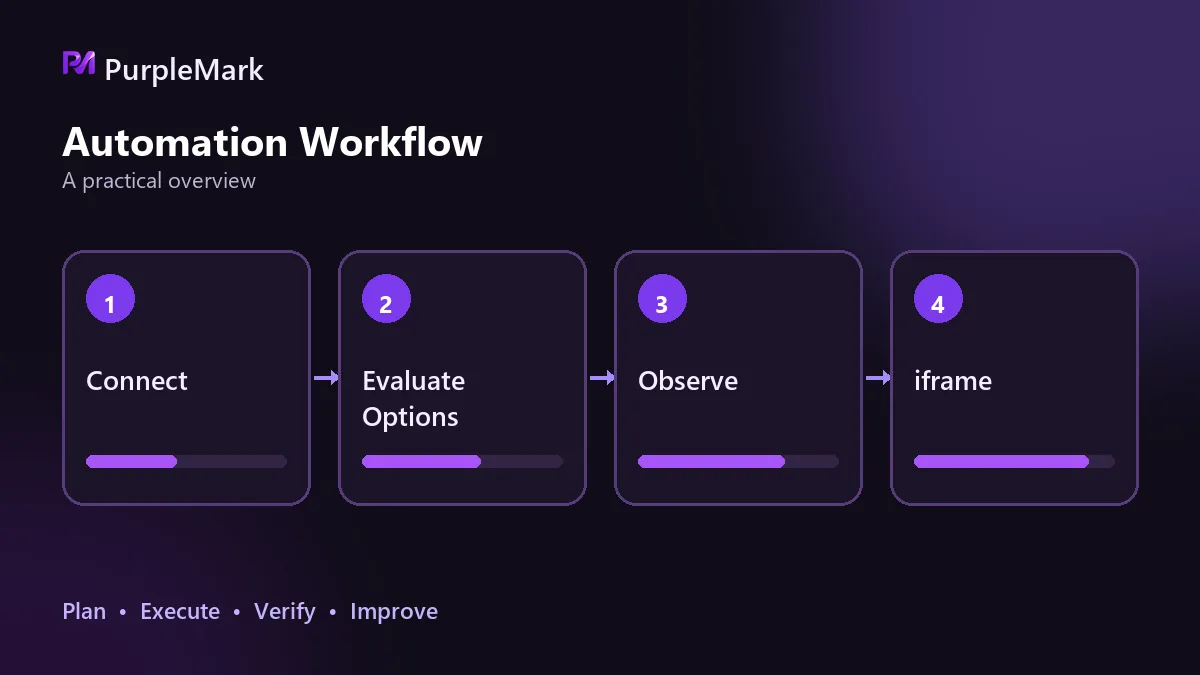
Cei patru pași ai unei acțiuni
- Localizează elementul: Identifică ținta cu id, name, class, selector CSS sau XPath. Preferă atributele semantice și revino la structură sau index doar când nu există o variantă mai bună.
- Așteaptă până devine interactiv: Faptul că un element există în DOM nu înseamnă că poate fi apăsat. Așteaptă să fie vizibil sau clicabil ori să revină un request anume. Se așteaptă o condiție, nu un număr de secunde.
- Declanșează acțiunea: Clic, introducere de text sau scroll. Componentele personalizate cer adesea reproducerea ordinii în care ar opera un om: deschizi mai întâi, aștepți randarea listei, apoi selectezi după text.
- Verifică rezultatul: După acțiune, confirmă că rezultatul este corect. Verifică dacă s-a schimbat linkul, textul paginii sau ce a returnat API-ul. Fără acest pas, un eșec poate fi considerat succes, iar reîncercările și alertele ulterioare rămân fără o bază sigură.
Dintre cei patru pași, al doilea și al patrulea consumă de obicei cel mai mult timp de depanare. Nu pentru că sunt dificili, ci pentru că adesea nu generează erori și produc în tăcere un rezultat greșit.
Stabilitatea selectorului decide cât rezistă scriptul
Când pagina se schimbă, un locator scris rigid poate înceta să funcționeze. Localizarea după text, poziție sau index rezistă cel mai slab la modificări: un singur buton adăugat sau un mesaj schimbat poate deregla totul.
Folosește cu prioritate atribute id, name sau data când sunt disponibile. Dacă ai nevoie de locatori structurali, păstrează-i centralizați într-un singur loc, astfel încât o schimbare să se facă o singură dată, nu în zeci de linii. Nici nu presupune că după ce ai scris scriptul nu va mai necesita întreținere; site-urile se actualizează frecvent, iar o mare parte din costul de mentenanță se concentrează aici.
Încărcare dinamică: ce aștepți este mai important decât cât aștepți
Astăzi sunt puține pagini în care totul este gata imediat după încărcarea inițială. Datele sunt randate prin request-uri asincrone, astfel că elementele apar mai târziu decât te-ai aștepta.
Așteptările fixe sunt comune, dar și fragile: un sleep de 3 secunde poate fi insuficient pe o mașină lentă și doar pierde timp pe una rapidă. Abordarea corectă este să aștepți îndeplinirea unei condiții și să acționezi numai când elementul este cu adevărat clicabil.
Dacă nu găsești elementul, verifică mai întâi iframe și shadow DOM
Când elementul este vizibil pe pagină, dar scriptul nu îl găsește, problema este adesea nu selectorul, ci domeniul de căutare.
Un iframe este un document separat. Trebuie să comuți mai întâi în frame-ul corespunzător pentru a căuta elementul și să revii după operație; altfel, căutările următoare vor avea loc în contextul greșit. Nodurile dintr-un shadow DOM nu sunt găsite direct de selectoarele CSS din exterior. Mai întâi obții shadow root, apoi cauți în interiorul lui. Aceste două situații sunt confundate frecvent cu o reproiectare a paginii și pot irosi mult timp de depanare.
Încă două lucruri ușor de omis
Primul este sesiunea. Pentru sarcinile care cer autentificare, trebuie să te gândești cum salvezi și reutilizezi starea autentificată. Altfel, la fiecare rulare trebuie să te autentifici din nou și poți rămâne blocat la un pas de verificare.
Al doilea este mediul. Dacă toate sarcinile împart același mediu de browser, sesiunile și cache-urile se pot contamina reciproc. Sarcini care funcționează bine separat pot începe să interfereze când rulează împreună. Când treci de la o singură sarcină la mai multe, separarea izolării mediilor într-un strat dedicat economisește multe probleme. Instrumente precum PurpleMark oferă un fingerprint independent și un proxy independent pentru fiecare mediu, iar framework-ul de automatizare se ocupă doar de executarea acțiunilor.
Confirmă o limită înainte să începi
Automatizarea poate înlocui operațiuni repetitive, dar nu pași care necesită participarea unei persoane reale. Dacă fluxul țintă include verificare facială în timp real sau examinare manuală, acel flux nu poate fi automatizat 100%.
De aceea, verifică mai întâi prin cea mai simplă metodă: parcurge manual întregul flux, notează fiecare pas și confirmă dacă există vreo etapă imposibil de trecut. Abia apoi decide cât efort de dezvoltare merită investit. Fezabilitatea tehnică și ceea ce permit regulile sunt, de asemenea, două chestiuni diferite, așa că verifică din timp termenii de utilizare ai platformei țintă.


