
定位元素、等待可互動、觸發動作、驗證結果,一個自動化動作就是這四步。先弄清楚選擇器、動態載入、iframe 與影子 DOM 這幾個常見陷阱,腳本才能穩定跑得更久。
網頁自動化常被理解成讓程式替你點按鈕。真正寫起來才會發現,一個動作其實有四個步驟,只要其中一步沒做對,表現出來都可能像是沒有生效。
先說清楚兩個容易混淆的概念。網頁自動化的範圍更廣,只要是用程式完成原本需要人在網頁上做的事都算,包括直接透過 request 取得資料。瀏覽器自動化則是其中更具體的一支:程式控制真正的瀏覽器開啟頁面、執行 JavaScript、模擬點擊與輸入。動態內容多、互動複雜的情境,基本上都得採用後者。
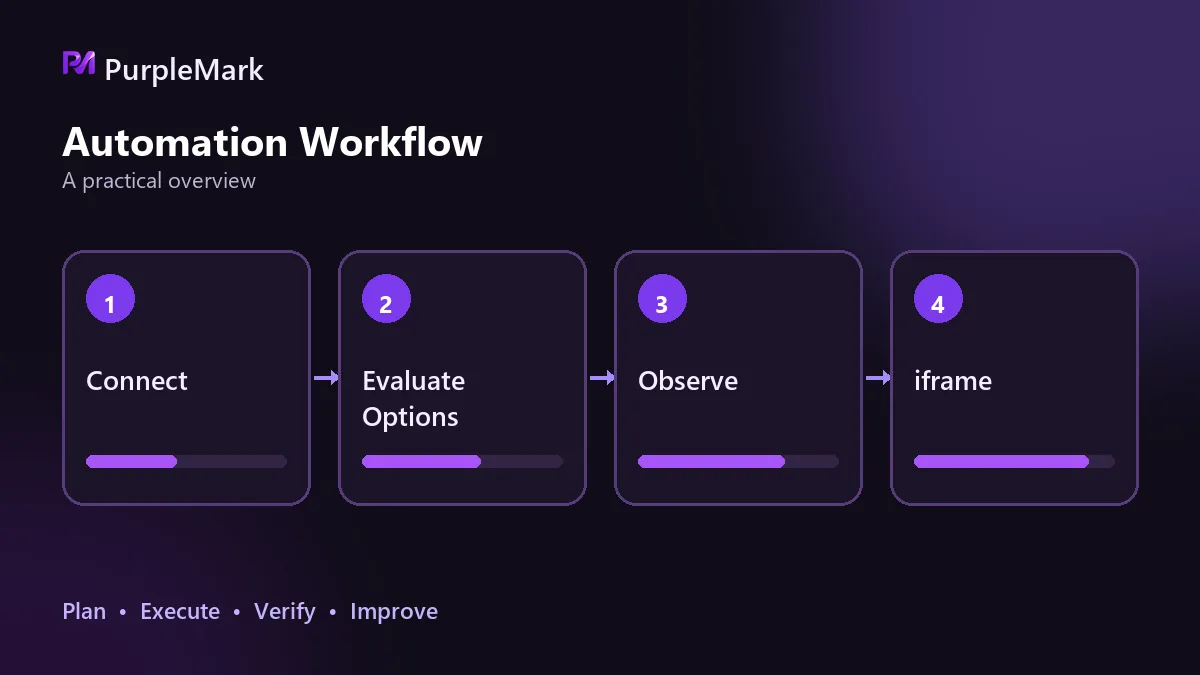
一個動作的四個步驟
- 定位元素:用 id、name、class、CSS 選擇器或 XPath 鎖定目標。優先使用語意化屬性,真的沒有時再退回結構或索引。
- 等待可互動:元素出現在 DOM 裡不代表就能點。要等它可見、可點擊,或等待某個 request 回傳。要等的是條件,不是秒數。
- 觸發動作:點擊、輸入、捲動。自訂元件往往要重現真人操作的順序,先觸發展開,等待清單 render,再依文字選取。
- 驗證結果:點完之後要確認結果對不對,連結有沒有變、頁面文案有沒有變、API 回傳了什麼。少了這一步,失敗可能會被當成成功,後面的 retry 和警示也就沒有可靠依據。
四個步驟裡,除錯時間最長的通常是第二步和第四步。不是因為它們特別難,而是因為它們常常不會報錯,只會悄悄產生錯誤結果。
選擇器穩不穩,決定腳本能跑多久
頁面一改,寫死的 locator 就可能失效。用文案、位置或索引定位,抗變化能力最差;頁面多一個按鈕、換一句提示文字,就可能整個錯位。
能用 id、name、data 屬性的話優先使用。拿不到時,就把結構定位集中寫在同一個地方,修改時只改一處,不要散落在幾十行程式碼裡。也別期待寫完就不用再管,網站更新是常態,腳本的維護成本有很大一部分就花在這裡。
動態載入:等什麼比等多久更重要
現在很少有頁面在載入完成後就全部就緒,資料會透過非同步 request render,元素出現得往往比預期更晚。
固定等待是最常見的寫法,也是最容易出問題的地方:sleep 3 秒在慢機器上可能不夠,在快機器上又只是浪費時間。正確做法是等待某個條件成立,等元素真的可點擊了再動作。
定位不到,先懷疑 iframe 和影子 DOM
元素明明就在頁面上,腳本卻找不到,這種情況多半不是選擇器寫錯,而是作用域不對。
iframe 是一份獨立文件,得先切進對應的 frame 再找元素,操作完還要切回來,否則後續定位會落在錯誤的 context 裡。影子 DOM 裡的節點不會被外層 CSS 選擇器直接命中,得先取得 shadow root,再從裡面查找。這兩種情況常被誤判成頁面改版,白白浪費除錯時間。
還有兩件容易漏掉的事
第一是 session。需要登入的任務,要考慮登入狀態怎麼保存和重複使用,否則每次執行都得重新登入,中間還可能卡在驗證步驟。
第二是 environment。所有任務共用同一個瀏覽器環境時,session 和 cache 會互相污染。原本分開跑都沒問題的任務,放在一起就可能開始互相干擾。任務從單個變成多個時,把環境隔離獨立做成一層會省下很多麻煩。像 PurpleMark 這類工具提供的就是每個環境獨立 fingerprint 和獨立 proxy 的能力,自動化 framework 只需要負責執行動作。
有個界線最好在動手前先確認
自動化能替代的是重複操作,不能替代需要真人參與的步驟。即時人臉驗證、人工審核這類環節一旦出現在目標流程裡,這條流程就無法做到 100% 自動化。
所以先用最簡單的方法驗證一次:自己手動完整走過整個流程,把每一步記下來,確認有沒有過不去的環節,再決定投入多少開發成本。技術可行和規則允許也是兩回事,目標平台的服務條款要提前看清楚。


