
Element zoeken, wachten tot het interactief is, de actie uitvoeren en het resultaat controleren: elke automatiseringsactie bestaat uit deze vier stappen. Begrip van selectors, dynamisch laden, iframes en shadow DOM helpt scripts langer betrouwbaar te blijven.
Webautomatisering wordt vaak gezien als een programma dat namens jou op knoppen klikt. Zodra je het echt bouwt, blijkt echter dat één actie uit vier stappen bestaat en dat een fout in één stap al kan lijken alsof er helemaal niets is gebeurd.
Eerst twee begrippen die gemakkelijk door elkaar worden gehaald. Webautomatisering is het bredere begrip: een programma taken laten uitvoeren die iemand normaal op een webpagina zou doen, inclusief het rechtstreeks ophalen van gegevens via requests. Browserautomatisering is een specifiekere tak: een programma bestuurt een echte browser om pagina's te openen, JavaScript uit te voeren en klikken en invoer na te bootsen. Bij veel dynamische inhoud of complexe interacties is meestal deze tweede aanpak nodig.
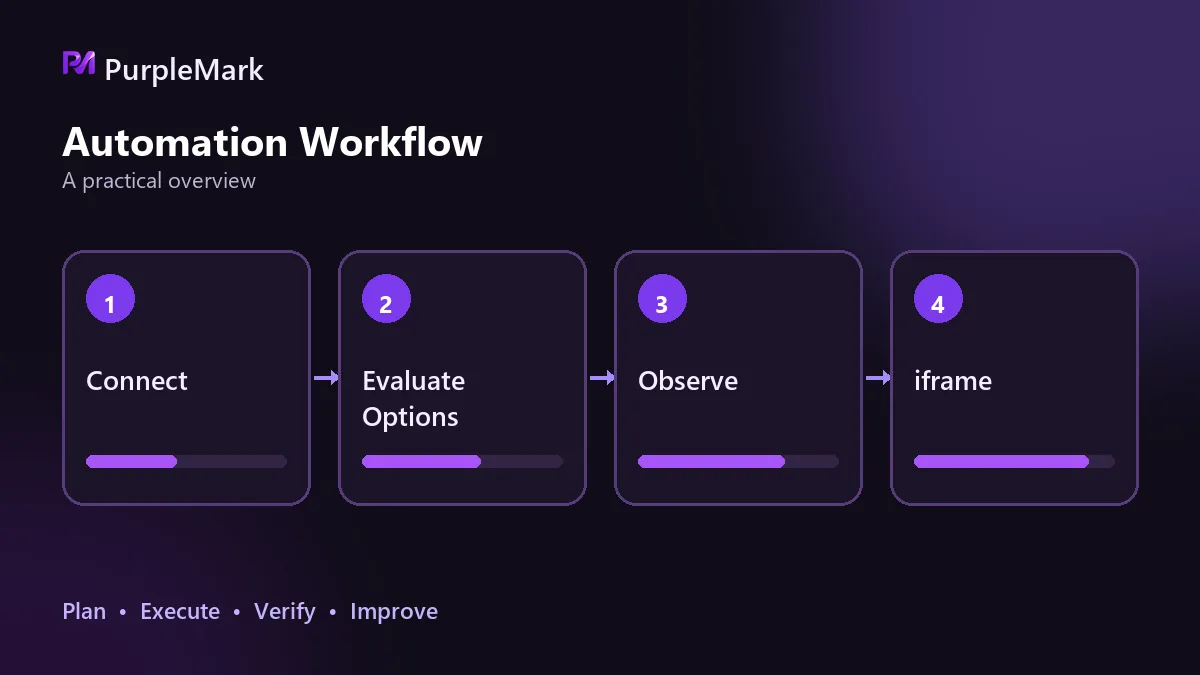
De vier stappen van één actie
- Element zoeken: Bepaal het doel met id, name, class, een CSS-selector of XPath. Geef de voorkeur aan semantische attributen en val alleen terug op structuur of index als het echt nodig is.
- Wachten tot het interactief is: Dat een element in de DOM staat, betekent niet dat je erop kunt klikken. Wacht tot het zichtbaar of klikbaar is, of tot een specifieke request is teruggekomen. Wacht op een voorwaarde, niet op een aantal seconden.
- Actie uitvoeren: Klikken, typen of scrollen. Aangepaste componenten vereisen vaak dezelfde volgorde als bij een mens: eerst openen, wachten tot de lijst is gerenderd en daarna op tekst selecteren.
- Resultaat controleren: Controleer na de actie of het resultaat klopt. Kijk of een link is veranderd, of de paginaverwoording is gewijzigd of wat de API heeft teruggegeven. Zonder deze stap kan een mislukking als succes worden gezien en ontbreekt een betrouwbare basis voor retries en waarschuwingen.
Van deze vier stappen kosten de tweede en vierde meestal de meeste debugtijd. Niet omdat ze moeilijk zijn, maar omdat ze vaak geen foutmelding geven en stilletjes een verkeerd resultaat opleveren.
De stabiliteit van de selector bepaalt hoe lang een script meegaat
Zodra een pagina verandert, kan een hardgecodeerde locator breken. Zoeken op tekst, positie of index is het minst bestand tegen veranderingen: één extra knop of een gewijzigde melding kan alles verschuiven.
Gebruik waar mogelijk id-, name- of data-attributen. Als structurele locators nodig zijn, centraliseer ze dan op één plek zodat een wijziging niet over tientallen regels hoeft te worden doorgevoerd. Verwacht ook niet dat een script na oplevering geen onderhoud meer nodig heeft; websites veranderen voortdurend en een groot deel van de onderhoudskosten zit juist hier.
Dynamisch laden: wat je afwacht is belangrijker dan hoe lang
Er zijn tegenwoordig maar weinig pagina's waarop alles klaarstaat zodra de eerste laadfase is afgerond. Gegevens worden via asynchrone requests gerenderd, waardoor elementen later verschijnen dan je verwacht.
Vaste wachttijden zijn gebruikelijk, maar ook foutgevoelig: 3 seconden slapen kan op een trage machine te kort zijn en op een snelle machine alleen tijd verspillen. De juiste aanpak is wachten tot een bepaalde voorwaarde waar is en pas handelen wanneer het element werkelijk klikbaar is.
Kun je een element niet vinden, controleer dan eerst iframe en shadow DOM
Als een element duidelijk op de pagina staat maar het script het niet kan vinden, ligt het probleem vaak niet aan de selector maar aan de scope.
Een iframe is een afzonderlijk document. Je moet eerst naar het juiste frame schakelen om elementen te zoeken en daarna weer terugschakelen; anders vinden latere zoekacties plaats in de verkeerde context. Nodes in een shadow DOM worden niet direct geraakt door CSS-selectors van buitenaf. Haal eerst de shadow root op en zoek vervolgens daarbinnen. Deze twee situaties worden vaak ten onrechte aangezien voor een wijziging van de pagina en kosten dan onnodig veel debugtijd.
Nog twee dingen die gemakkelijk worden vergeten
Het eerste is de sessie. Voor taken waarvoor een login nodig is, moet je bepalen hoe de ingelogde status wordt opgeslagen en hergebruikt. Anders moet je bij iedere run opnieuw inloggen en kun je vastlopen bij een verificatiestap.
Het tweede is de omgeving. Als alle taken dezelfde browseromgeving delen, kunnen sessies en caches elkaar vervuilen. Taken die afzonderlijk prima werken, kunnen elkaar gaan hinderen wanneer ze samen draaien. Zodra je van één taak naar meerdere gaat, kan een aparte laag voor omgevingsisolatie veel problemen voorkomen. Tools zoals PurpleMark bieden een afzonderlijke fingerprint en proxy per omgeving, terwijl het automatiseringsframework zich alleen met de acties bezighoudt.
Bevestig één grens voordat je begint
Automatisering kan repetitieve handelingen vervangen, maar geen stappen waarvoor een echte persoon nodig is. Als de doelworkflow realtime gezichtsverificatie of handmatige beoordeling bevat, kan die workflow niet voor 100% worden geautomatiseerd.
Controleer daarom eerst op de eenvoudigste manier: doorloop het volledige proces handmatig, noteer elke stap en kijk of er een onderdeel is waar je niet doorheen komt. Beslis pas daarna hoeveel ontwikkelwerk je wilt investeren. Technische haalbaarheid en wat volgens de regels is toegestaan zijn bovendien twee verschillende zaken, dus controleer vooraf de servicevoorwaarden van het doelplatform.


